初值问题
给定一个物体的起始位置,以及决定它怎样运动的规则,怎样算出它在下一时刻的位置?先从一个粒子开始,之后再把方法用于许多粒子、刚体和流体。
若速度始终不变,问题很直接。设起始位置为 x 0 \mathbf x_0 x 0 v \mathbf v v T T T x 0 + T v \mathbf x_0+T\mathbf v x 0 + T v
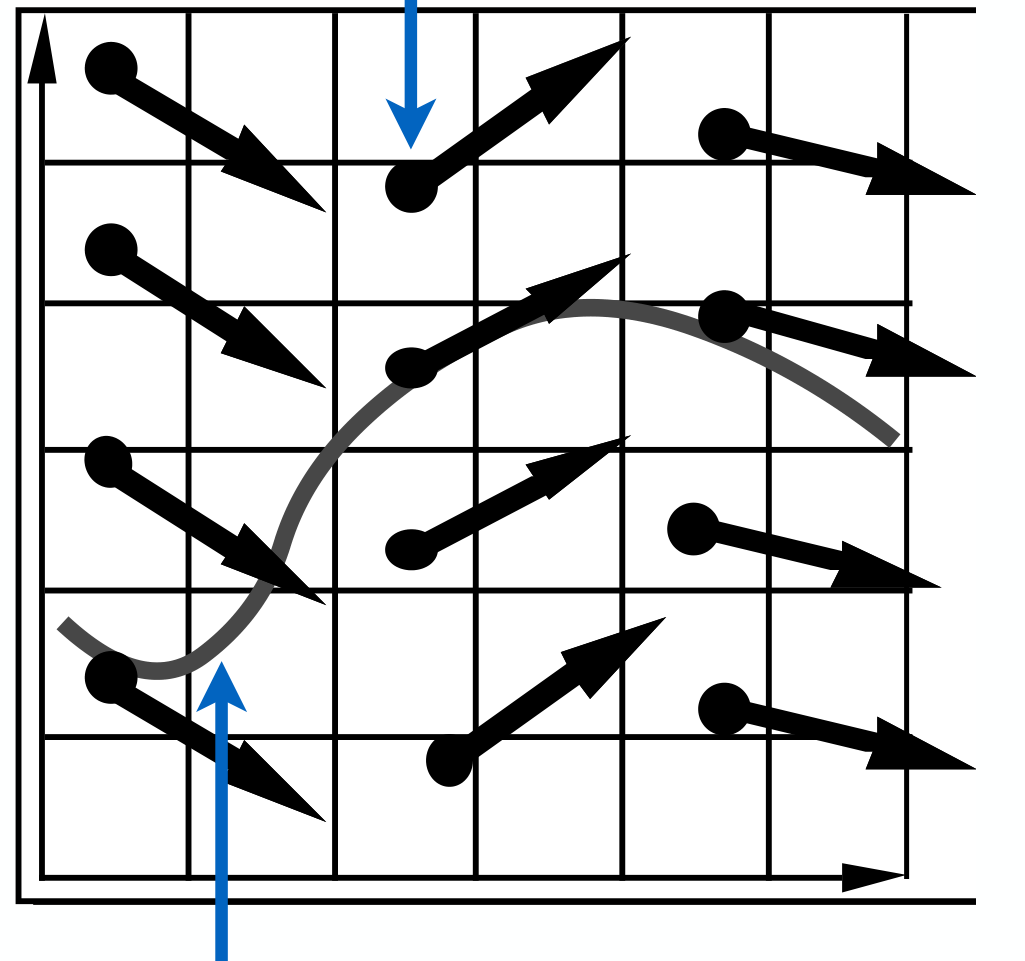
先考虑一种便于理解的理想情况:空间中每个位置、每个时刻的速度都已经给定,记为 v ( x , t ) \mathbf v(\mathbf x,t) v ( x , t ) 速度场 Velocity Field 。它表示一个随流运动的粒子如果在时刻 t t t x \mathbf x x
黑色箭头给出若干位置的局部速度,灰色曲线表示粒子随速度场运动的轨迹,蓝色箭头分别指向速度采样点和轨迹。理解这张图时,要看粒子沿途所在位置的速度:当前位置的速度决定此刻的切线方向,走到新位置后需要重新查询,方向便可能继续变化。轨迹由这些连续变化的速度决定,无须经过图中所有黑色采样点。
速度是位置对时间的导数,因此要求解
d x d t = x ˙ = v ( x , t ) , x ( t 0 ) = x 0 . \frac{\mathrm d\mathbf x}{\mathrm dt}
=\dot{\mathbf x}=\mathbf v(\mathbf x,t),
\qquad \mathbf x(t_0)=\mathbf x_0.
d t d x = x ˙ = v ( x , t ) , x ( t 0 ) = x 0 .
x ˙ \dot{\mathbf x} x ˙ x ¨ \ddot{\mathbf x} x ¨ 常微分方程 Ordinary Differential Equation,ODE :未知的是随时间变化的位置函数 x ( t ) \mathbf x(t) x ( t ) 偏微分方程 Partial Differential Equation,PDE 。
给定 x 0 \mathbf x_0 x 0 初值问题 Initial Value Problem 。目标是从这个初始状态出发,得到后续时刻的状态。
精确位移满足
x ( t + h ) − x ( t ) = ∫ t t + h v ( x ( τ ) , τ ) d τ . \mathbf x(t+h)-\mathbf x(t)
=\int_t^{t+h}\mathbf v(\mathbf x(\tau),\tau)\,\mathrm d\tau.
x ( t + h ) − x ( t ) = ∫ t t + h v ( x ( τ ) , τ ) d τ .
这里要沿尚未求出的真实轨迹查询速度,通常没有可以直接套用的解析式。数值积分 Numerical Integration 将时间分成小段,一步一步近似这段积分。把每一步的长度记为 h = Δ t h=\Delta t h = Δ t 时间步长 Time Step ;从 t n t_n t n t n + 1 = t n + h t_{n+1}=t_n+h t n + 1 = t n + h x n \mathbf x_n x n x n + 1 \mathbf x_{n+1} x n + 1
实际受力的粒子还需要记录速度。由弹簧动力学 得到 x ¨ = a ( x , v , t ) \ddot{\mathbf x}=\mathbf a(\mathbf x,\mathbf v,t) x ¨ = a ( x , v , t ) 状态 State :
y = ( x v ) , y ˙ = f ( y , t ) = ( v a ( x , v , t ) ) . \mathbf y=\begin{pmatrix}\mathbf x\\\mathbf v\end{pmatrix},
\qquad
\dot{\mathbf y}
=\mathbf f(\mathbf y,t)
=\begin{pmatrix}\mathbf v\\\mathbf a(\mathbf x,\mathbf v,t)\end{pmatrix}.
y = ( x v ) , y ˙ = f ( y , t ) = ( v a ( x , v , t ) ) .
这样,二阶位置方程变成一阶状态方程,初始状态包含初始位置和初始速度。下文写 x \mathbf x x y \mathbf y y
显式欧拉
最简单的做法,是先查询当前速度,假设它在接下来的小段时间内保持不变,沿这个方向走一步;到达新位置后再查询一次速度。显式欧拉 Explicit Euler ,也称 Forward Euler ,就是这一过程:
x n + 1 = x n + h v ( x n , t n ) . \mathbf x_{n+1}
=\mathbf x_n+h\mathbf v(\mathbf x_n,t_n).
x n + 1 = x n + h v ( x n , t n ) .
比如 h = 0.01 s h=0.01\,\mathrm s h = 0.01 s 2 m / s 2\,\mathrm{m/s} 2 m/s 0.02 m 0.02\,\mathrm m 0.02 m
对于同时记录位置和速度的粒子,先求当前加速度 a n = a ( x n , v n , t n ) \mathbf a_n=\mathbf a(\mathbf x_n,\mathbf v_n,t_n) a n = a ( x n , v n , t n )
x n + 1 = x n + h v n , v n + 1 = v n + h a n . \mathbf x_{n+1}=\mathbf x_n+h\mathbf v_n,
\qquad
\mathbf v_{n+1}=\mathbf v_n+h\mathbf a_n.
x n + 1 = x n + h v n , v n + 1 = v n + h a n .
两式右侧都只用第 n n n
1
2
3
4
5
保存当前的位置 x_old 和速度 v_old 用当前状态计算加速度 a_old x_new = x_old + h * v_old v_new = v_old + h * a_old 将状态更新为 (x_new, v_new)
也可以有意先更新速度,再用新速度推进位置:
v n + 1 = v n + h a n , x n + 1 = x n + h v n + 1 . \mathbf v_{n+1}=\mathbf v_n+h\mathbf a_n,
\qquad
\mathbf x_{n+1}=\mathbf x_n+h\mathbf v_{n+1}.
v n + 1 = v n + h a n , x n + 1 = x n + h v n + 1 .
这称为半隐式欧拉 Semi-Implicit Euler ,在保守力系统中也常称 Symplectic Euler 。它只改变了一个速度下标,长期运动表现却会不同。它仍可直接计算,不需要求解未知终点参与的方程;与后面介绍的隐式欧拉应当区分。
用统一状态表示,显式欧拉写为
y n + 1 = y n + h f ( y n , t n ) . \mathbf y_{n+1}=\mathbf y_n+h\mathbf f(\mathbf y_n,t_n).
y n + 1 = y n + h f ( y n , t n ) .
这种写法说明:只要能够从当前状态计算变化率,就能用同一更新形式处理位置、速度,或更大的状态向量。它的局限也在于此——整个时间步都使用起点的一次导数查询,没有再检查途中发生的变化。
稳定性
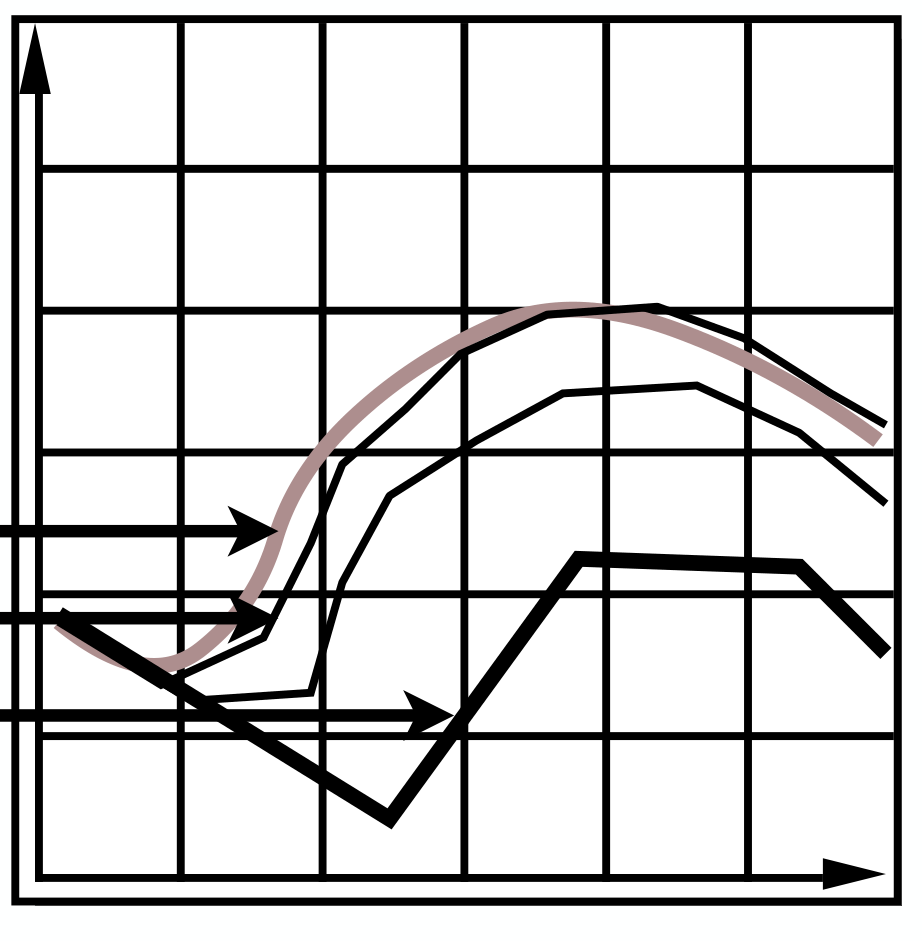
先看时间步长带来的误差。粒子的真实路径会随着速度变化而弯曲,显式欧拉却沿起点切线走完整步。时间步越大,略过的变化越多;把同一段时间拆成更多小步,就能更频繁地修正方向。
图中灰褐色平滑曲线是真实路线,黑色折线是数值近似。较小步长的细折线能较频繁地调整方向,较大步长的粗折线则明显偏离;从左侧伸入的箭头只是原图对三类曲线的指示线。每一步的偏差还会带入下一步,因此模拟时间越长,累积误差越值得关注。
图形学应用可以接受一定的轨迹偏差,但还要避免另一种情况:物理系统本来保持有界,数值结果却越来越大,最终远离应有运动。这种持续放大偏差的现象是数值不稳定 Numerical Instability ;对应的增长称为发散 Divergence 。精度关注近似是否接近真实解,稳定性 Stability 则关注离散更新是否会不合理地放大扰动。
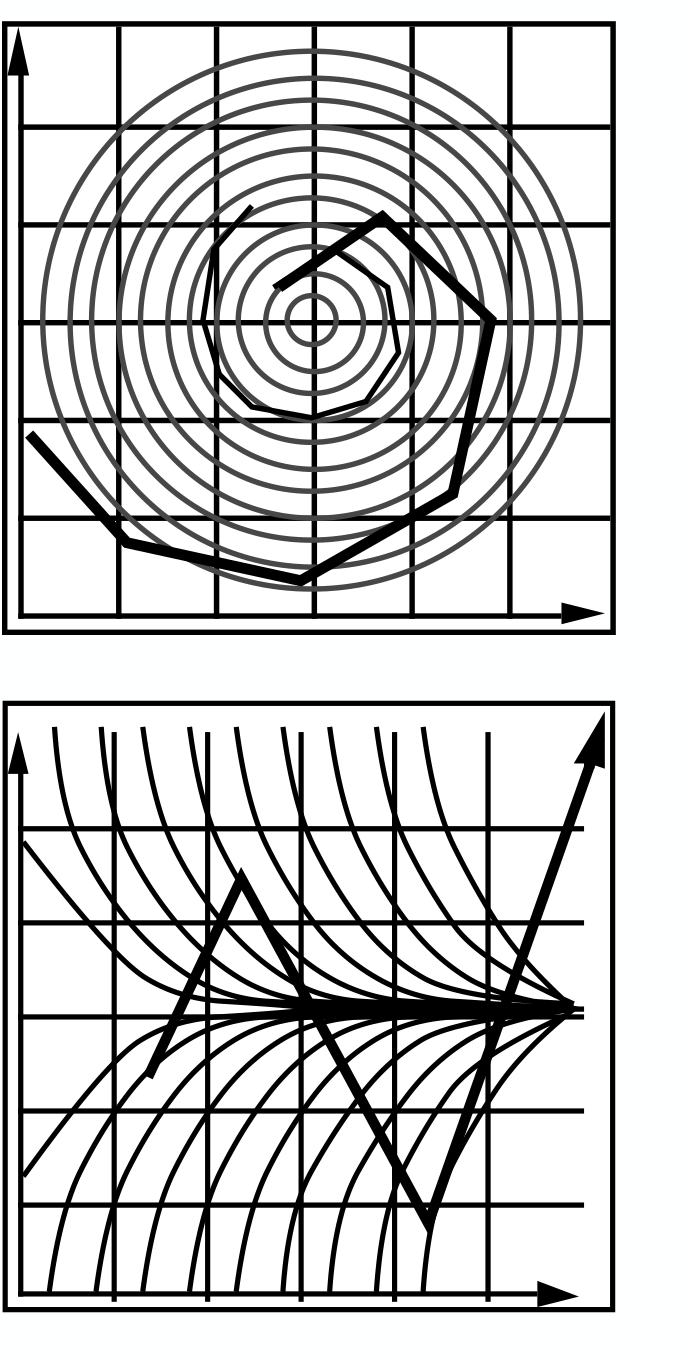
上图的速度始终沿圆的切线,真实粒子应保持到圆心的距离。显式欧拉沿切线走出一段直线后,终点已经在原圆外;下一步又沿新位置的切线向外走,黑色折线便逐步远离圆心。
这个现象可以直接用几何计算。把圆心移到原点,设 x n ⋅ v n = 0 \mathbf x_n\cdot\mathbf v_n=0 x n ⋅ v n = 0
∥ x n + 1 ∥ 2 = ∥ x n + h v n ∥ 2 = ∥ x n ∥ 2 + h 2 ∥ v n ∥ 2 . \|\mathbf x_{n+1}\|^2
=\|\mathbf x_n+h\mathbf v_n\|^2
=\|\mathbf x_n\|^2+h^2\|\mathbf v_n\|^2.
∥ x n + 1 ∥ 2 = ∥ x n + h v n ∥ 2 = ∥ x n ∥ 2 + h 2 ∥ v n ∥ 2 .
只要速度非零、步长非零,半径平方就增加。若速度场是匀角速旋转,∥ v n ∥ = ω ∥ x n ∥ \|\mathbf v_n\|=\omega\|\mathbf x_n\| ∥ v n ∥ = ω ∥ x n ∥
r n + 1 2 = ( 1 + h 2 ω 2 ) r n 2 , r N 2 = ( 1 + h 2 ω 2 ) N r 0 2 . r_{n+1}^2=(1+h^2\omega^2)r_n^2,
\qquad
r_N^2=(1+h^2\omega^2)^N r_0^2.
r n + 1 2 = ( 1 + h 2 ω 2 ) r n 2 , r N 2 = ( 1 + h 2 ω 2 ) N r 0 2 .
对任何固定 h > 0 h>0 h > 0 h h h
下图展示另一个问题:真实运动应逐渐靠近中间的水平位置,数值步却跨过它,上下交替,而且越跳越远。用一个简化的一维恢复规律就能说明原因:
y ˙ = − α y , α > 0. \dot y=-\alpha y,\qquad \alpha>0.
y ˙ = − α y , α > 0.
真实解 y ( t ) = y 0 e − α t y(t)=y_0e^{-\alpha t} y ( t ) = y 0 e − α t
y n + 1 = ( 1 − α h ) y n . y_{n+1}=(1-\alpha h)y_n.
y n + 1 = ( 1 − α h ) y n .
α h > 1 \alpha h>1 α h > 1 α h > 2 \alpha h>2 α h > 2 1 1 1 0 < α h < 2 0<\alpha h<2 0 < α h < 2
车辆碰撞后突然剧烈抖动、飞离场景,是数值失稳可能呈现的视觉现象。不过单看游戏中的异常视频,不能确定它一定由欧拉积分引起;碰撞检测、接触求解和程序错误也可能造成相似结果。接下来需要改进的是具体的时间更新或约束处理方法。
中点法
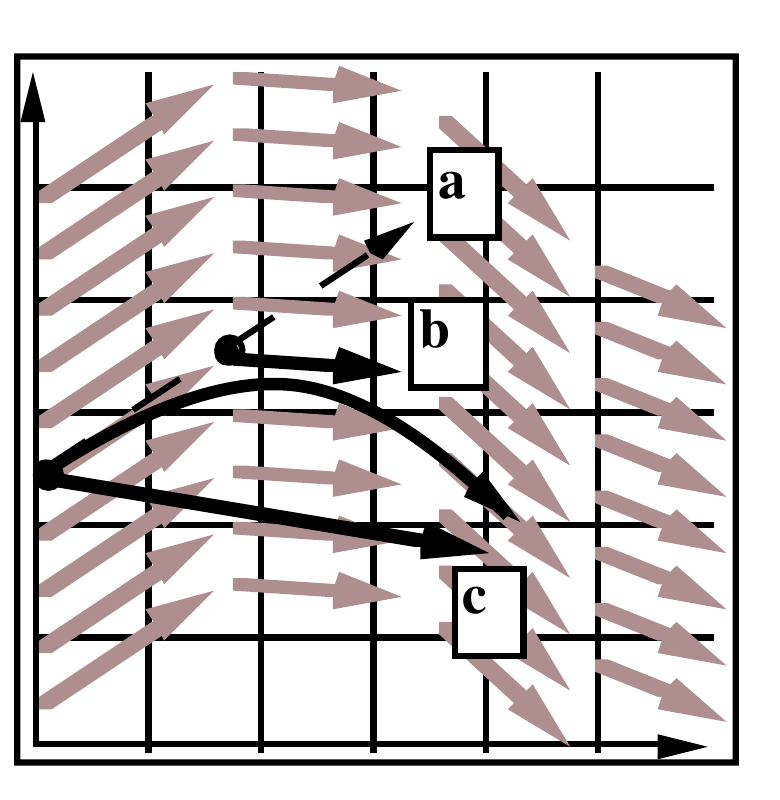
显式欧拉只看起点速度。一个自然的改进是:先大致看看粒子会走到哪里,再选一个更能代表整段运动的速度。
从左侧黑点出发,按起点速度走完整步,会得到欧拉预测点 a a a a a a b b b b b b b b b c c c c c c a a a
显式中点法 Explicit Midpoint Method 可分成两步:
x m i d = x n + h 2 v ( x n , t n ) , \mathbf x_{\rm mid}
=\mathbf x_n+\frac h2\mathbf v(\mathbf x_n,t_n),
x mid = x n + 2 h v ( x n , t n ) ,
x n + 1 = x n + h v ( x m i d , t n + h 2 ) . \mathbf x_{n+1}
=\mathbf x_n+h\mathbf v\left(\mathbf x_{\rm mid},t_n+\frac h2\right).
x n + 1 = x n + h v ( x mid , t n + 2 h ) .
中点只用于查询速度,最终位移仍从原起点开始、推进完整的 h h h
把位置换成完整状态,令 k 1 = f ( y n , t n ) \mathbf k_1=\mathbf f(\mathbf y_n,t_n) k 1 = f ( y n , t n )
k 2 = f ( y n + h 2 k 1 , t n + h 2 ) , y n + 1 = y n + h k 2 . \mathbf k_2
=\mathbf f\left(\mathbf y_n+\frac h2\mathbf k_1,t_n+\frac h2\right),
\qquad
\mathbf y_{n+1}=\mathbf y_n+h\mathbf k_2.
k 2 = f ( y n + 2 h k 1 , t n + 2 h ) , y n + 1 = y n + h k 2 .
k 1 \mathbf k_1 k 1 k 2 \mathbf k_2 k 2
另一个相关思路是平均两端速度。对当前位置和速度,先预测 v ~ n + 1 = v n + h a n \widetilde{\mathbf v}_{n+1}=\mathbf v_n+h\mathbf a_n v n + 1 = v n + h a n
x n + 1 = x n + h 2 ( v n + v ~ n + 1 ) = x n + h v n + h 2 2 a n . \mathbf x_{n+1}
=\mathbf x_n+\frac h2(\mathbf v_n+\widetilde{\mathbf v}_{n+1})
=\mathbf x_n+h\mathbf v_n+\frac{h^2}{2}\mathbf a_n.
x n + 1 = x n + 2 h ( v n + v n + 1 ) = x n + h v n + 2 h 2 a n .
这就是改进欧拉 Modified Euler 的平均速度思路。最后一项考虑了步内速度的变化,对恒定加速度恰好得到匀加速位移式。一般状态方程的 Heun 方法 先预测终点,再查询预测终点的导数:
k 1 = f ( y n , t n ) , y ~ = y n + h k 1 , \mathbf k_1=\mathbf f(\mathbf y_n,t_n),\qquad
\widetilde{\mathbf y}=\mathbf y_n+h\mathbf k_1,
k 1 = f ( y n , t n ) , y = y n + h k 1 ,
k 2 = f ( y ~ , t n + h ) , y n + 1 = y n + h 2 ( k 1 + k 2 ) . \mathbf k_2=\mathbf f(\widetilde{\mathbf y},t_n+h),\qquad
\mathbf y_{n+1}=\mathbf y_n+\frac h2(\mathbf k_1+\mathbf k_2).
k 2 = f ( y , t n + h ) , y n + 1 = y n + 2 h ( k 1 + k 2 ) .
这里平均的是起点与预测终点的变化率,近似积分中的梯形面积;中点法则用中点变化率代表整段平均。这两种方法都能在光滑区域提高精度,但不能仅凭“多看了一次速度”就断言它们对任何步长都稳定,后面会再比较。
自适应步长
步长不一定要从头到尾相同。轨迹平缓时可以走得稍长,转弯或受力变化快时再细分。问题是:怎样判断当前这一步是否过大?
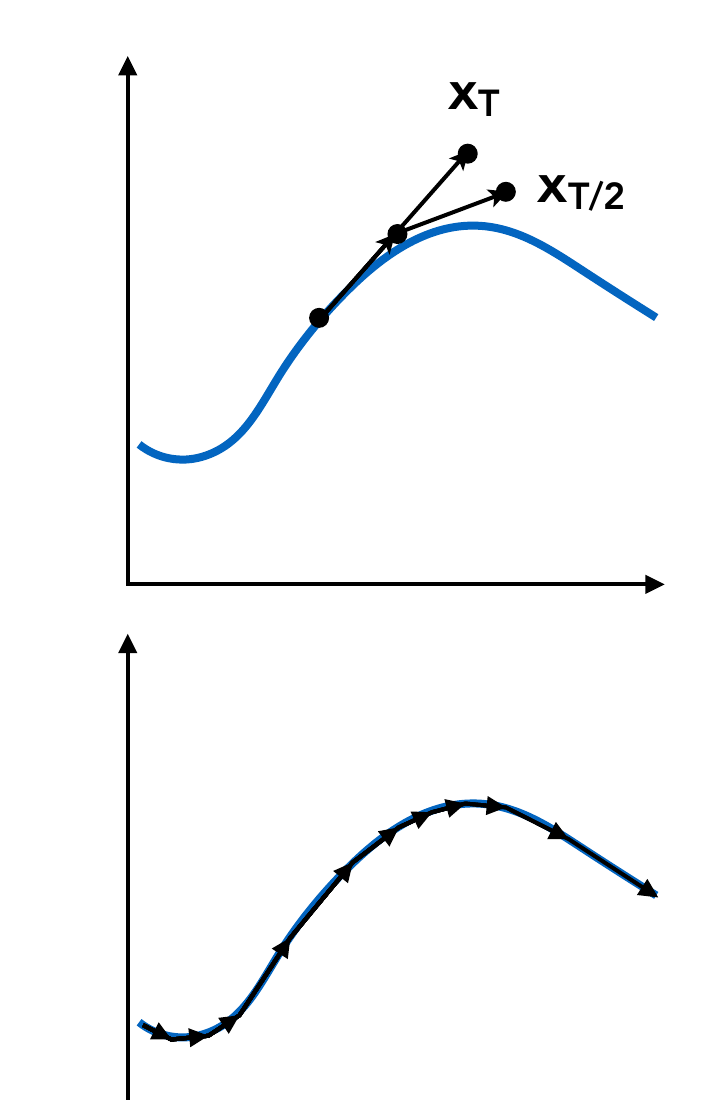
用显式欧拉做两次计算即可得到一个实用判断。两次计算都从同一状态、同一时刻开始,也都到达 t n + h t_n+h t n + h
一次走完 h h h x c o a r s e \mathbf x_{\rm coarse} x coarse
先走 h / 2 h/2 h /2 h / 2 h/2 h /2 x f i n e \mathbf x_{\rm fine} x fine
比较两个终点的距离。差异过大时,拒绝这次尝试,减小步长后重算;差异足够小时接受结果。
上图的 x T x_T x T x T / 2 x_{T/2} x T /2 自适应步长 Adaptive Step Size 的思路。
这与中点法有一个重要区别:中点法回到原起点,沿中点速度走完整步;两次半步则从中间位置继续走第二个半步。相同的“中间位置”会用于不同的更新流程,不能混用。
1
2
3
4
5
6
7
从同一当前状态 y 和时刻 t 开始: coarse = EulerStep(y, t, h) middle = EulerStep(y, t, h / 2) fine = EulerStep(middle, t + h / 2, h / 2) 估计 coarse 与 fine 的差异 若差异超过容差:减小 h,保持 y 和 t 不变,重新尝试 否则:接受 fine,推进到 t + h
容差 Tolerance 是允许的误差尺度。只比较结果是否接近,不能得到绝对精确的误差,但能够识别当前区间对步长是否敏感。对足够光滑的解,若整步误差主项为 c h p + 1 c h^{p+1} c h p + 1 2 c ( h / 2 ) p + 1 = c h p + 1 / 2 p 2c(h/2)^{p+1}=c h^{p+1}/2^p 2 c ( h /2 ) p + 1 = c h p + 1 / 2 p p p p
e f i n e ≈ y c o a r s e − y f i n e 2 p − 1 . \mathbf e_{\rm fine}
\approx\frac{\mathbf y_{\rm coarse}-\mathbf y_{\rm fine}}{2^p-1}.
e fine ≈ 2 p − 1 y coarse − y fine .
这是Richardson 误差估计 。它比较两个到达同一时刻的近似,利用主误差项随步长缩放的关系;对于显式欧拉,p = 1 p=1 p = 1 1 1 1
若状态包含位置、速度等不同量,直接计算未缩放的欧氏距离会混合不同单位。可为每个分量 j j j a t o l j \mathrm{atol}_j atol j r t o l j \mathrm{rtol}_j rtol j
ε = 1 d ∑ j = 1 d ( e j a t o l j + r t o l j ∣ y f i n e , j ∣ ) 2 . \varepsilon=
\sqrt{\frac1d\sum_{j=1}^{d}
\left(\frac{e_j}{\mathrm{atol}_j+\mathrm{rtol}_j\lvert y_{\mathrm{fine},j}\rvert}\right)^2}.
ε = d 1 j = 1 ∑ d ( atol j + rtol j ∣ y fine , j ∣ e j ) 2 .
d d d ε ≤ 1 \varepsilon\le1 ε ≤ 1 1 1 1
由误差近似随 h p + 1 h^{p+1} h p + 1
h n e w = η h ε − 1 / ( p + 1 ) , 0 < η < 1 , h_{\rm new}=\eta h\,\varepsilon^{-1/(p+1)},\qquad 0<\eta<1,
h new = η h ε − 1/ ( p + 1 ) , 0 < η < 1 ,
其中 η \eta η
自适应主要控制精度,显式方法仍有稳定步长限制。若系统同时包含很快的恢复过程和较慢的整体运动,显式方法会被快过程迫使使用很小的步长,这类情况称为刚性 Stiffness 。比如布料整体移动缓慢,但高刚度弹簧对伸长的恢复很快;即使关注的慢轨迹很平缓,也可能需要很小的步长才能不发散。这种情况下值得考虑隐式方法。
隐式欧拉
显式欧拉在起点取速度。现在换一个要求:让这一时间步的位移与终点处的速度相符。隐式欧拉 Implicit Euler ,也称 Backward Euler ,写为
x n + 1 = x n + h v ( x n + 1 , t n + 1 ) . \mathbf x_{n+1}
=\mathbf x_n+h\mathbf v(\mathbf x_{n+1},t_{n+1}).
x n + 1 = x n + h v ( x n + 1 , t n + 1 ) .
看起来只换了下标,计算任务却改变了:终点未知,终点处的速度也未知。我们要寻找一个位置,使“从起点到它的位移”恰好等于“它自身的速度乘步长”。对完整状态,同样要求
y n + 1 = y n + h f ( y n + 1 , t n + 1 ) . \mathbf y_{n+1}
=\mathbf y_n+h\mathbf f(\mathbf y_{n+1},t_{n+1}).
y n + 1 = y n + h f ( y n + 1 , t n + 1 ) .
“Backward”不表示模拟时间倒退,仍然是从 t n t_n t n t n + h t_n+h t n + h
先用刚才的恢复运动 y ˙ = − α y \dot y=-\alpha y y ˙ = − α y
y n + 1 = y n − h α y n + 1 ⟹ y n + 1 = y n 1 + α h . y_{n+1}=y_n-h\alpha y_{n+1}
\quad\Longrightarrow\quad
y_{n+1}=\frac{y_n}{1+\alpha h}.
y n + 1 = y n − h α y n + 1 ⟹ y n + 1 = 1 + α h y n .
对任意 h > 0 h>0 h > 0 0 0 0 1 1 1 e − α h e^{-\alpha h} e − α h
对质量为 m m m − k x -kx − k x ω = k / m \omega=\sqrt{k/m} ω = k / m − ω 2 x -\omega^2x − ω 2 x
x n + 1 = x n + h v n + 1 , v n + 1 = v n − h ω 2 x n + 1 . x_{n+1}=x_n+hv_{n+1},\qquad
v_{n+1}=v_n-h\omega^2x_{n+1}.
x n + 1 = x n + h v n + 1 , v n + 1 = v n − h ω 2 x n + 1 .
把第一式代入第二式,便可解出
v n + 1 = v n − h ω 2 x n 1 + h 2 ω 2 , x n + 1 = x n + h v n 1 + h 2 ω 2 . v_{n+1}=\frac{v_n-h\omega^2x_n}{1+h^2\omega^2},
\qquad
x_{n+1}=\frac{x_n+hv_n}{1+h^2\omega^2}.
v n + 1 = 1 + h 2 ω 2 v n − h ω 2 x n , x n + 1 = 1 + h 2 ω 2 x n + h v n .
这个线性例子可以直接代数求解。一般的力会随位置、速度非线性变化,多个粒子也可能相互耦合,就需要求解更大的方程组。不能先用显式公式预测一个终点,把该处导数代回一次,就认为已经求出了隐式解;终点必须满足自身参与的方程。
更一般的稳定性分析常用测试方程 Test Equation y ˙ = λ y \dot y=\lambda y y ˙ = λ y g E = 1 + h λ g_E=1+h\lambda g E = 1 + hλ 放大因子 Amplification Factor 。若连续解应衰减,离散更新也应满足 ∣ g E ∣ ≤ 1 |g_E|\le1 ∣ g E ∣ ≤ 1 h λ h\lambda hλ 稳定域 Stability Region :显式欧拉的稳定域是复平面中以 − 1 -1 − 1 1 1 1
为什么这样的标量方程能帮助理解多变量系统?在某个状态附近,可以将 f \mathbf f f Jacobian 矩阵 J = ∂ f / ∂ y J=\partial\mathbf f/\partial\mathbf y J = ∂ f / ∂ y J a b J_{ab} J ab y b y_b y b f a f_a f a d \mathbf d d J d = λ d J\mathbf d=\lambda\mathbf d J d = λ d d \mathbf d d 特征向量 Eigenvector ,λ \lambda λ 特征值 Eigenvalue 。在线性系统中,沿这个方向的运动可由一个标量幅度描述,它满足 y ˙ = λ y \dot y=\lambda y y ˙ = λ y
常见做法是把问题改写成求根 Root Finding 。定义残差
R ( y ) = y − y n − h f ( y , t n + 1 ) . \mathbf R(\mathbf y)=\mathbf y-\mathbf y_n-h\mathbf f(\mathbf y,t_{n+1}).
R ( y ) = y − y n − h f ( y , t n + 1 ) .
残差表示当前终点猜测偏离隐式方程的程度,要求解 R ( y ) = 0 \mathbf R(\mathbf y)=\mathbf0 R ( y ) = 0 Newton 方法 在当前猜测 y ( k ) \mathbf y^{(k)} y ( k )
( I − h ∂ f ∂ y ∣ y ( k ) ) Δ y = − R ( y ( k ) ) , y ( k + 1 ) = y ( k ) + Δ y . \left(I-h\frac{\partial\mathbf f}{\partial\mathbf y}
\bigg|_{\mathbf y^{(k)}}\right)\Delta\mathbf y
=-\mathbf R(\mathbf y^{(k)}),
\qquad
\mathbf y^{(k+1)}=\mathbf y^{(k)}+\Delta\mathbf y.
( I − h ∂ y ∂ f y ( k ) ) Δ y = − R ( y ( k ) ) , y ( k + 1 ) = y ( k ) + Δ y .
I I I k k k
它的稳定优势也可以用刚才的测试方程说明:
y ˙ = λ y ⟹ y n + 1 = y n 1 − h λ , g I = 1 1 − h λ . \dot y=\lambda y
\quad\Longrightarrow\quad
y_{n+1}=\frac{y_n}{1-h\lambda},
\qquad g_I=\frac1{1-h\lambda}.
y ˙ = λ y ⟹ y n + 1 = 1 − hλ y n , g I = 1 − hλ 1 .
若 Re λ ≤ 0 \operatorname{Re}\lambda\le0 Re λ ≤ 0
∣ 1 − h λ ∣ 2 = ( 1 − h Re λ ) 2 + ( h Im λ ) 2 ≥ 1 , |1-h\lambda|^2
=(1-h\operatorname{Re}\lambda)^2
+(h\operatorname{Im}\lambda)^2\ge1,
∣1 − hλ ∣ 2 = ( 1 − h Re λ ) 2 + ( h Im λ ) 2 ≥ 1 ,
故任意正步长都有 ∣ g I ∣ ≤ 1 |g_I|\le1 ∣ g I ∣ ≤ 1 A-stable ;当 h λ h\lambda hλ − ∞ -\infty − ∞ g I → 0 g_I\to0 g I → 0 L-stable 的强衰减性质。这里分析的是测试方程及相应线性模态,非线性求解是否收敛、碰撞和约束是否处理正确,仍需另行检查。
对于无阻尼振荡 λ = ± i ω \lambda=\pm i\omega λ = ± iω i i i i 2 = − 1 i^2=-1 i 2 = − 1 ∣ g I ∣ = 1 / 1 + h 2 ω 2 < 1 |g_I|=1/\sqrt{1+h^2\omega^2}<1 ∣ g I ∣ = 1/ 1 + h 2 ω 2 < 1 E n = 1 2 m v n 2 + 1 2 k x n 2 E_n=\tfrac12mv_n^2+\tfrac12kx_n^2 E n = 2 1 m v n 2 + 2 1 k x n 2
E n + 1 = E n 1 + h 2 ω 2 . E_{n+1}=\frac{E_n}{1+h^2\omega^2}.
E n + 1 = 1 + h 2 ω 2 E n .
这称为数值耗散 Numerical Dissipation :没有物理阻尼,算法却让运动逐渐减弱。它有助于抑制失稳,但也会损失原本应保留的振动。选择大步长隐式积分时,要同时检查稳定性和运动被衰减的程度。
误差阶数
前面已经比较了几种算法的计算方式。要进一步比较精度,需要回答:步长减小后,误差会以多快的速度下降?
局部截断误差 Local Truncation Error 是假设这一步从真实状态出发,仅因离散公式产生的单步误差。全局误差 Global Error 是经过许多步后,数值状态与同一时刻真实状态的差异;它包含先前误差的传播和新误差的累积。这里用的是“单步状态差”定义,某些数值分析教材会再除以 h h h
对光滑解,Taylor 展开为
y ( t + h ) = y ( t ) + h y ˙ ( t ) + h 2 2 y ¨ ( t ) + O ( h 3 ) . \mathbf y(t+h)
=\mathbf y(t)+h\dot{\mathbf y}(t)
+\frac{h^2}{2}\ddot{\mathbf y}(t)+O(h^3).
y ( t + h ) = y ( t ) + h y ˙ ( t ) + 2 h 2 y ¨ ( t ) + O ( h 3 ) .
显式欧拉保留前两项,因此遗漏的单步主项是 O ( h 2 ) O(h^2) O ( h 2 )
y ( t + h ) = y ( t ) + h y ˙ ( t ) + ∫ 0 h ( h − s ) y ¨ ( t + s ) d s . \mathbf y(t+h)
=\mathbf y(t)+h\dot{\mathbf y}(t)
+\int_0^h(h-s)\ddot{\mathbf y}(t+s)\,\mathrm ds.
y ( t + h ) = y ( t ) + h y ˙ ( t ) + ∫ 0 h ( h − s ) y ¨ ( t + s ) d s .
若二阶导数有界,余项随 h 2 h^2 h 2 T T T T / h T/h T / h O ( h 2 ) O(h^2) O ( h 2 ) O ( h ) O(h) O ( h )
O ( h ) O(h) O ( h ) h h h O ( h 2 ) O(h^2) O ( h 2 ) 1 / 4 1/4 1/4 1 / 16 1/16 1/16
中点法为什么多保留了一阶?沿状态和时间共同展开其中点导数,有
k 2 = f n + h 2 ( ∂ f ∂ t + J n f n ) + O ( h 2 ) , \mathbf k_2
=\mathbf f_n+\frac h2\left(
\frac{\partial\mathbf f}{\partial t}
+J_n\mathbf f_n\right)+O(h^2),
k 2 = f n + 2 h ( ∂ t ∂ f + J n f n ) + O ( h 2 ) ,
其中 f n = f ( y n , t n ) \mathbf f_n=\mathbf f(\mathbf y_n,t_n) f n = f ( y n , t n ) J n J_n J n y ¨ ( t n ) \ddot{\mathbf y}(t_n) y ¨ ( t n ) h h h O ( h 3 ) O(h^3) O ( h 3 ) O ( h 2 ) O(h^2) O ( h 2 ) h 2 a / 2 h^2\mathbf a/2 h 2 a /2
阶数衡量步长缩小时的精度变化。稳定性衡量更新是否放大本应受控的扰动。隐式欧拉虽然只有一阶,却能稳定处理许多显式高阶方法需要极小步长的问题。
RK4
Runge–Kutta 方法 是求解 ODE 的一类方法。它们继续沿用“在一个时间步内多次查询变化率”的思路,设计采样位置和组合权重,使结果更接近真实积分。中点法和 Heun 法就属于显式二阶 Runge–Kutta 方法。
常用的经典四阶方法称为 RK4 。可以把它理解为:从起点查询一次,分别用两种半步预测再查询两次,最后用一次完整步预测查询终点。对 y ˙ = f ( y , t ) \dot{\mathbf y}=\mathbf f(\mathbf y,t) y ˙ = f ( y , t )
k 1 = f ( y n , t n ) , k 2 = f ( y n + h 2 k 1 , t n + h 2 ) , k 3 = f ( y n + h 2 k 2 , t n + h 2 ) , k 4 = f ( y n + h k 3 , t n + h ) . \begin{aligned}
\mathbf k_1&=\mathbf f(\mathbf y_n,t_n),\\
\mathbf k_2&=\mathbf f\left(\mathbf y_n+\frac h2\mathbf k_1,t_n+\frac h2\right),\\
\mathbf k_3&=\mathbf f\left(\mathbf y_n+\frac h2\mathbf k_2,t_n+\frac h2\right),\\
\mathbf k_4&=\mathbf f(\mathbf y_n+h\mathbf k_3,t_n+h).
\end{aligned}
k 1 k 2 k 3 k 4 = f ( y n , t n ) , = f ( y n + 2 h k 1 , t n + 2 h ) , = f ( y n + 2 h k 2 , t n + 2 h ) , = f ( y n + h k 3 , t n + h ) .
第二、第三次都在半步时刻,却从不同的预测状态查询:k 2 \mathbf k_2 k 2 k 3 \mathbf k_3 k 3 k 2 \mathbf k_2 k 2
最后从原状态推进
y n + 1 = y n + h 6 ( k 1 + 2 k 2 + 2 k 3 + k 4 ) . \mathbf y_{n+1}
=\mathbf y_n+\frac h6
(\mathbf k_1+2\mathbf k_2+2\mathbf k_3+\mathbf k_4).
y n + 1 = y n + 6 h ( k 1 + 2 k 2 + 2 k 3 + k 4 ) .
括号除以 6 6 6 1 , 2 , 2 , 1 1,2,2,1 1 , 2 , 2 , 1 O ( h 5 ) O(h^5) O ( h 5 ) O ( h 4 ) O(h^4) O ( h 4 )
在线性测试方程 y ˙ = λ y \dot y=\lambda y y ˙ = λ y z = h λ z=h\lambda z = hλ
y n + 1 = R ( z ) y n , R ( z ) = 1 + z + z 2 2 + z 3 6 + z 4 24 . y_{n+1}=R(z)y_n,
\qquad
R(z)=1+z+\frac{z^2}{2}+\frac{z^3}{6}+\frac{z^4}{24}.
y n + 1 = R ( z ) y n , R ( z ) = 1 + z + 2 z 2 + 6 z 3 + 24 z 4 .
精确解每步乘 e z e^z e z R ( z ) R(z) R ( z )
高精度依然不等于任意步长稳定。显式中点法与 Heun 法在这个测试方程上都有 R 2 ( z ) = 1 + z + z 2 / 2 R_2(z)=1+z+z^2/2 R 2 ( z ) = 1 + z + z 2 /2 z = i u z=iu z = i u u = h ω u=h\omega u = hω
∣ R 2 ( i u ) ∣ 2 = ( 1 − u 2 2 ) 2 + u 2 = 1 + u 4 4 > 1 ( u ≠ 0 ) . |R_2(iu)|^2
=\left(1-\frac{u^2}{2}\right)^2+u^2
=1+\frac{u^4}{4}>1\quad(u\ne0).
∣ R 2 ( i u ) ∣ 2 = ( 1 − 2 u 2 ) 2 + u 2 = 1 + 4 u 4 > 1 ( u = 0 ) .
振幅仍会缓慢增长。RK4 的实部和虚部分别为 1 − u 2 / 2 + u 4 / 24 1-u^2/2+u^4/24 1 − u 2 /2 + u 4 /24 u − u 3 / 6 u-u^3/6 u − u 3 /6
∣ R ( i u ) ∣ 2 = 1 − u 6 72 + u 8 576 = 1 + u 6 ( u 2 − 8 ) 576 . |R(iu)|^2
=1-\frac{u^6}{72}+\frac{u^8}{576}
=1+\frac{u^6(u^2-8)}{576}.
∣ R ( i u ) ∣ 2 = 1 − 72 u 6 + 576 u 8 = 1 + 576 u 6 ( u 2 − 8 ) .
因此在纯虚轴上,RK4 的线性稳定范围是 ∣ h ω ∣ ≤ 2 2 |h\omega|\le2\sqrt2 ∣ hω ∣ ≤ 2 2 z = − 2.78 z=-2.78 z = − 2.78
这些放大因子的意义还可以回到具体的弹簧运动来理解。
无阻尼质点—弹簧满足
x ˙ = v , v ˙ = − ω 2 x , ω = k / m , \dot x=v,\qquad \dot v=-\omega^2x,
\qquad \omega=\sqrt{k/m},
x ˙ = v , v ˙ = − ω 2 x , ω = k / m ,
其中 x x x m m m k k k ω \omega ω E n = 1 2 m v n 2 + 1 2 k x n 2 E_n=\tfrac12mv_n^2+\tfrac12kx_n^2 E n = 2 1 m v n 2 + 2 1 k x n 2
E n + 1 = E n + h 2 2 ( k v n 2 + k 2 m x n 2 ) = ( 1 + h 2 ω 2 ) E n . E_{n+1}
=E_n+\frac{h^2}{2}\left(kv_n^2+\frac{k^2}{m}x_n^2\right)
=(1+h^2\omega^2)E_n.
E n + 1 = E n + 2 h 2 ( k v n 2 + m k 2 x n 2 ) = ( 1 + h 2 ω 2 ) E n .
数值计算在每一步增加了能量,振幅便会增长。对应测试方程的特征值为 λ = ± i ω \lambda=\pm i\omega λ = ± iω i i i ∣ 1 + h λ ∣ = 1 + h 2 ω 2 > 1 |1+h\lambda|=\sqrt{1+h^2\omega^2}>1 ∣1 + hλ ∣ = 1 + h 2 ω 2 > 1
前面提到的半隐式欧拉有不同结果。将它的两式合并,有
( x n + 1 v n + 1 ) = ( 1 − h 2 ω 2 h − h ω 2 1 ) ⏟ A h ( x n v n ) . \begin{pmatrix}x_{n+1}\\v_{n+1}\end{pmatrix}
=
\underbrace{\begin{pmatrix}
1-h^2\omega^2&h\\
-h\omega^2&1
\end{pmatrix}}_{A_h}
\begin{pmatrix}x_n\\v_n\end{pmatrix}.
( x n + 1 v n + 1 ) = A h ( 1 − h 2 ω 2 − h ω 2 h 1 ) ( x n v n ) .
det A h = 1 \det A_h=1 det A h = 1 tr A h = 2 − h 2 ω 2 \operatorname{tr}A_h=2-h^2\omega^2 tr A h = 2 − h 2 ω 2 det \det det tr \operatorname{tr} tr μ \mu μ
μ 2 − ( 2 − h 2 ω 2 ) μ + 1 = 0. \mu^2-(2-h^2\omega^2)\mu+1=0.
μ 2 − ( 2 − h 2 ω 2 ) μ + 1 = 0.
这里 μ \mu μ ∣ 2 − h 2 ω 2 ∣ < 2 |2-h^2\omega^2|<2 ∣2 − h 2 ω 2 ∣ < 2 0 < h ω < 2 0<h\omega<2 0 < hω < 2 1 1 1 1 1 1 h ω = 2 h\omega=2 hω = 2
加阻尼也有帮助,但改变的是物理模型。若 m x ¨ + c x ˙ + k x = 0 m\ddot x+c\dot x+kx=0 m x ¨ + c x ˙ + k x = 0
λ = − c 2 m ± ( c 2 m ) 2 − k m . \lambda=-\frac{c}{2m}
\pm\sqrt{\left(\frac{c}{2m}\right)^2-\frac{k}{m}}.
λ = − 2 m c ± ( 2 m c ) 2 − m k .
阻尼 c c c k k k 刚性问题 中的快慢尺度差异相对应。增加显式方法的阶数并不会消除最快过程带来的步长限制。
若重点是长时间保持保守系统的运动性质,还会使用辛积分器 Symplectic Integrator 。这里的“辛”指保持 Hamiltonian 动力学的特定几何结构,不表示每一步能量都精确守恒;半隐式欧拉和适用条件下的 Verlet 往往能把长期能量误差控制为有界振荡。精度、稳定范围、长期性质和每步成本需要分别考虑。
Verlet与约束
前面的算法主要近似运动方程。还有一种直接的处理方式:先预测粒子位置,再把不满足几何条件的位置改正。
例如用粒子和弹簧模拟绳子,若某一段被拉得过长,可以移动两端,把它恢复到规定长度。这个规则相当于给该段加入长度约束;它没有详细求解弹簧从拉伸到恢复的每个受力过程。这样通常较快,也能避免用极高刚度弹簧逼近“不可伸长”时产生的小步长要求。
基于位置的动力学 Position-Based Dynamics,PBD 用这种思路组织更新。对粒子 i i i
v i ∗ = v i n + h F i e x t m i , x i ∗ = x i n + h v i ∗ = x i n + h v i n + h 2 m i F i e x t . \mathbf v_i^*=\mathbf v_i^n+h\frac{\mathbf F_i^{\rm ext}}{m_i},
\qquad
\mathbf x_i^*=\mathbf x_i^n+h\mathbf v_i^*
=\mathbf x_i^n+h\mathbf v_i^n+\frac{h^2}{m_i}\mathbf F_i^{\rm ext}.
v i ∗ = v i n + h m i F i ext , x i ∗ = x i n + h v i ∗ = x i n + h v i n + m i h 2 F i ext .
再调整 x i ∗ \mathbf x_i^* x i ∗
v i n + 1 = x i n + 1 − x i n h . \mathbf v_i^{n+1}
=\frac{\mathbf x_i^{n+1}-\mathbf x_i^n}{h}.
v i n + 1 = h x i n + 1 − x i n .
约束 Constraint 是要求状态满足的条件。距离条件可写为 C ( x ) = 0 C(\mathbf x)=0 C ( x ) = 0 C ( x ) ≥ 0 C(\mathbf x)\ge0 C ( x ) ≥ 0 约束投影 Constraint Projection 。有限次迭代一般只是近似满足。
先看两粒子之间的距离约束:
C = ∥ x a − x b ∥ − ℓ 0 , n = x a − x b ∥ x a − x b ∥ . C=\|\mathbf x_a-\mathbf x_b\|-\ell_0,
\qquad
\mathbf n=\frac{\mathbf x_a-\mathbf x_b}{\|\mathbf x_a-\mathbf x_b\|}.
C = ∥ x a − x b ∥ − ℓ 0 , n = ∥ x a − x b ∥ x a − x b .
ℓ 0 \ell_0 ℓ 0 C > 0 C>0 C > 0 C < 0 C<0 C < 0 n \mathbf n n b b b a a a
Δ x a = − C 2 n , Δ x b = C 2 n . \Delta\mathbf x_a=-\frac C2\mathbf n,
\qquad
\Delta\mathbf x_b=\frac C2\mathbf n.
Δ x a = − 2 C n , Δ x b = 2 C n .
若一端固定,全部修正由另一端承担;若质量不同,较轻的一端应移动更多。两点重合时方向 n \mathbf n n
一般约束的修正可由局部线性化得到。梯度 Gradient ∇ i C \nabla_iC ∇ i C i i i w i = 1 / m i w_i=1/m_i w i = 1/ m i w i = 0 w_i=0 w i = 0
Δ x i = − w i β ∇ i C . \Delta\mathbf x_i=-w_i\beta\nabla_iC.
Δ x i = − w i β ∇ i C .
把它代入 C ( x + Δ x ) ≈ C + ∑ i ∇ i C ⋅ Δ x i = 0 C(\mathbf x+\Delta\mathbf x)\approx C+\sum_i\nabla_iC\cdot\Delta\mathbf x_i=0 C ( x + Δ x ) ≈ C + ∑ i ∇ i C ⋅ Δ x i = 0
β = C ∑ i w i ∥ ∇ i C ∥ 2 . \beta=\frac{C}{\sum_iw_i\|\nabla_iC\|^2}.
β = ∑ i w i ∥ ∇ i C ∥ 2 C .
这解释了修正方向、修正大小和质量分配的由来。对距离约束,∇ a C = n \nabla_aC=\mathbf n ∇ a C = n ∇ b C = − n \nabla_bC=-\mathbf n ∇ b C = − n
改正一段距离可能影响相邻另一段,所以需要多轮投影。Gauss–Seidel 迭代 立即使用最新位置处理下一约束;Jacobi 迭代 先按同一轮的旧位置计算各修正,再批量应用,更适合并行,但通常需要额外处理多个修正的累积和收敛。约束顺序、迭代次数与时间步都会影响最终的等效刚度。
XPBD Extended Position-Based Dynamics 为约束加入柔度 Compliance α c \alpha_c α c α ~ c = α c / h 2 \widetilde\alpha_c=\alpha_c/h^2 α c = α c / h 2 μ \mu μ
Δ μ = − C − α ~ c μ ∑ i w i ∥ ∇ i C ∥ 2 + α ~ c , Δ x i = w i ∇ i C Δ μ , μ ← μ + Δ μ . \Delta\mu=
\frac{-C-\widetilde\alpha_c\mu}
{\sum_iw_i\|\nabla_iC\|^2+\widetilde\alpha_c},
\qquad
\Delta\mathbf x_i=w_i\nabla_iC\,\Delta\mu,
\qquad
\mu\leftarrow\mu+\Delta\mu.
Δ μ = ∑ i w i ∥ ∇ i C ∥ 2 + α c − C − α c μ , Δ x i = w i ∇ i C Δ μ , μ ← μ + Δ μ .
约束乘子控制沿梯度修正的大小;这里把符号放进乘子,和上面写成 − β -\beta − β
位置修正经常与 Verlet Integration 配合使用,但两者承担不同任务。Verlet 负责近似运动方程,位置投影负责约束。经典 Verlet 从当前位置和上一步位置预测下一步:
x n + 1 = 2 x n − x n − 1 + h 2 a n . \mathbf x_{n+1}=2\mathbf x_n-\mathbf x_{n-1}+h^2\mathbf a_n.
x n + 1 = 2 x n − x n − 1 + h 2 a n .
其中 x n − x n − 1 \mathbf x_n-\mathbf x_{n-1} x n − x n − 1 h 2 a n h^2\mathbf a_n h 2 a n
x ( t + h ) = x ( t ) + h x ˙ ( t ) + h 2 2 x ¨ ( t ) + h 3 6 x ( 3 ) ( t ) + O ( h 4 ) , x ( t − h ) = x ( t ) − h x ˙ ( t ) + h 2 2 x ¨ ( t ) − h 3 6 x ( 3 ) ( t ) + O ( h 4 ) . \begin{aligned}
\mathbf x(t+h)&=\mathbf x(t)+h\dot{\mathbf x}(t)
+\frac{h^2}{2}\ddot{\mathbf x}(t)
+\frac{h^3}{6}\mathbf x^{(3)}(t)+O(h^4),\\
\mathbf x(t-h)&=\mathbf x(t)-h\dot{\mathbf x}(t)
+\frac{h^2}{2}\ddot{\mathbf x}(t)
-\frac{h^3}{6}\mathbf x^{(3)}(t)+O(h^4).
\end{aligned}
x ( t + h ) x ( t − h ) = x ( t ) + h x ˙ ( t ) + 2 h 2 x ¨ ( t ) + 6 h 3 x ( 3 ) ( t ) + O ( h 4 ) , = x ( t ) − h x ˙ ( t ) + 2 h 2 x ¨ ( t ) − 6 h 3 x ( 3 ) ( t ) + O ( h 4 ) .
一阶和三阶项相消,得到 x ( t + h ) = 2 x ( t ) − x ( t − h ) + h 2 a ( t ) + O ( h 4 ) \mathbf x(t+h)=2\mathbf x(t)-\mathbf x(t-h)+h^2\mathbf a(t)+O(h^4) x ( t + h ) = 2 x ( t ) − x ( t − h ) + h 2 a ( t ) + O ( h 4 ) v n ≈ ( x n + 1 − x n − 1 ) / ( 2 h ) \mathbf v_n\approx(\mathbf x_{n+1}-\mathbf x_{n-1})/(2h) v n ≈ ( x n + 1 − x n − 1 ) / ( 2 h )
若需要直接保存速度,可用 Velocity Verlet :
x n + 1 = x n + h v n + h 2 2 a n , v n + 1 = v n + h 2 ( a n + a n + 1 ) . \mathbf x_{n+1}=\mathbf x_n+h\mathbf v_n+\frac{h^2}{2}\mathbf a_n,
\qquad
\mathbf v_{n+1}=\mathbf v_n+\frac h2(\mathbf a_n+\mathbf a_{n+1}).
x n + 1 = x n + h v n + 2 h 2 a n , v n + 1 = v n + 2 h ( a n + a n + 1 ) .
加速度只依赖位置和时间时,先计算新位置,就能查询 a n + 1 \mathbf a_{n+1} a n + 1
对预测位置再做绳长、碰撞等投影,可能改变速度与能量。绳子很快停下来,可能包含这种数值耗散;“更快停下”不自动证明真实阻尼被准确模拟。Verlet 本身仍是基于运动方程的积分器,耗散程度要结合阻尼、约束投影和其他修正一起判断。约束方法的价值在于以较低成本满足重要条件,其物理精度和能量行为也需要单独检查。
刚体
单粒子的方法可以扩展到刚体 Rigid Body 。刚体内部任意两点的距离保持不变,整个物体不能任意局部拉伸;给定整体平移和旋转,就能确定内部所有点的位置,因此不必给每个点单独解一条独立轨迹。
若局部点的位置是 r \mathbf r r x \mathbf x x R R R x + R r \mathbf x+R\mathbf r x + R r 角速度 Angular Velocity ω \boldsymbol\omega ω
先看绕固定轴转动的简单情况,把转角记为 θ \theta θ I I I
d d t ( x θ v ω ) = ( v ω F / m τ / I ) . \frac{\mathrm d}{\mathrm dt}
\begin{pmatrix}\mathbf x\\\theta\\\mathbf v\\\omega\end{pmatrix}
=
\begin{pmatrix}\mathbf v\\\omega\\\mathbf F/m\\\tau/I\end{pmatrix}.
d t d x θ v ω = v ω F / m τ / I .
这与粒子的状态更新形式相同,只是增加了角度和角速度:位置求导得到速度,速度求导得到加速度;角度求导得到角速度,角速度求导得到角加速度。力矩 Torque τ \tau τ 转动惯量 Moment of Inertia 描述质量分布对旋转的影响。给定初始状态、外力与力矩,便能用前面的积分方法推进。
一般三维转动不能只用一个转角和一个常数惯量描述。较稳妥的状态包含线动量 Linear Momentum p = m v \mathbf p=m\mathbf v p = m v 角动量 Angular Momentum L \mathbf L L
p ˙ = F , L ˙ = τ , τ = r × F . \dot{\mathbf p}=\mathbf F,\qquad
\dot{\mathbf L}=\boldsymbol\tau,\qquad
\boldsymbol\tau=\mathbf r\times\mathbf F.
p ˙ = F , L ˙ = τ , τ = r × F .
这里 r \mathbf r r
三维转动惯量是矩阵。若物体坐标中的惯量为 I b o d y I_{\rm body} I body
I w o r l d = R I b o d y R T , v = p m , ω = I w o r l d − 1 L . I_{\rm world}=RI_{\rm body}R^T,
\qquad
\mathbf v=\frac{\mathbf p}{m},
\qquad
\boldsymbol\omega=I_{\rm world}^{-1}\mathbf L.
I world = R I body R T , v = m p , ω = I world − 1 L .
即使没有外力矩、世界角动量保持不变,姿态改变仍会改变 I w o r l d I_{\rm world} I world
R ˙ = [ ω ] × R , [ ω ] × a = ω × a . \dot R=[\boldsymbol\omega]_\times R,
\qquad
[\boldsymbol\omega]_\times\mathbf a
=\boldsymbol\omega\times\mathbf a.
R ˙ = [ ω ] × R , [ ω ] × a = ω × a .
[ ω ] × [\boldsymbol\omega]_\times [ ω ] × R T R R^TR R T R 单位四元数 表示姿态。在将物体坐标主动旋转到世界坐标、采用标准 Hamilton 乘法的约定下,
q ˙ = 1 2 ω q q , ω q = ( 0 , ω ) . \dot q=\frac12\boldsymbol\omega_q q,
\qquad \boldsymbol\omega_q=(0,\boldsymbol\omega).
q ˙ = 2 1 ω q q , ω q = ( 0 , ω ) .
离散更新后要归一化 q q q 冲量 Impulse ,并要求处理不穿透、恢复系数和摩擦;能够推进运动状态只是刚体模拟的一部分。
位置流体
接下来把许多粒子用来表示一整块水。先模拟这些粒子的位置,再从位置重建水面,计算反射、折射等外观。模拟 Simulation 决定几何随时间如何变化,渲染 Rendering 决定该状态在光照和相机下呈现什么图像,两步需要区分。
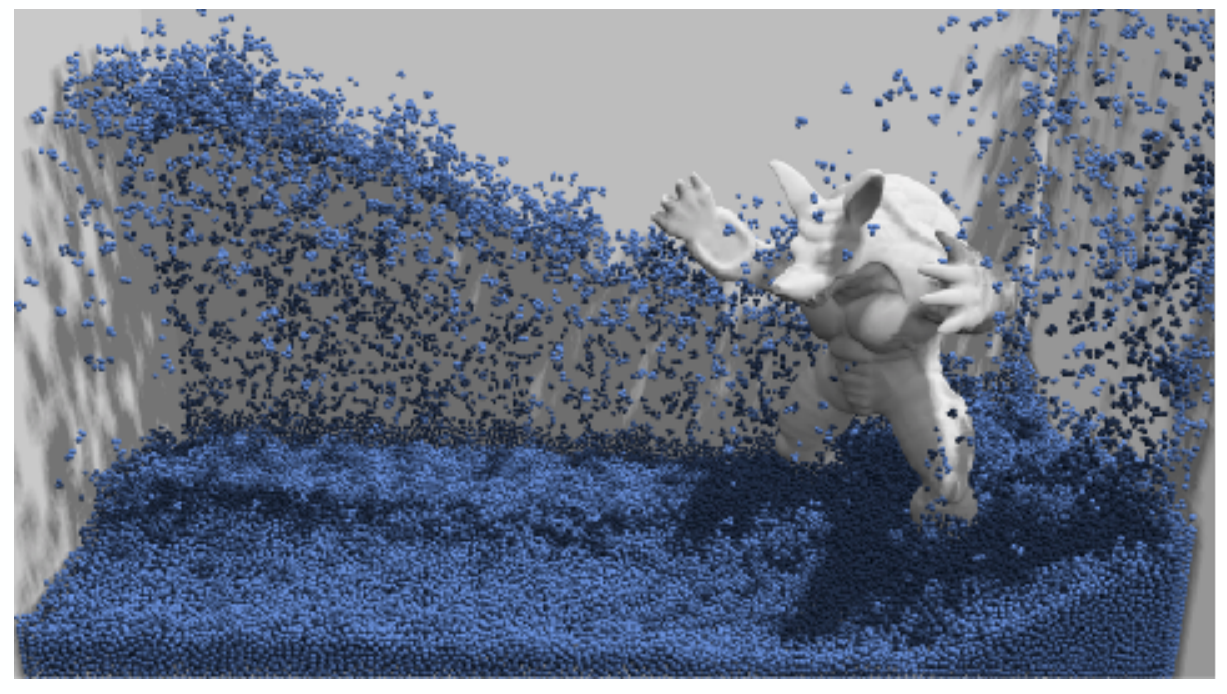
图中蓝色小点是水体的模拟粒子,底部较密,飞溅处较分散,中间还有固体障碍物。它们是对水的质量分布进行离散采样,并不表示真实水由具有图中尺寸的硬球构成。得到粒子运动之后,仍需另一套表面重建和渲染步骤,才能生成连续的水面。
这里采用一个主要假设:水近似不可压缩 Incompressible 。在通常液体模拟的压力范围内,一份水不能明显压成更小体积,也不能只通过拉开内部间距就变成更多的水。因此水内部的密度应接近固定的静止密度 ρ 0 \rho_0 ρ 0
由此得到基于位置的流体 Position-Based Fluids,PBF 的解题思路:先预测粒子运动,检查局部密度;若密度偏离 ρ 0 \rho_0 ρ 0
先把“附近有多少水”写成可计算的量。一个粒子不能只把质量放在数学上的单点,否则密度会处处为零、在粒子点处奇异。平滑核 Smoothing Kernel W ( r , h s ) W(\mathbf r,h_s) W ( r , h s ) h s h_s h s h h h
∫ W ( r , h s ) d r = 1. \int W(\mathbf r,h_s)\,\mathrm d\mathbf r=1.
∫ W ( r , h s ) d r = 1.
这保证分布到空间后的总质量仍等于原粒子质量。对粒子 i i i
ρ i = ∑ j m j W ( x i − x j , h s ) . \rho_i=\sum_jm_jW(\mathbf x_i-\mathbf x_j,h_s).
ρ i = j ∑ m j W ( x i − x j , h s ) .
对于距离越大权重越小的常用核,近邻提供较大贡献,超过支持半径的远处粒子贡献为零。支持半径决定局部平均尺度,也影响查询邻居的计算量。
移动一个邻近粒子,会改变它与 i i i ρ i \rho_i ρ i
C i ( x ) = ρ i ρ 0 − 1 = 0. C_i(\mathbf x)=\frac{\rho_i}{\rho_0}-1=0.
C i ( x ) = ρ 0 ρ i − 1 = 0.
C i > 0 C_i>0 C i > 0 C i < 0 C_i<0 C i < 0 ∇ W i j \nabla W_{ij} ∇ W ij x i − x j \mathbf x_i-\mathbf x_j x i − x j
∇ x k C i = { 1 ρ 0 ∑ j m j ∇ W i j , k = i , − m k ρ 0 ∇ W i k , k ≠ i , k ∈ N i , 0 , 其他 . \nabla_{\mathbf x_k}C_i=
\begin{cases}
\dfrac1{\rho_0}\displaystyle\sum_jm_j\nabla W_{ij},&k=i,\\[6pt]
-\dfrac{m_k}{\rho_0}\nabla W_{ik},&k\ne i,\ k\in\mathcal N_i,\\[6pt]
\mathbf0,&\text{其他}.
\end{cases}
∇ x k C i = ⎩ ⎨ ⎧ ρ 0 1 j ∑ m j ∇ W ij , − ρ 0 m k ∇ W ik , 0 , k = i , k = i , k ∈ N i , 其他 .
N i \mathcal N_i N i
直观上,可以最小化密度误差 1 2 ∑ i C i 2 \tfrac12\sum_iC_i^2 2 1 ∑ i C i 2 梯度下降 Gradient Descent 的思路相同。PBF 常用的具体实现则是质量加权的约束投影:线性化 C i C_i C i
沿用位置约束 的推导,令 w k = 1 / m k w_k=1/m_k w k = 1/ m k
λ i = − C i ∑ k w k ∥ ∇ x k C i ∥ 2 + ε d . \lambda_i=-\frac{C_i}{\displaystyle\sum_kw_k\|\nabla_{\mathbf x_k}C_i\|^2+\varepsilon_d}.
λ i = − k ∑ w k ∥ ∇ x k C i ∥ 2 + ε d C i .
ε d \varepsilon_d ε d ε \varepsilon ε
对等质量、单位粒子质量的常见实现,各邻域约束对同一粒子的修正合并后可写成
Δ x i = 1 ρ 0 ∑ j ∈ N i ( λ i + λ j + s c o r r ) ∇ W i j . \Delta\mathbf x_i
=\frac1{\rho_0}\sum_{j\in\mathcal N_i}
(\lambda_i+\lambda_j+s_{\rm corr})\nabla W_{ij}.
Δ x i = ρ 0 1 j ∈ N i ∑ ( λ i + λ j + s corr ) ∇ W ij .
若使用一般物理质量,需保留前面约束梯度和逆质量中的相应因子,不能不加说明地把它们删去。λ i \lambda_i λ i λ j \lambda_j λ j
人工压力修正 Artificial Pressure 可采用
s c o r r = − k a [ W ( x i − x j , h s ) W ( Δ q , h s ) ] n a , k a > 0 , n a > 0. s_{\rm corr}
=-k_a\left[\frac{W(\mathbf x_i-\mathbf x_j,h_s)}{W(\Delta q,h_s)}\right]^{n_a},
\qquad k_a>0,\ n_a>0.
s corr = − k a [ W ( Δ q , h s ) W ( x i − x j , h s ) ] n a , k a > 0 , n a > 0.
Δ q \Delta q Δ q k a k_a k a n a n_a n a
整个过程与修正绳长相似,只是一个密度约束关联许多邻居:
1
2
3
4
5
6
7
8
9
用外力更新速度,预测粒子位置 查询预测位置附近的邻居 重复若干轮密度修正: 计算每个粒子的密度偏差 C_i 计算约束梯度与乘子 lambda_i 汇总密度约束及人工压力产生的位置修正 修正粒子位置,并处理固体边界 用最终位置回算速度 按需要处理黏性、涡量和阻尼
迭代只近似恢复密度,不保证有限轮后误差完全消失。自由表面邻居少,固体边界会截断核支持域,不能把这种估计偏差都理解为水真的变稀。边界粒子或虚拟采样 ghost samples 用额外样本补充被截断的邻域;基于距离场的边界模型则可以用几何距离描述与固体的接触。这些处理依具体方法设计,不能任意填充真实空气区。修正移动较大时,邻域也可能需要更新。
这套流程通过密度约束近似液体的不可压缩性,没有完整离散描述流体动量变化、压力和黏性作用的 Navier–Stokes 方程。与一些网格流体算法不同,最简 PBF 不要求先求解压力泊松方程,再用压力修正速度以满足不可压缩条件。黏性、涡量、表面张力与边界行为仍需额外设计。位置修正可能损失能量,也可能因耗散不足让水在容器中长期往返;可按目标加入阻尼或其他能量控制,但不能把持续振荡或快速停止一概判断为“物理正确”。
两种视角
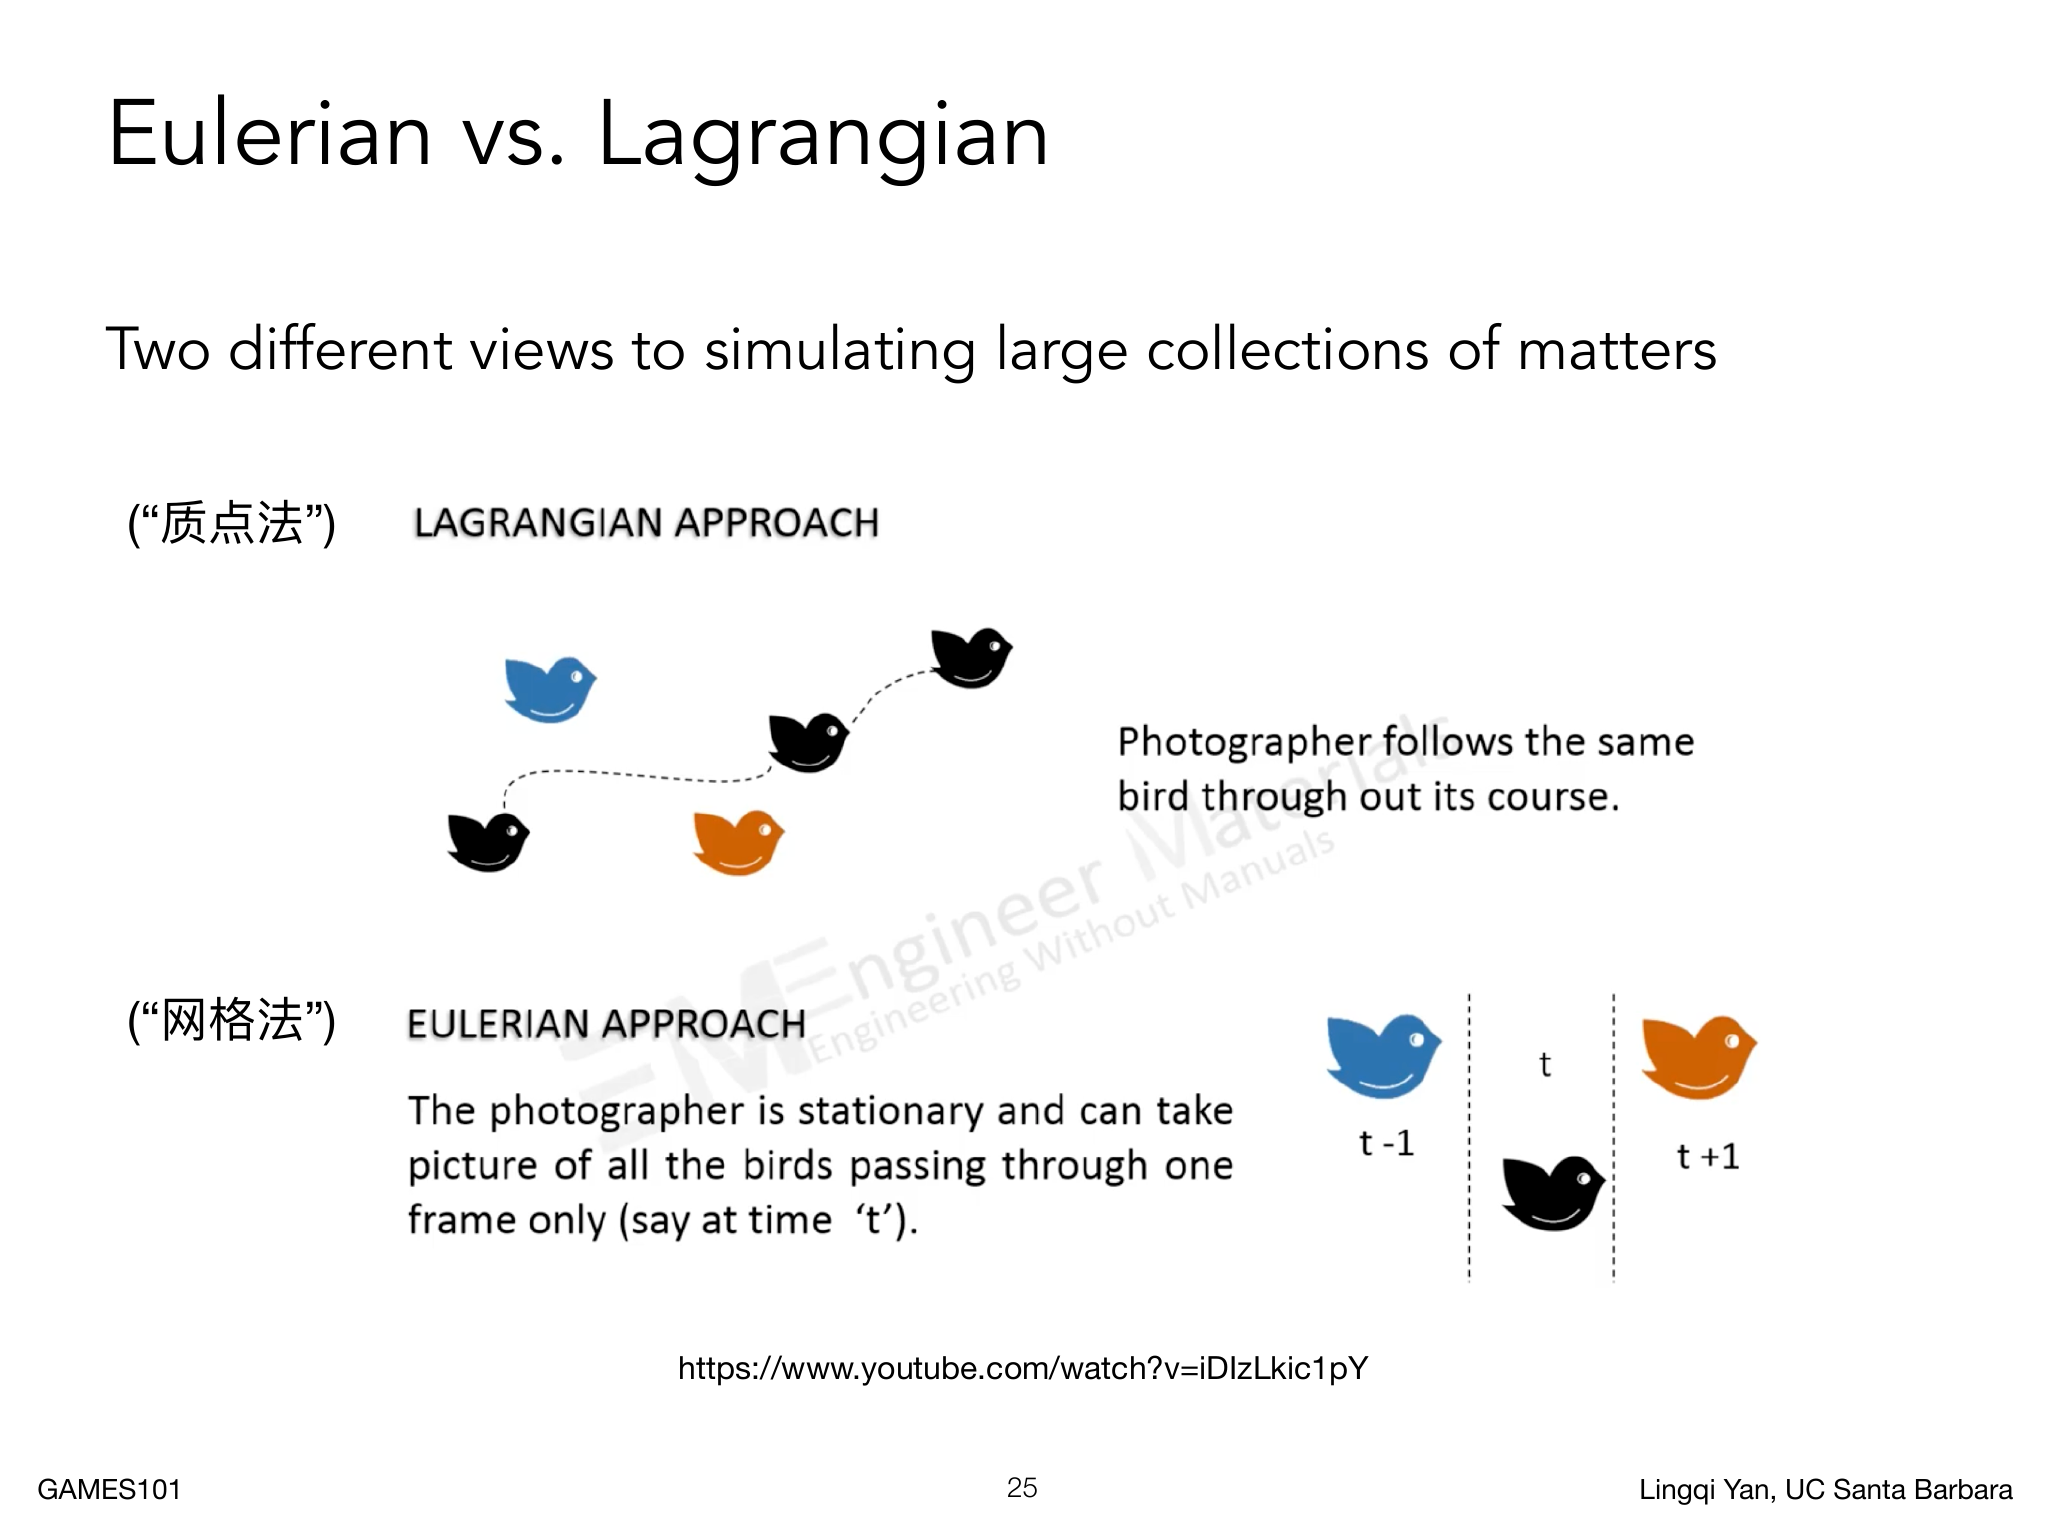
刚才表示水的方法始终在跟踪同一批粒子:每个粒子保存自身状态,随着物质移动。把这种组织方式推广到大量物质,就得到拉格朗日视角 Lagrangian View ,也称质点视角。
上半图一直跟随黑色小鸟,记录它经过的位置;对应粒子法,就是跟踪同一份物质,记录其位置、速度和材料属性。每个粒子有身份,邻居之间的作用也由这些物质样本计算。
下半图固定观察一个区域,不同时间可能有不同小鸟经过。对应欧拉视角 Eulerian View ,也称网格视角:将空间分成固定网格,在各位置记录速度、密度、压力等量。物质离开这个格子、进入另一个格子,记录位置仍然固定。图中的先后标注只帮助表达“经过同一位置的对象会变化”,理解两种视角不依赖鸟的具体飞行方向。
拉格朗日方法便于保存每份材料的质量、温度和形变历史,自由表面和材料身份也较自然;但邻居会变化,大变形后样本分布可能不均匀。欧拉网格便于在规则邻域中计算空间导数和进行压力等求解;但需要处理物质在网格间的对流、插值误差以及自由表面和不同材料界面的追踪。
两者描述的是同一运动,不同之处在于记录量附着在物质上还是空间位置上。以一个标量场 ϕ ( x , t ) \phi(\mathbf x,t) ϕ ( x , t ) x ( t ) \mathbf x(t) x ( t )
d d t ϕ ( x ( t ) , t ) = ∂ ϕ ∂ t + ∇ ϕ ⋅ d x d t = ∂ ϕ ∂ t + ( v ⋅ ∇ ) ϕ ≡ D ϕ D t . \frac{\mathrm d}{\mathrm dt}\phi(\mathbf x(t),t)
=\frac{\partial\phi}{\partial t}
+\nabla\phi\cdot\frac{\mathrm d\mathbf x}{\mathrm dt}
=\frac{\partial\phi}{\partial t}+(\mathbf v\cdot\nabla)\phi
\equiv\frac{\mathrm D\phi}{\mathrm Dt}.
d t d ϕ ( x ( t ) , t ) = ∂ t ∂ ϕ + ∇ ϕ ⋅ d t d x = ∂ t ∂ ϕ + ( v ⋅ ∇ ) ϕ ≡ D t D ϕ .
左侧称为物质导数 Material Derivative ,表示跟随同一份物质看到的变化。右侧第一项表示固定地点随时间发生的局部变化,第二项表示物质移动到场值不同的位置所带来的对流 Advection 变化。例如固定地点温度不随时间变,一份物质从低温区移到高温区,它沿途读到的温度仍会变化。
这里的 Eulerian 视角与前面的 Euler 时间积分是两个概念:前者决定空间中怎样存放和组织未知量,后者决定状态沿时间怎样推进。粒子法可以使用欧拉积分器,网格法也可以使用其他时间积分器。
物质点法
既然两种视角各有作用,可以让粒子保存材料信息,再借助背景网格完成计算。物质点法 Material Point Method,MPM 就采用这种混合方式。
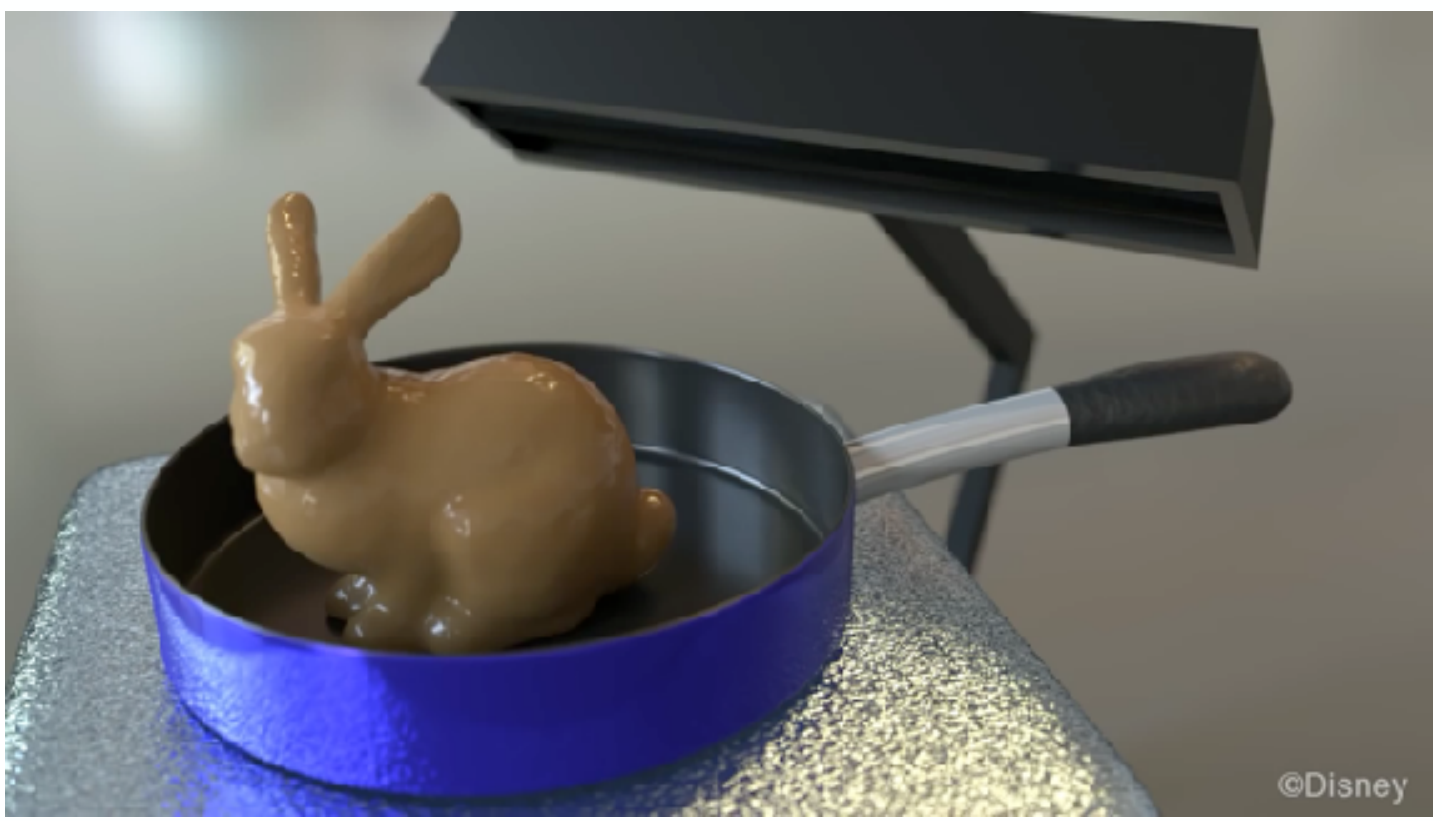
图中兔子在锅内受热软化,变化的是材料状态和形状,不能只通过刚体的整体平移旋转表达。MPM 用粒子记录同一份材料的质量、速度、体积、温度及形变历史,密度、黏性等材料属性也可随物质保存;用网格计算这一时间步的相互作用,再把更新结果写回粒子。受热软化还需要热传递及随温度变化的材料模型,单靠粒子和网格之间的转移不会自动产生融化。
核心循环包含三个阶段:粒子到网格 P2G Particle to Grid ,网格更新,再由网格到粒子 G2P Grid to Particle 。粒子继续移动,下一步的临时网格量重新清零;粒子间不需要始终保持同一套固定连接,因此适合处理较大的形变。
先看如何把粒子信息交给网格。令 p p p i i i 形函数 Shape Function N i ( x ) N_i(\mathbf x) N i ( x ) i i i
w i p = N i ( x p ) , ∑ i w i p = 1. w_{ip}=N_i(\mathbf x_p),\qquad \sum_iw_{ip}=1.
w i p = N i ( x p ) , i ∑ w i p = 1.
这里只由附近节点参与。权重和为 1 1 1
m i = ∑ p w i p m p , m i v i n = ∑ p w i p m p v p n . m_i=\sum_pw_{ip}m_p,
\qquad
m_i\mathbf v_i^n=\sum_pw_{ip}m_p\mathbf v_p^n.
m i = p ∑ w i p m p , m i v i n = p ∑ w i p m p v p n .
节点速度是收到的总动量除以总质量,不是对附近粒子速度做无权重平均。对所有节点求和时,∑ i w i p = 1 \sum_iw_{ip}=1 ∑ i w i p = 1
网格还要计算材料内力。形变梯度 Deformation Gradient
F p = ∂ x ∂ X F_p=\frac{\partial\mathbf x}{\partial\mathbf X}
F p = ∂ X ∂ x
记录一个很小的材料片段从初始坐标 X \mathbf X X x \mathbf x x det F p \det F_p det F p V p 0 V_p^0 V p 0
V p = det ( F p ) V p 0 . V_p=\det(F_p)V_p^0.
V p = det ( F p ) V p 0 .
本构关系 Constitutive Relation 规定材料在给定形变下怎样产生内力,例如弹性体会抵抗拉伸,塑性材料可能留下不可恢复的形变。由本构和材料状态计算的柯西应力 Cauchy Stress σ p \boldsymbol\sigma_p σ p n \mathbf n n σ p n \boldsymbol\sigma_p\mathbf n σ p n
记
∇ w i p = ∇ x N i ( x ) ∣ x p , \nabla w_{ip}
=\left.\nabla_{\mathbf x}N_i(\mathbf x)\right|_{\mathbf x_p},
∇ w i p = ∇ x N i ( x ) ∣ x p ,
则常见 MPM 网格内力写为
f i i n t = − ∑ p V p σ p ∇ w i p . \mathbf f_i^{\rm int}
=-\sum_pV_p\boldsymbol\sigma_p\nabla w_{ip}.
f i int = − p ∑ V p σ p ∇ w i p .
应力乘当前体积,再乘形函数梯度,把材料局部的内力作用分配给网格节点。量纲上,压强乘体积乘长度倒数得到力;负号与内力为应变能对位置的负梯度相对应。
接下来只更新收到质量的节点:
v i n + 1 = v i n + h f i i n t + f i e x t m i , m i > 0. \mathbf v_i^{n+1}
=\mathbf v_i^n+h\frac{\mathbf f_i^{\rm int}+\mathbf f_i^{\rm ext}}{m_i},
\qquad m_i>0.
v i n + 1 = v i n + h m i f i int + f i ext , m i > 0.
重力等属于外力;固体边界、摩擦与碰撞也在相应阶段处理。没有粒子覆盖的节点质量为零,必须跳过,不能直接做除法。
最简单的 G2P 是按原权重读回新的网格速度:
v p n + 1 = ∑ i w i p v i n + 1 , x p n + 1 = x p n + h ∑ i w i p v i n + 1 . \mathbf v_p^{n+1}=\sum_iw_{ip}\mathbf v_i^{n+1},
\qquad
\mathbf x_p^{n+1}=\mathbf x_p^n+h\sum_iw_{ip}\mathbf v_i^{n+1}.
v p n + 1 = i ∑ w i p v i n + 1 , x p n + 1 = x p n + h i ∑ w i p v i n + 1 .
网格速度还告诉粒子周围怎样拉伸和旋转。局部速度梯度及形变更新为
∇ v p = ∑ i v i n + 1 ( ∇ w i p ) T , F p n + 1 = ( I + h ∇ v p ) F p n . \nabla\mathbf v_p
=\sum_i\mathbf v_i^{n+1}(\nabla w_{ip})^T,
\qquad
F_p^{n+1}=(I+h\nabla\mathbf v_p)F_p^n.
∇ v p = i ∑ v i n + 1 ( ∇ w i p ) T , F p n + 1 = ( I + h ∇ v p ) F p n .
I + h ∇ v p I+h\nabla\mathbf v_p I + h ∇ v p F p F_p F p F p F_p F p
转移速度的方式影响耗散和噪声。上述直接读取网格速度的方法称为 PIC Particle-in-Cell ,重复平均会损失动能。FLIP Fluid-Implicit Particle 改为读取网格速度的变化量:
v p , F L I P n + 1 = v p n + ∑ i w i p ( v i n + 1 − v i n ) . \mathbf v_{p,\rm FLIP}^{n+1}
=\mathbf v_p^n+\sum_iw_{ip}(\mathbf v_i^{n+1}-\mathbf v_i^n).
v p , FLIP n + 1 = v p n + i ∑ w i p ( v i n + 1 − v i n ) .
粒子保留旧速度,只加入网格这一时间步产生的增量,能减轻重复平均的耗散;但网格没有表示出来的粒子速度噪声也可能保留下来。因此实际方法会在耗散与噪声之间取舍。
APIC Affine Particle-in-Cell 在粒子上再保存局部速度的仿射矩阵 C p C_p C p
m i v i = ∑ p w i p m p [ v p + C p ( x i − x p ) ] . m_i\mathbf v_i
=\sum_pw_{ip}m_p\left[\mathbf v_p+C_p(\mathbf x_i-\mathbf x_p)\right].
m i v i = p ∑ w i p m p [ v p + C p ( x i − x p ) ] .
C p C_p C p
r i p = x i − x p , D p = ∑ i w i p r i p r i p T , B p = ∑ i w i p v i n + 1 r i p T , C p = B p D p − 1 . \begin{aligned}
\mathbf r_{ip}&=\mathbf x_i-\mathbf x_p,\\
D_p&=\sum_iw_{ip}\mathbf r_{ip}\mathbf r_{ip}^T,\\
B_p&=\sum_iw_{ip}\mathbf v_i^{n+1}\mathbf r_{ip}^T,\\
C_p&=B_pD_p^{-1}.
\end{aligned}
r i p D p B p C p = x i − x p , = i ∑ w i p r i p r i p T , = i ∑ w i p v i n + 1 r i p T , = B p D p − 1 .
D p D_p D p B p B_p B p ∑ i w i p ∥ v i − v p − C p r i p ∥ 2 \sum_iw_{ip}\|\mathbf v_i-\mathbf v_p-C_p\mathbf r_{ip}\|^2 ∑ i w i p ∥ v i − v p − C p r i p ∥ 2 ∑ i w i p r i p = 0 \sum_iw_{ip}\mathbf r_{ip}=0 ∑ i w i p r i p = 0 D p D_p D p
1
2
3
4
5
6
7
8
9
对每个时间步: 清零背景网格的质量、动量和力 P2G:按形函数转移粒子质量和动量 根据形变、材料状态和本构计算应力,累积网格内力 对质量大于 0 的节点: 更新网格速度,处理边界与接触 G2P:按所选 PIC、FLIP 或 APIC 方式更新粒子速度 用网格速度梯度更新粒子的形变 F 推进粒子位置,保留新的材料状态
混合表示不免除时间步限制。显式更新常需满足类似 CFL 条件 Courant–Friedrichs–Lewy Condition 的要求:
h ≲ C C F L Δ x c + ∥ v ∥ . h\lesssim C_{\rm CFL}\frac{\Delta x}{c+\|\mathbf v\|}.
h ≲ C CFL c + ∥ v ∥ Δ x .
Δ x \Delta x Δ x c c c C C F L C_{\rm CFL} C CFL