计算机系统工程-02:文件系统
磁盘和文件
计算机用二进制位保存数据,8 个 bit 组成 1 字节,记为 B。文本、图片和程序最终都会编码成一串字节。1 KiB 为 1024 B,1 MiB 为 1024 KiB。操作系统管理程序使用的内存和设备,文件系统是其中负责保存、查找和组织文件的部分。
思考题:文件需要具备哪些基本特征?文件名、字节内容和长期保存分别由什么记录和设备支撑?
解答:
文件是一串有名称、可以按位置访问并长期保存的字节。目录项把名称映射到 inode,inode 保存大小、类型、权限和数据块索引。磁盘或 SSD 保存文件内容以及恢复名称关系所需的元数据;内存中的打开记录和缓存则用于当前访问。
网站的应用服务要与文件服务器、数据库、缓存、负载均衡和内容分发网络(CDN)共同工作。先理解单台机器怎样保存文件,有助于理解后面的分布式文件系统。
文件是一串有名字、可以长期保存的字节。应用可以读取一段内容、追加数据或修改属性。磁盘驱动按扇区编号读写,文件系统负责从名称和文件偏移找到数据所在的位置,并记录空间分配和访问权限。
这里的长期保存需要落实到写入协议。程序写入后,内容可能先停留在用户态缓冲区或内核页缓存中;要确认断电后的保存结果,还需要按接口要求同步并处理错误。文件系统也必须保存目录、inode 和分配记录,才能在重新启动后找回内容。
读写接口
文件偏移表示从文件开头向后数多少字节,从 0 开始。offset=0 是第一个字节,offset=100 表示跳过前 100 个字节。size 是希望读取的长度。程序可以只取文件的一小段,文件系统负责找到这一段所在的磁盘位置。
思考题:磁盘驱动按扇区编号读写,应用按文件名和偏移读取,二者之间需要完成哪些转换?
解答:
先从当前目录或根目录解析路径,查目录项取得 inode;再把文件偏移分成逻辑块索引 q 和块内偏移 r。inode 将逻辑块索引换成设备块号,驱动按相应扇区地址读取。跨多个块的请求还要逐块读取,并按文件中的顺序组合结果。
驱动接口可简化为 Read(sector_idx)、Write(sector_idx, data)。扇区是设备的基本读写单位,512 B 与 4 KiB 是常见例子;文件通常跨越多个扇区,且需要用字符串名字和目录组织。
READ(name, offset, size) 表示一次读取:找到这个文件,从指定位置取出若干字节。使用 POSIX 接口时,程序先调用 open(path, flags) 得到文件描述符 fd,再调用 read(fd, buf, count)。pread 可以直接指定文件偏移。
一次读取会经过应用、内核文件系统、设备驱动与存储硬件。文件系统解析名字并定位数据块,驱动执行设备 I/O,结果再返回应用。若请求跨块,文件系统要组合多个块的内容。
库函数
C 标准库用 fopen 打开字节流,返回 FILE *,常与 fread、fwrite、fclose 配合。POSIX 的 open 返回 fd,常与 read、write、close 配合。库函数通过平台的底层接口执行访问,并管理流状态和用户态缓冲区。
例如,fwrite 可能先把数据放进 C 库缓冲区,fflush 将该缓冲区提交到底层文件接口;内核页缓存里的数据还需要进一步持久化。读写接口属于哪一层,会影响缓冲、错误检查和同步方式。fopen 手册给出了标准库流接口的说明。
下面用 POSIX 接口展示一次读取。buf 是容纳四个字节的数组,n 是这次实际读到的字节数。
1 |
|
read 返回 0 表示已到文件末尾,返回正数表示实际读取量,可能少于请求长度。这里读到的是原始字节,数组中没有自动增加 C 字符串的结尾字符。要读完整个文件,可以循环读取并分别处理末尾、错误和被信号中断的情况。
常用操作
API 是程序调用某种功能的接口。调用 open 后得到的 fd 是当前进程里的一个小整数,操作系统通过它找到打开记录,记录文件对象、打开方式和当前位置。read 从当前位置读取并推进位置,lseek 改变位置,close 释放这次打开的引用。文件已经打开时,后续读写可以继续使用 fd。
| 操作组 | 常见名称 | 作用 |
|---|---|---|
| 打开与字节访问 | OPEN、READ、WRITE、APPEND、SEEK、CLOSE | 建立打开记录,访问数据,移动游标,关闭引用 |
| 同步 | FSYNC、SYNC | 请求将待写数据和相关元数据推进到稳定存储 |
| 属性与权限 | STAT、CHMOD、CHOWN | 查询属性,修改权限或所有者 |
| 名称绑定 | RENAME、LINK、UNLINK、SYMLINK | 修改目录项,建立硬链接或符号链接 |
| 目录与挂载 | MKDIR、CHDIR、CHROOT、MOUNT、UNMOUNT | 管理目录上下文、路径根及文件系统接入 |
Unix 用 lseek 移动读写位置,用 O_APPEND 等方式追加。close 关闭文件描述符;保存程序还需要按系统要求调用 fsync 等接口,让数据在断电后能够保留。chroot 改变进程看到的路径根,mount 把另一个文件系统接入目录树。
fd 通常从当前进程未使用的非负整数中选择最小值。0、1、2 通常分别用于标准输入、标准输出、标准错误输出;它们都已打开时,下一次打开往往得到 3。关闭 3 后再次打开文件,3 可以重新使用。因此 fd 的含义取决于进程当前的描述符表。open 手册规定了这个分配规则。
连续分配
设备上的扇区都有编号。假设一个扇区只能放固定数量的字节,文件超过这个大小,就要占多个扇区。连续分配让它们紧挨着,可以根据起始编号和距离直接找位置;文件增长后,后面的空间是否空闲就成为分配条件。
一种朴素方案让每个文件占一段连续扇区,直接用起始编号代表文件。
思考题:用起始扇区编号作为文件名,并让每个文件占连续扇区,怎样找到空闲空间?文件增长、字符串命名和权限检查还会遇到哪些问题?
解答:
可以用空闲位图、列表或区间记录寻找空间。文件后面的扇区被占用时,连续分配可能需要找到另一段区域并搬迁数据。字符串名称需要名称到文件对象的映射,权限检查需要保存所有者、访问权限等属性;这些记录都要与空间分配一起维护。
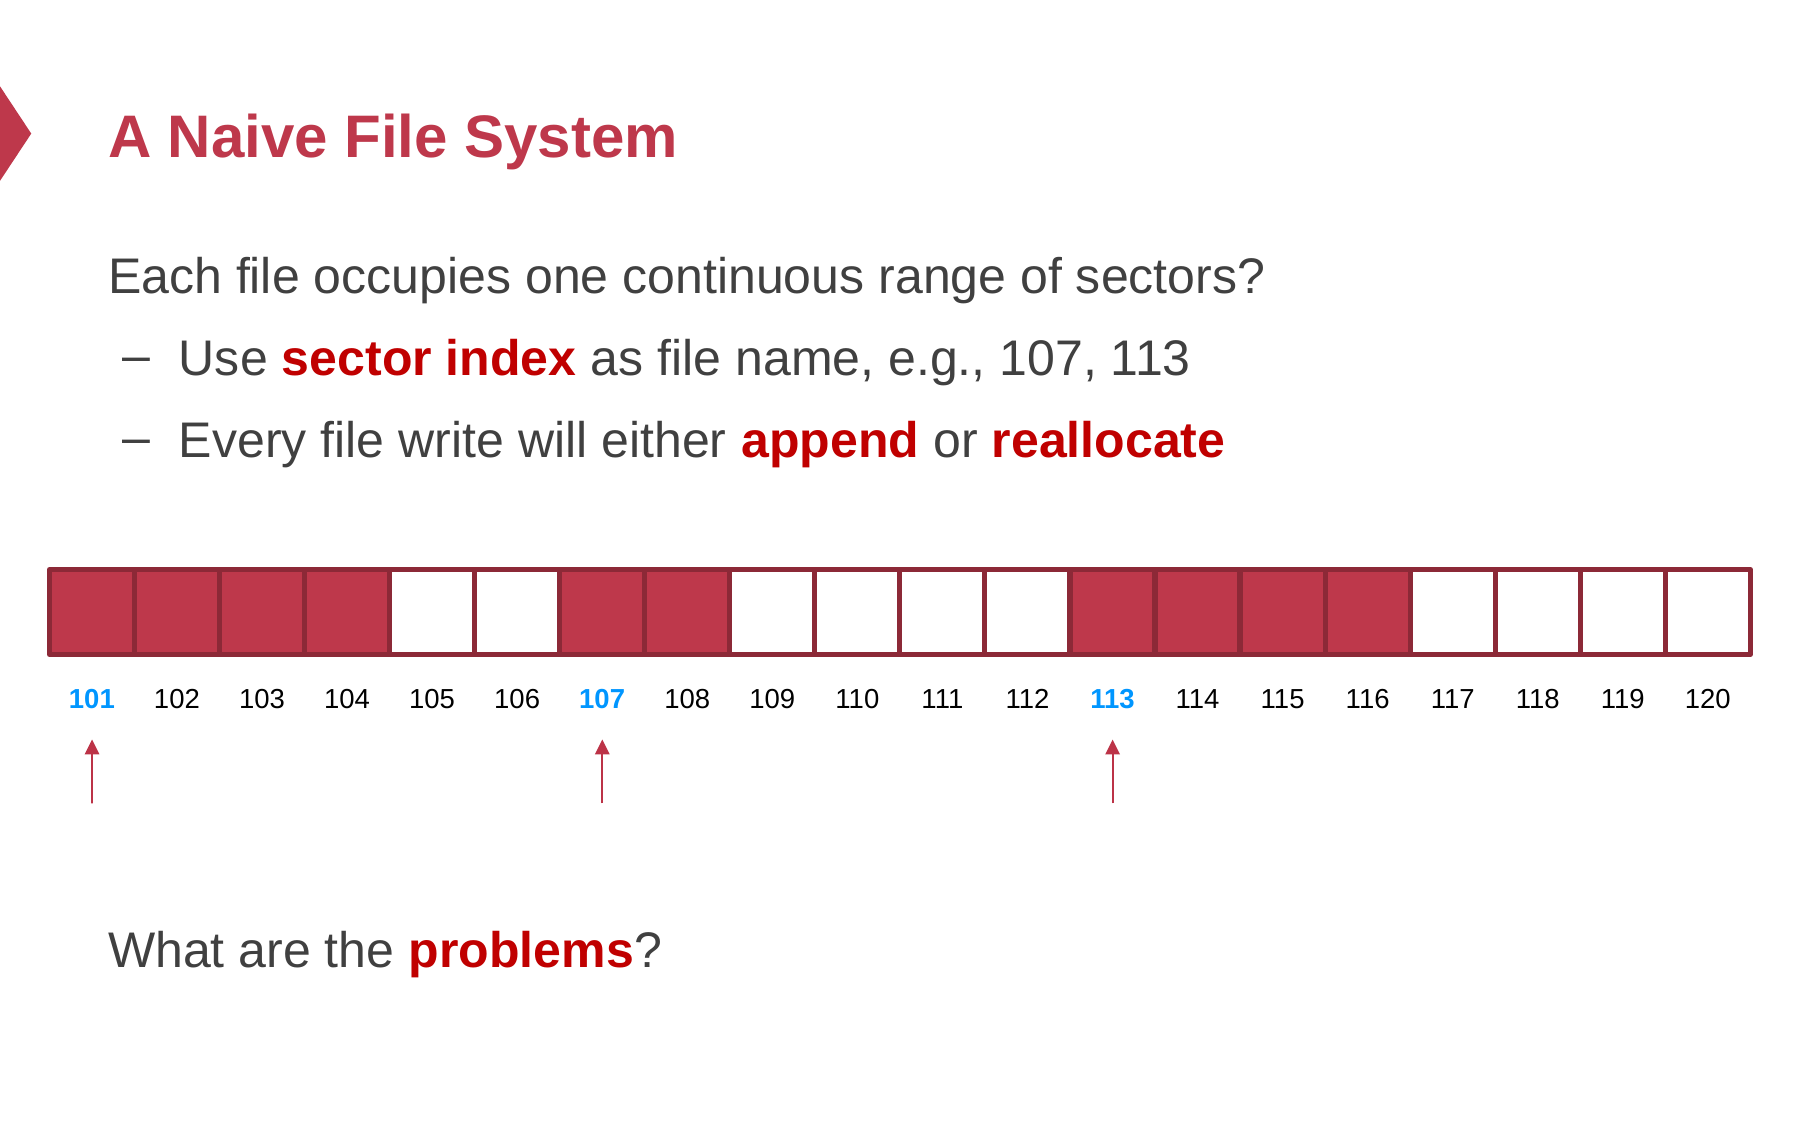
图中的三个文件从 101、107、113 开始。文件 107 已占 107、108,还能使用后面的空闲位置 109 至 112;继续增长就会碰到 113 开始的文件。其他位置即使有空闲空间,也可能没有足够长的连续区间。
系统需要记录空闲区间,找到足够长的空间。文件增长时可能要搬迁,起始编号也随之改变。此外,文件名称和权限需要另有记录。这些都是图中方案还要解决的问题。
inode 记录文件的属性和数据块位置,目录记录名称对应的 inode 号。数据移动后,系统更新块索引,文件仍可使用原来的名字。
七层命名
这里的“层”表示一次地址或名称转换。用户给出 /programs/pong.c,设备接受块号,两者之间要经过目录查找、inode 查询和文件块定位。目录项记录“某个名字对应哪个 inode”,inode 记录“这个文件的数据块在哪里”。逐层转换后,设备才能执行具体读取。
下面按 Unix V6 的七层结构介绍名称怎样逐步转换成数据位置。不同文件系统的磁盘布局有所不同,这张图用于说明各层负责的工作。
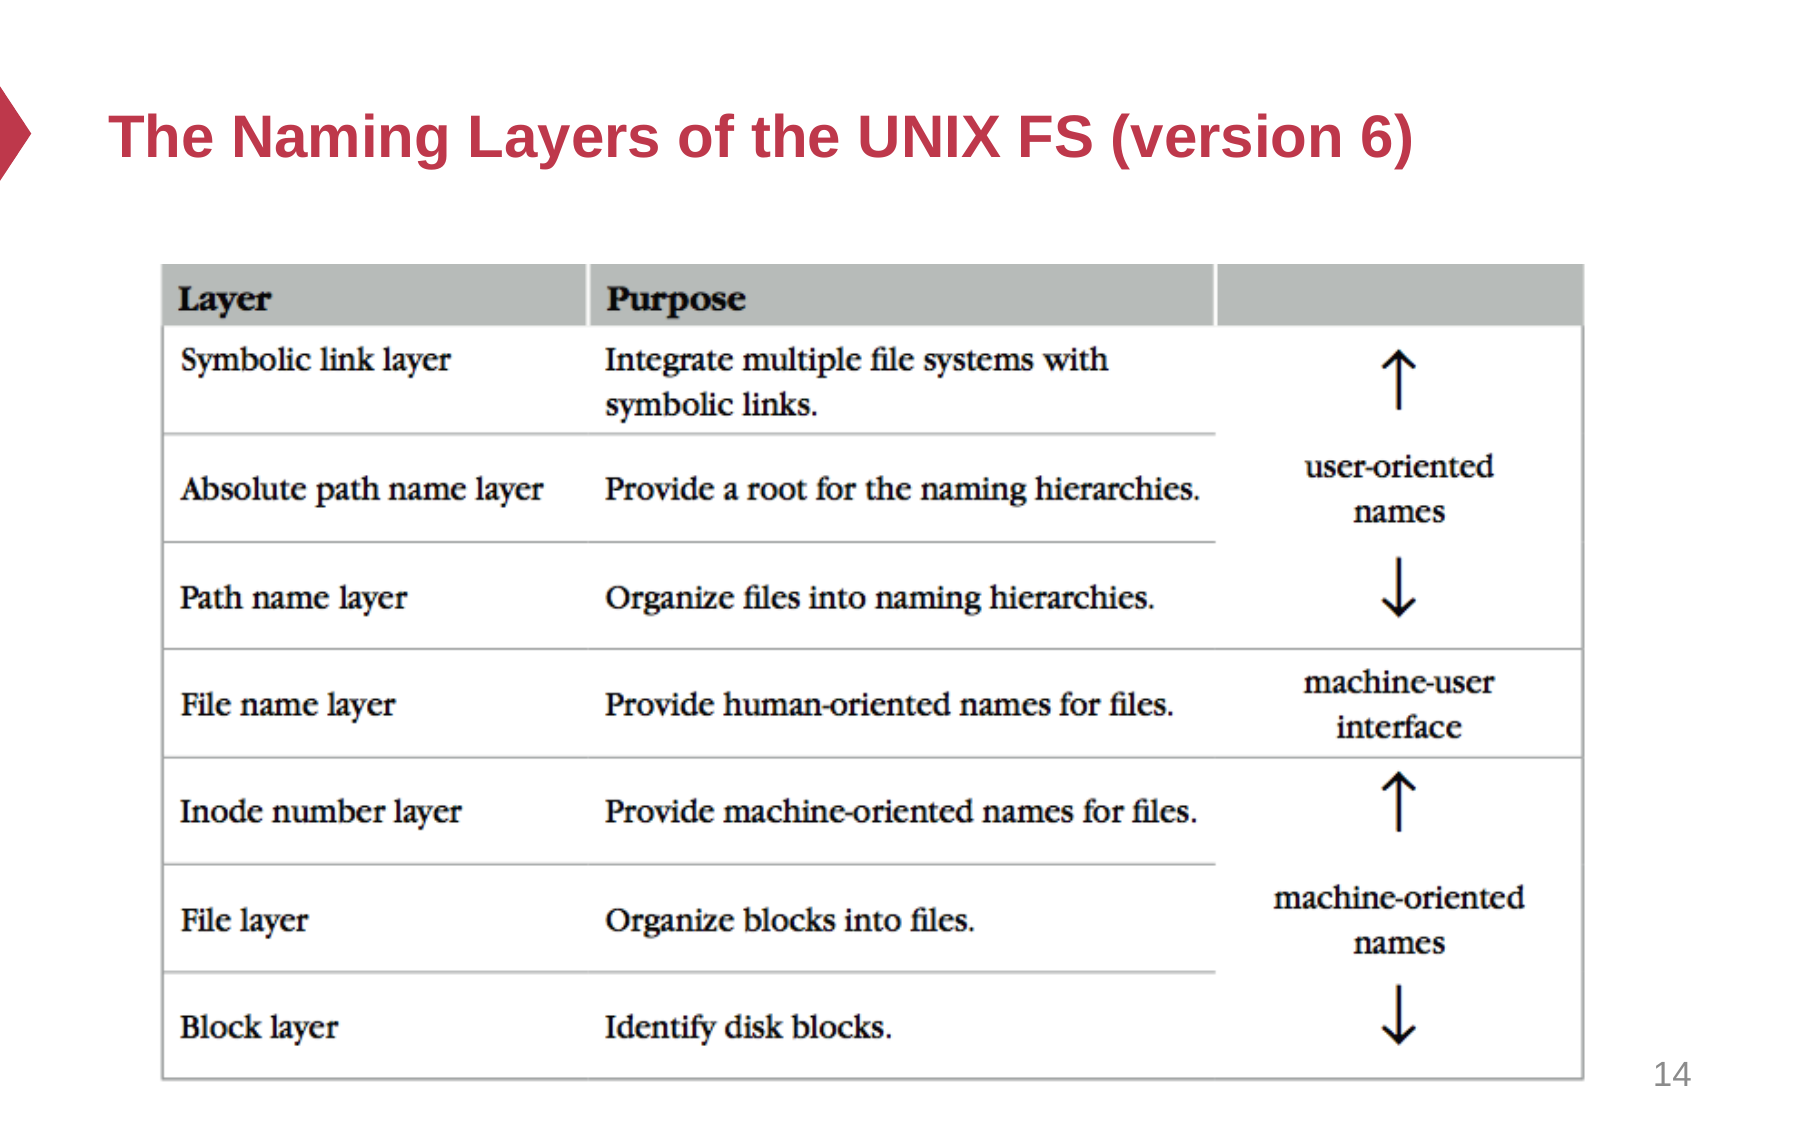
| 层 | 输入 | 输出 | 职责 |
|---|---|---|---|
| L1 块层 | 块号 | 块数据 | 定位基本存储单位 |
| L2 文件层 | inode、文件偏移 | 对应数据块 | 把多个块组织成字节序列 |
| L3 inode 编号层 | inode 号 | inode | 给元数据记录编号 |
| L4 文件名层 | 目录 inode、单级名称 | 子项 inode 号 | 查目录项 |
| L5 路径层 | 工作目录、相对路径 | inode 号 | 连续解析目录组件 |
| L6 绝对路径层 | 根目录、绝对路径 | inode 号 | 规定路径解析起点 |
| L7 符号链接层 | 链接中的路径 | 目标路径 | 按另一名称继续解析 |
底层使用块号和 inode 号,上层使用文件名和路径。读取文件时,系统从路径开始,逐层找到编号和数据。同一个 inode 号可以在不同文件系统中出现,定位文件时还要知道它属于哪个文件系统。
块和超级块
磁盘按设备自己的单位读写,文件系统按自己的块大小管理空间。超级块保存解释整个文件系统所需的参数,例如每块多大、inode 区域在哪里。挂载是把文件系统接入当前目录树,操作系统先读超级块,才能按正确格式解释其他块。
思考题:为什么文件系统还要用“块”管理扇区?假设 4 KiB 块包含四个 1 KiB 扇区,同样的数据需要记录多少个块号?选择更大的块时,空间利用率又会怎样变化?
解答:
一个块覆盖四个扇区,同样数据量的块号数量约为原来扇区号数量的四分之一,管理记录随之减少。按整块分配时,大块也可能留下更多末块空余。例如 1 KiB 内容分配一个 4 KiB 块,剩余 3 KiB 未用于内容,利用率为 25%。
文件系统按块分配空间,一个块通常包含一个或多个设备扇区。例如,4 KiB 块可以包含八个 512 B 扇区。块越大,同样数据量需要的块号越少;按整块分配时,文件末块的空余空间也可能更多。这部分浪费称为内部碎片。
BLOCK_NUMBER_TO_BLOCK(b) → devices[b] 表示按编号 b 取得对应块。设备地址转换、请求排队和错误处理由驱动完成。
思考题:挂载时怎样知道块大小、inode 区域和空闲空间管理记录的位置?这些参数保存在哪里?
解答:
文件系统格式规定了超级块等入口的已知位置。挂载先读取这些管理记录,得到块大小、inode 区域和空闲空间结构的参数与位置,再解释其他块。空闲位图或列表记录哪些块可分配,inode 的空闲记录管理可用编号。
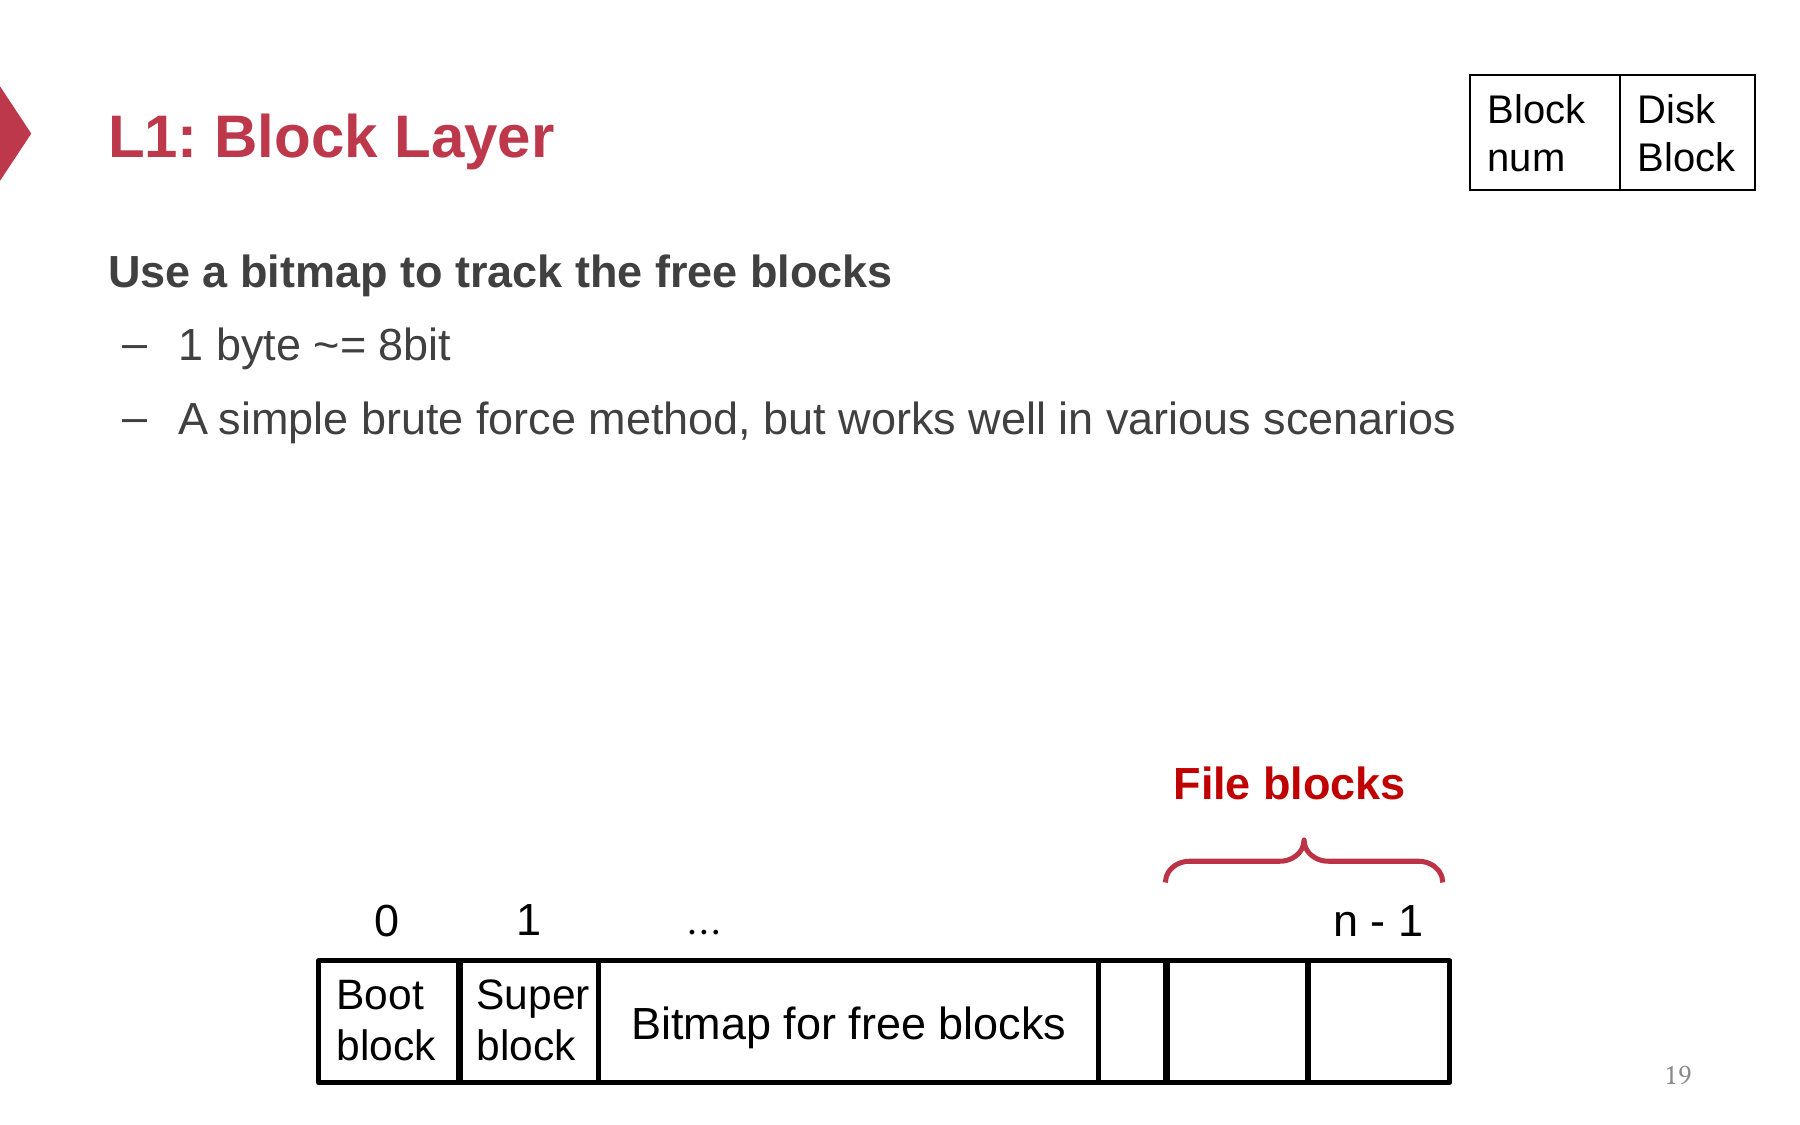
图把引导块放在编号 0,超级块放在编号 1。超级块记录块大小、文件系统规模、空闲空间和 inode 管理信息。挂载时,内核先读取这些信息,再找到其他数据区域。各区域的位置由文件系统格式规定。
再用一个 64 块的简化布局理解各区域怎样共同工作:
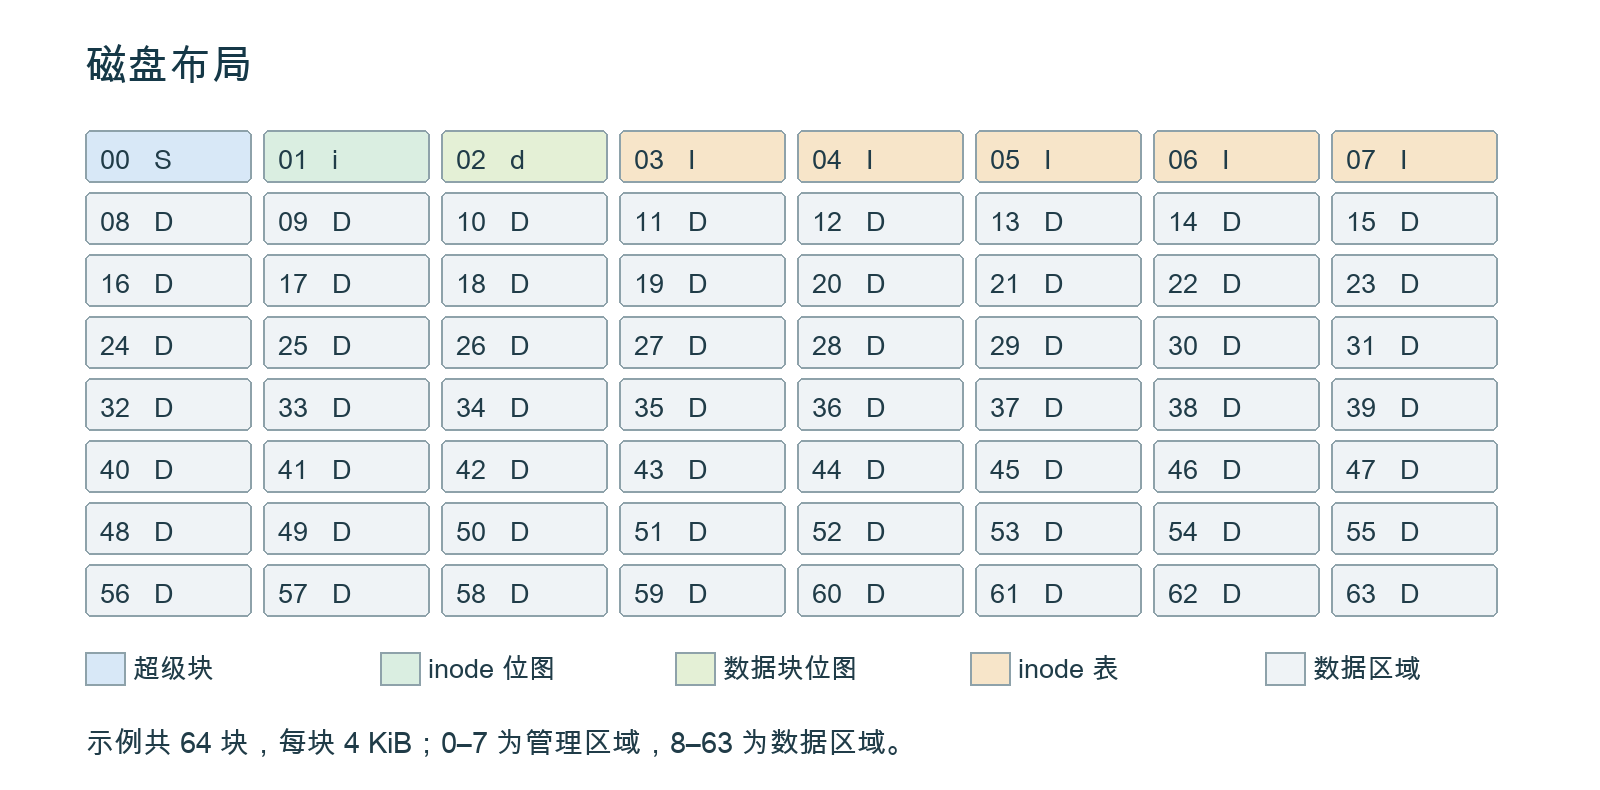
这个格式把超级块放在 0,inode 位图放在 1,数据块位图放在 2,inode 表使用 3 至 7,数据区域使用 8 至 63。每个区域的位置都是该示例格式的约定,挂载时按对应布局读取。
inode 位图管理文件记录,数据块位图管理数据空间,两种分配可以独立耗尽。若这个示例每条 inode 为 256 B,五个 4 KiB 块共容纳 条 inode,数据区域容量为 KiB。实际可创建的用户文件数还要减去根目录等已经使用的记录。
空闲位图
位图把一组是或否的状态压缩成二进制位。若第 7 位代表块 7,把它设为 1 就表示块 7 已占用。分配块时必须同时维护“块已占用”和“文件引用了这个块”两份信息,否则可能出现两个文件使用同一块,或空间被占用却找不到所属文件的情况。
位图用一位表示一个块的分配状态。一字节能表示八个块。假设有 个 4 KiB 块,总容量为 4 TiB,则完整位图约为:
假设 0 表示空闲、1 表示已分配。分配器找到空位后将它改为 1,再把块号记入文件索引;释放这个块时,将对应位改回 0。
位图、文件块索引等更新还需要协调。若先把仍被引用的块标为空闲,它可能再次分给另一个文件;若故障后两份元数据不一致,就需要恢复机制。空闲块列表也可以记录尚未分配的块,分配器从列表中取出块号,释放时再放回。
扫描位图时,可以一次读取一个 64 bit 的字。若第 j 个字中第 k 个 bit 为空闲位,且编号从 0 开始,对应块号为 64*j+k。全为 1 的字可以直接跳过;对其余字,用按位运算找出一个空位,再在受协调的分配过程中占用它,避免两个请求同时取得同一块。
练习:文件系统有 个 4 KiB 块,每块用一个 bit 记录是否空闲。位图需要多少空间?它与这些块的总容量之比是多少?
解答:
位图大小为 bit,除以 8 得到 B,即 32 MiB。这些块共占 B,即 1 TiB。
位图与块容量的比值为 ,约为 0.00305%。这里一块对应一个 bit,换算成字节时需要再除以 8。
文件偏移
思考题:inode 应保存在哪里?如果 inode 的块号数组只能容纳固定数量的入口,文件继续增长会遇到什么限制?
解答:
inode 和索引块也保存在文件系统的磁盘空间中,通过已保存的布局记录定位。若只容纳 N 个直接数据块号、每块 C 字节,就只能直接描述 字节;例如十个 4 KiB 块为 40 KiB。可以把更多块号放进间接索引块,再用二级、三级索引扩展范围。
inode(索引节点)是一份文件管理记录。目录中保存的文件名先找到 inode 号,系统再按这个编号取得 inode。比如 inode 9 的块索引为 [61,44,15],表示文件的第 0、1、2 个逻辑块分别保存在设备块 61、44、15。逻辑块编号描述文件内的位置,设备块号描述存储设备上的位置。
这份记录还包含文件大小、类型、权限、所有者、时间戳和链接计数。文件名保存在目录项中,一个 inode 可以由多个名称指向。
设块大小为 ,文件偏移为 ,则:
是文件内逻辑块索引, 是块内偏移。文件层通过 inode 把 换成设备块号 ,再读取 中的字节。文件长度、索引范围、未分配块和 I/O 错误都要另外检查。
文件大小记录有效字节数,已分配块的总容量则可能更大。例如 5000 B 的文件使用两个 4 KiB 块,共有 8192 B 容量,第二块只需要保存最后 904 B 内容。读取到文件末尾后返回结束;扩容与稀疏文件还需要按相应分配规则处理。
多级索引
指针在这里保存一个块号。数据块存文件内容,索引块存更多块号。一级间接索引先找到一个索引块,再取出其中的数据块号;二级索引先找到另一组索引块,再从其中找到数据块。每增加一层,都能让固定大小的 inode 描述更多数据位置。
inode 空间有限。如果假设只存十个直接块号、每块 4 KiB,则只能描述 40 KiB 数据。间接块可以继续存块号,从而扩展可寻址范围。
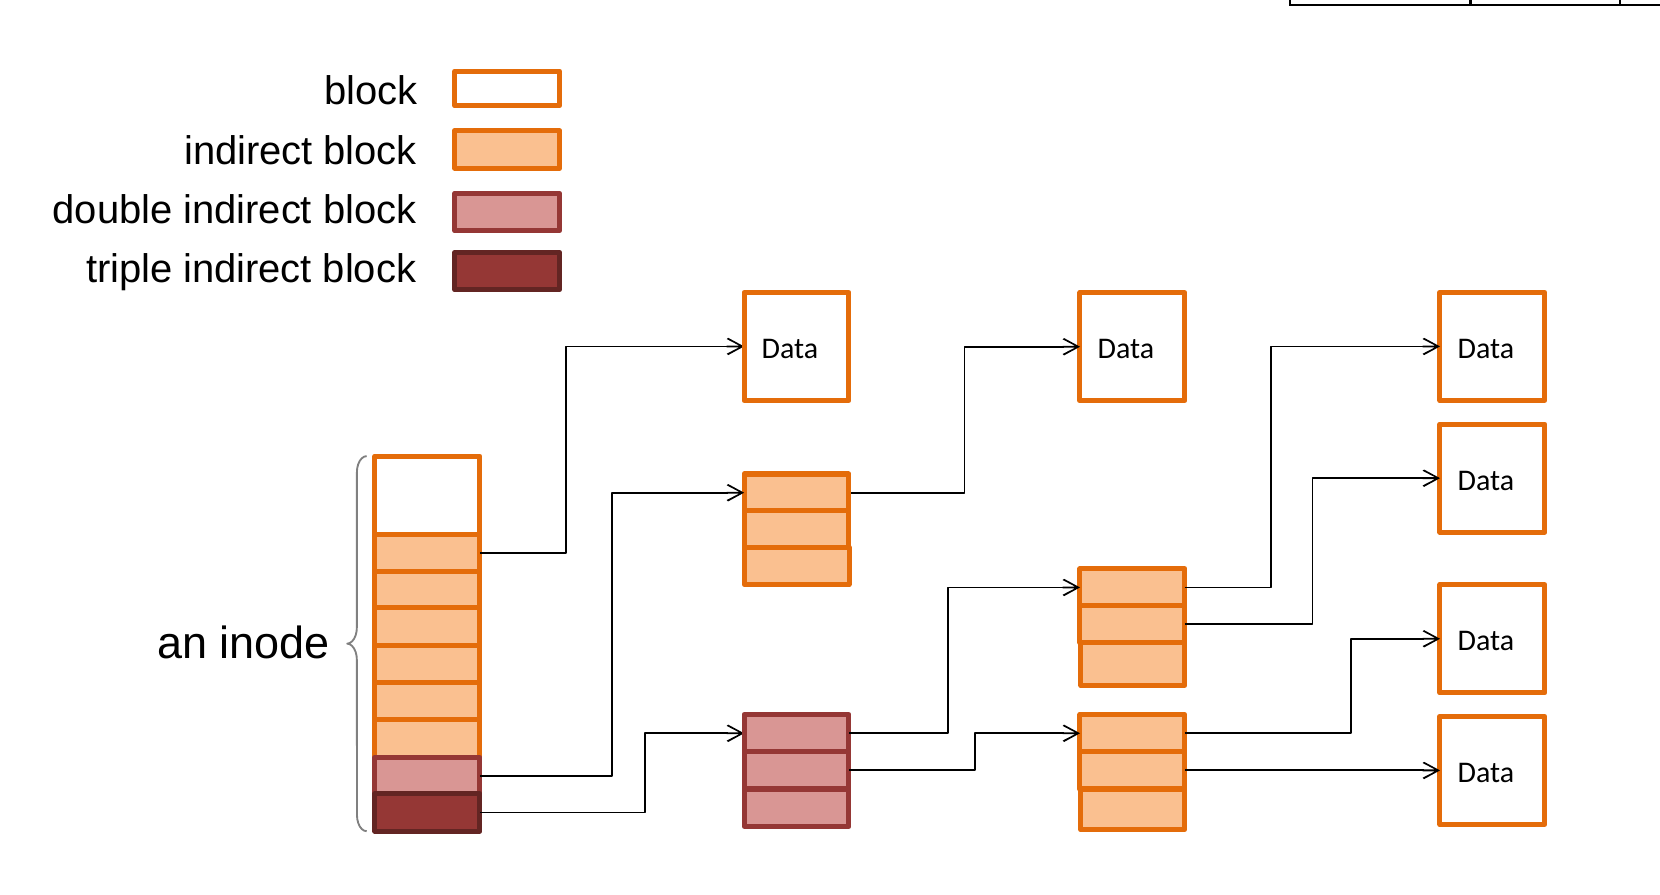
左侧是 inode,右侧 Data 框才存文件内容。直接指针一步到数据;一级间接指针先读一个索引块;二级和三级各再增加一层。索引层数越多,可描述的数据块越多,冷缓存下的定位读取也可能更多。
假设块为 4 KiB、每个块号 4 B,一个索引块可放 个指针:
| 一个入口的形式 | 可覆盖数据块数 | 本例覆盖数据容量 |
|---|---|---|
| 直接 | 1 | 4 KiB |
| 一级间接 | 4 MiB | |
| 二级间接 | 4 GiB | |
| 三级间接 | 4 TiB |
表中容量按 4 KiB 块和 4 B 块号计算。小文件可以只使用直接数据块,文件变大后再分配间接索引块。读取时还要考虑目录、inode 和索引块是否已在缓存中,这会影响实际磁盘访问次数。
再计算一种使用 8 B 块号的结构。inode 中有六个直接入口、一个一级间接入口和一个二级间接入口。一个索引块能放 个块号,因此各部分可覆盖:
| 入口 | 数据容量 |
|---|---|
| 六个直接入口 | |
| 一个一级间接入口 | |
| 一个二级间接入口 |
这八个入口本身只占 8*8=64 B,能够通过额外索引块描述约 1 GiB 以上的数据。64 B 只计算这些入口,inode 的类型、大小、权限等字段还要占空间;索引块也需要另外分配。继续增加索引层数,可以扩大寻址范围,同时增加定位过程的层次。
磁盘格式决定块号与 inode 字段的长度。处理器是 64 位,仍可以使用 4 B 的磁盘块号字段;计算容量时需要明确本例使用的字段宽度。
inode 编号
inode 表可以看作一组固定格式的记录。知道表的起始位置、每条记录多长和编号,就能定位记录。例如每条长 128 B,编号 9 的记录在按 0 编号的表中距离起点 B。实际格式会规定编号起点和记录布局,查找时按相应规则计算。
inode 表可以放在固定区域,以编号查表:INODE_NUMBER_TO_INODE(num) → inode_table[num]。系统也要记录哪些 inode 已使用,可以采用空闲列表或位图。其他文件系统还可能把 inode 分组存放。
前三层已经能按 inode 号与偏移访问数据,但用户需要字符串名称,下一层由目录保存这份映射。
预先划定 inode 表的格式,还限定了可用 inode 数量。创建许多空文件时,即使它们没有分配文件数据块,每个文件也需要 inode 和目录项。inode 用完后,系统无法继续创建新文件,数据区域却可能还有大量空闲。
在 Linux 上,可以分别用 df -h 查看空间、df -i 查看 inode 使用量。硬链接增加目录项而继续引用已有 inode,目录和符号链接通常需要自己的 inode。格式化时还要结合大文件、海量小文件等负载安排管理空间。
inode 的长度由格式和创建参数决定。ext4 用超级块字段记录 inode 大小,常见配置为 256 B;示意图也可以假设 1 KiB,但计算时要始终使用相应的假设。ext4 inode 文档说明了编号、大小和字段布局。
思考题:inode 表必须是一段固定的连续区域吗?设计一种其他布局,并说明怎样从 inode 号找到记录、怎样管理空闲 inode。
解答:
可以将 inode 分组存放。设编号从 0 开始、每组 G 个记录,则组号为 ,组内位置为 。布局记录给出该组的起点,结合记录长度定位 inode;每组的位图或空闲列表记录可用编号。编号到组的关系和布局信息还需要可靠保存,以便挂载和恢复。
目录查找
目录是由目录项组成的文件,例如 programs → 7。查 programs 时,系统在当前目录的内容里寻找这个名称,得到编号 7 后再访问 inode 7。路径每多一层目录,就要继续做一次这样的转换。目录中的名字由其所在目录限定,同名文件可以分别位于不同目录。
思考题:文件名到 inode 号的对应表可以保存在哪里?系统怎样用普通块存储机制读取目录内容?
解答:
名称到 inode 号的对应关系保存在目录项中。目录本身也有 inode,它指向存放目录内容的数据块。系统读取这些块,按目录项格式解析名称和编号,比较名称后得到目标 inode 号,再访问目标文件的管理记录。
目录也通过 inode 和数据块保存内容,inode 的类型标记为 DIRECTORY。它的数据由目录项组成,每项记录一个名称及其对应的 inode 号。系统按目录项格式读取这些内容。
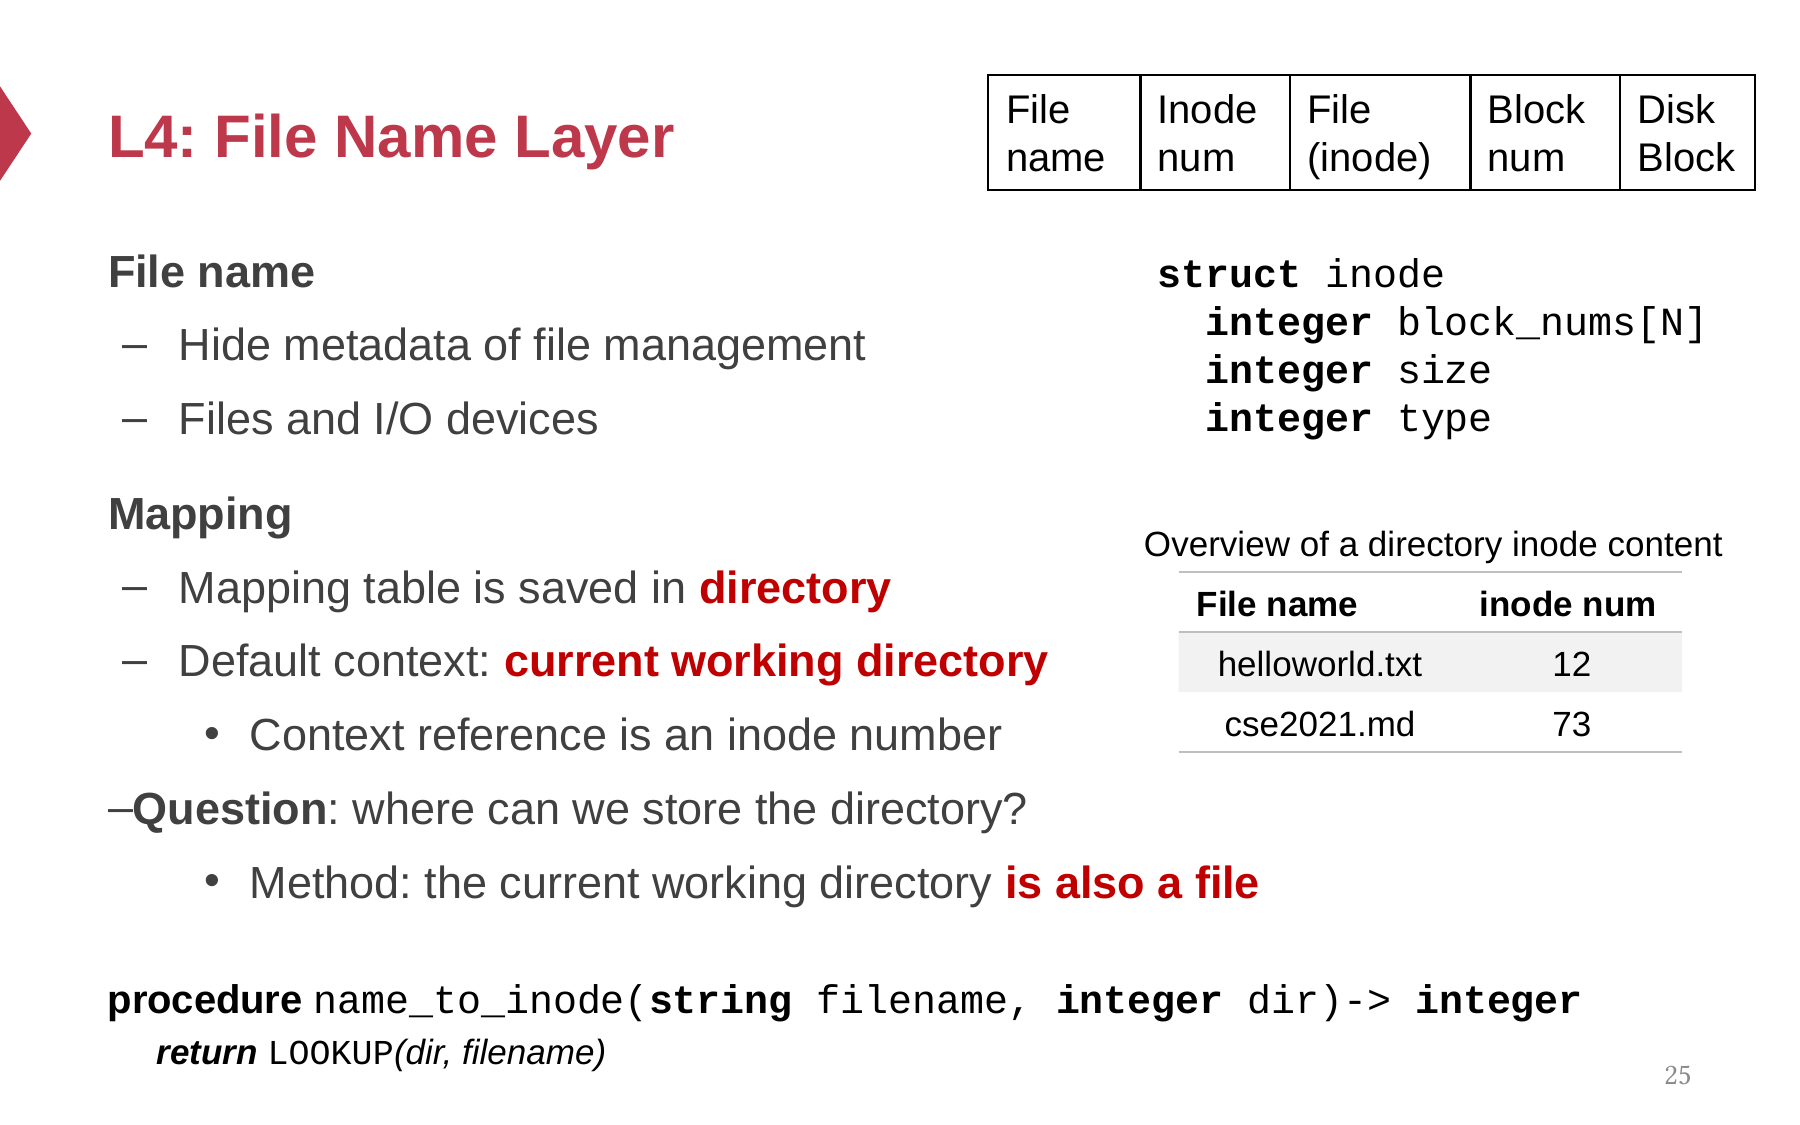
图中 helloworld.txt 对应 inode 12,cse2021.md 对应 inode 73。查找后者时,系统先确认当前 inode 是目录,再读目录块并逐项比较名字。找到后,用 73 查询 inode 表,取得文件大小和数据块索引。在另一个目录中,同样的名字可以对应另一个文件。
思考题:Unix V6 的文件名最多占 14 B,这个限制由什么布局决定?按字节计数有什么含义?目录中有很多文件时,逐项扫描会出现什么问题?
解答:
V6 一个目录项占 16 B,其中 inode 号占 2 B,名称空间剩 14 B。限制按编码后的字节数计算;假设用 UTF-8,四个常用汉字占 12 B,五个占 15 B,后者超出该空间。目录项很多时,逐项比较会增加 CPU 和磁盘读取工作,可以分目录或使用目录索引改善查找。
这里的 LOOKUP 逐项扫描目录。文件很多时,查找会变慢,可以通过分目录或建立索引来改善。Unix V6 使用固定目录项,文件名最多占 14 B;ext4 使用后文介绍的另一种格式。
目录大小
目录数据保存名称与 inode 的对应关系。增加目录项、使用更长名称,会增加所需记录空间;文件自身的内容由其 inode 与数据块保存,不放进父目录项。
思考题:一个目录里有十个 1 GiB 文件,另一个目录里有六千个空文件,哪个目录自身可能更大?文件名变长会怎样影响目录?
解答:
六千个空文件需要六千条目录项,目录自身通常需要更多记录空间。十个大文件的内容虽然总共约 10 GiB,目录只需记录这十个名称与 inode 号。
变长目录项格式还要保存名称字节和对齐填充,名称变长会增加所需空间。目录按块分配,也可能复用原有空槽,因此所需记录量增加时,已分配容量按具体布局变化。
ext4 的常见单个名称长度上限为 255 B,名称字段按字节计数。使用 UTF-8 时,一个常用汉字通常占 3 B。一个路径含有多个目录组件,各组件的名称限制与整条路径的限制分别检查。
目录转储
十六进制用 0 至 9、a 至 f 表示十六个数字,一位对应 4 bit,两位表示一个字节。0x 是十六进制前缀。小端序把整数的低位字节放在前面,例如 34 12 表示 0x1234,其十进制值为 。按这种规则读取每个字段,才能把转储字节还原成编号和长度。
使用 ls -ai temp 观察 inode 号,再用 debugfs 导出目录文件、用 xxd 查看原始字节。图中 . 的 inode 为 7536909,.. 为 7530417。
ls 显示解析后的目录信息;-a 包含通常隐藏的名称,-i 显示 inode 号。debugfs 可以从相应文件系统中导出目录内容,xxd 再按字节打印。导出的普通文件保存相同目录数据字节,它自己的 inode、类型和访问方式则由目标文件系统管理。
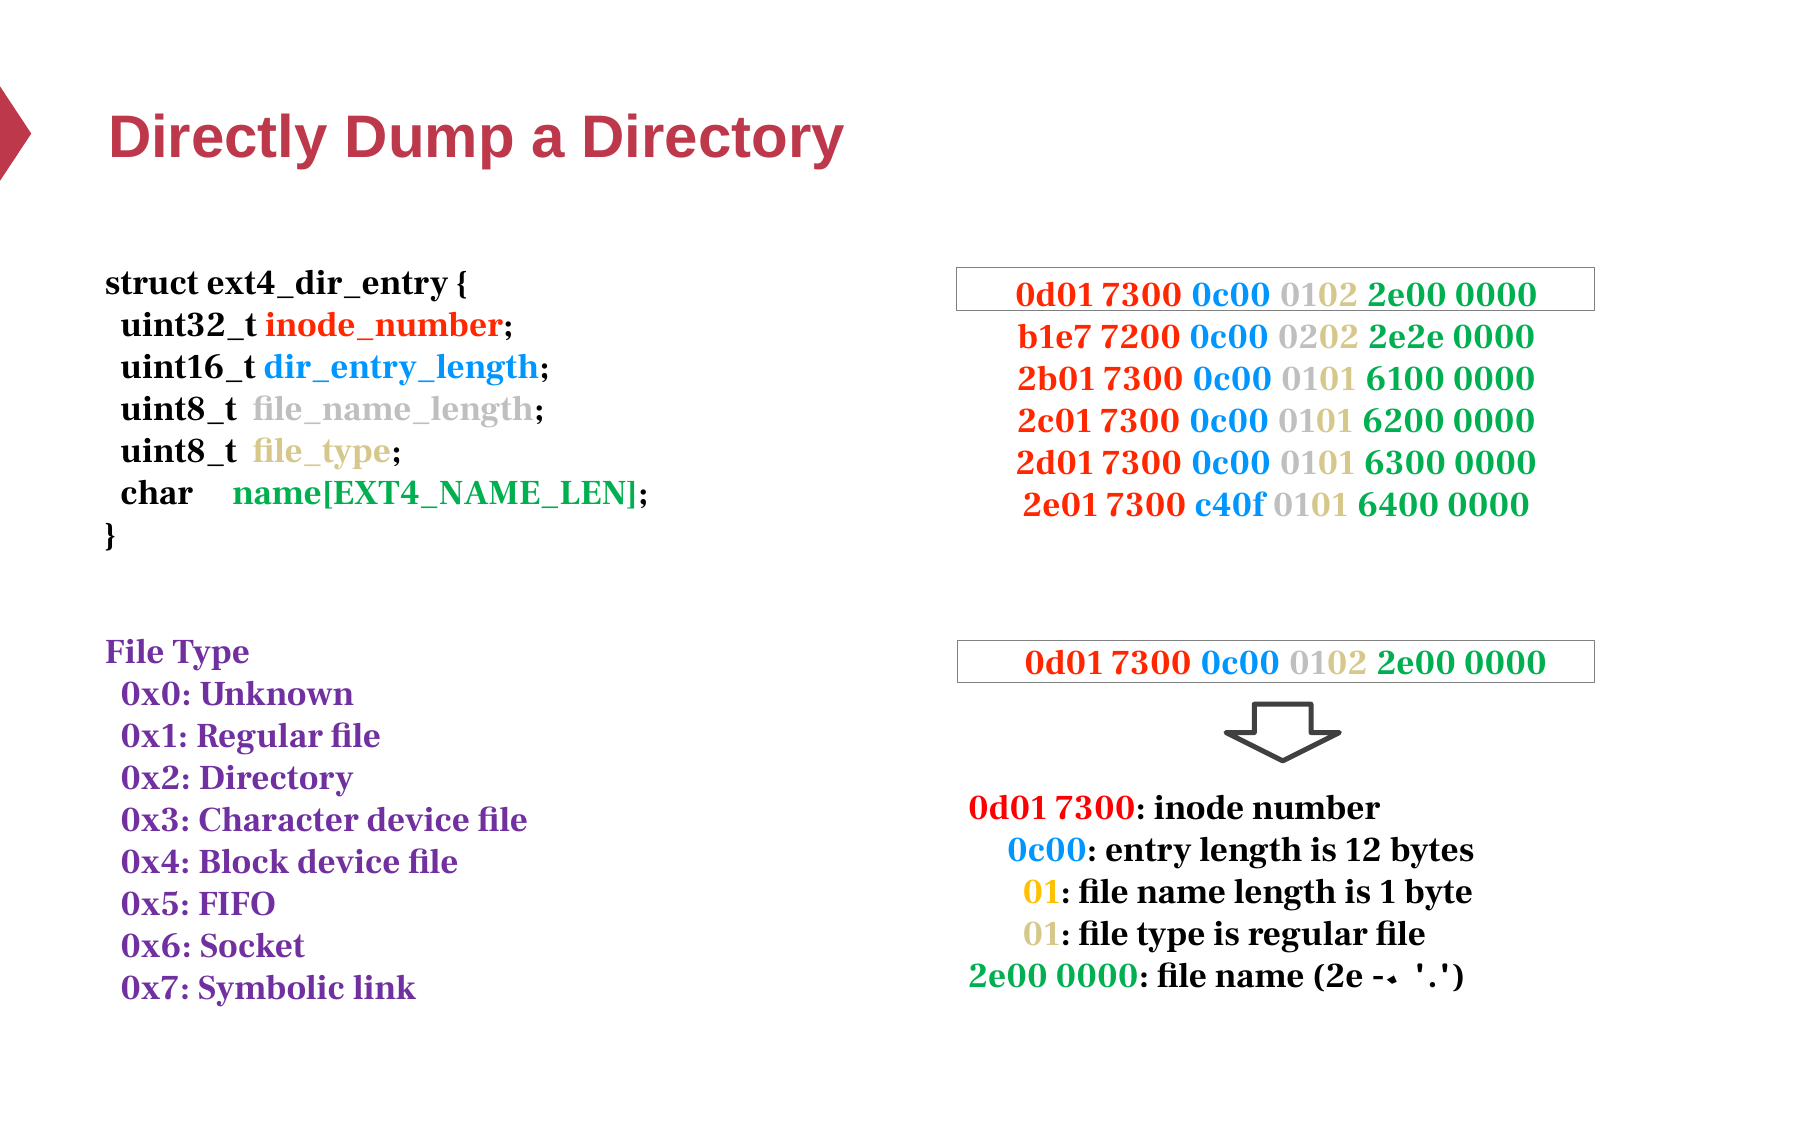
带 file_type 的 ext4 目录项可按下面字段理解:
| 字段 | 长度 | 含义 |
|---|---|---|
| inode | 4 B | 目标 inode 号 |
| rec_len | 2 B | 到下一目录项的步长 |
| name_len | 1 B | 名称字节长度 |
| file_type | 1 B | 文件类型码 |
| name | 可变 | 名称字节及必要填充 |
首项为 0d 01 73 00 0c 00 01 02 2e 00 00 00。小端解释依次得到:
- inode 为
0x0073010d = 7536909。 0c 00表示记录长度 12 B。01表示名称占 1 B。02表示目录。2e是.,余下字节为该记录内的填充。
下一项从 12 B 后开始,其 inode 字节 b1 e7 72 00 对应 0x0072e7b1 = 7530417,名称为 ..。name_len 记录名称占用的字节数,rec_len 记录跳到下一项需要跨过多少字节。
类型码 1 表示普通文件,2 表示目录,3、4 表示字符设备和块设备,5 表示 FIFO,6 表示 socket,7 表示符号链接,0 表示未知。图中首项的类型字节是 02,所以 . 对应目录;旁边的 regular file 注释需要更正。
名称 a、b、c、d 的 ASCII 字节分别为 61、62、63、64,. 的字节为 2e,.. 连续保存两个 2e。读取下一项时按 rec_len 跳转;name_len 用于取得当前名称。多字节整数按该字段的字节序解释,名称则按原有字节读取。
路径解析
路径由斜杠分隔的名称组成。/ 表示根目录,. 表示当前目录,.. 表示父目录。绝对路径以 / 开头,从根开始;相对路径从进程的当前工作目录开始。解析 programs/pong.c 时,先找 programs,再在它的目录中找 pong.c。
相对路径从当前工作目录开始查找,绝对路径从根目录开始。这个例子中,根目录的 inode 号是 1,根的 . 和 .. 都指向自身。
路径查找需要一个已知起点。挂载信息与文件系统格式确定根目录对象,开头的 / 表示选取进程看到的根。示例规定根 inode 为 1,ext4 的根 inode 通常为 2;实际解析按所挂载的格式进行。
登录后通常以 HOME 作为初始工作目录。根目录为绝对路径提供共同起点,使不同用户可以指向同一文件位置;能否访问仍由权限等规则决定。
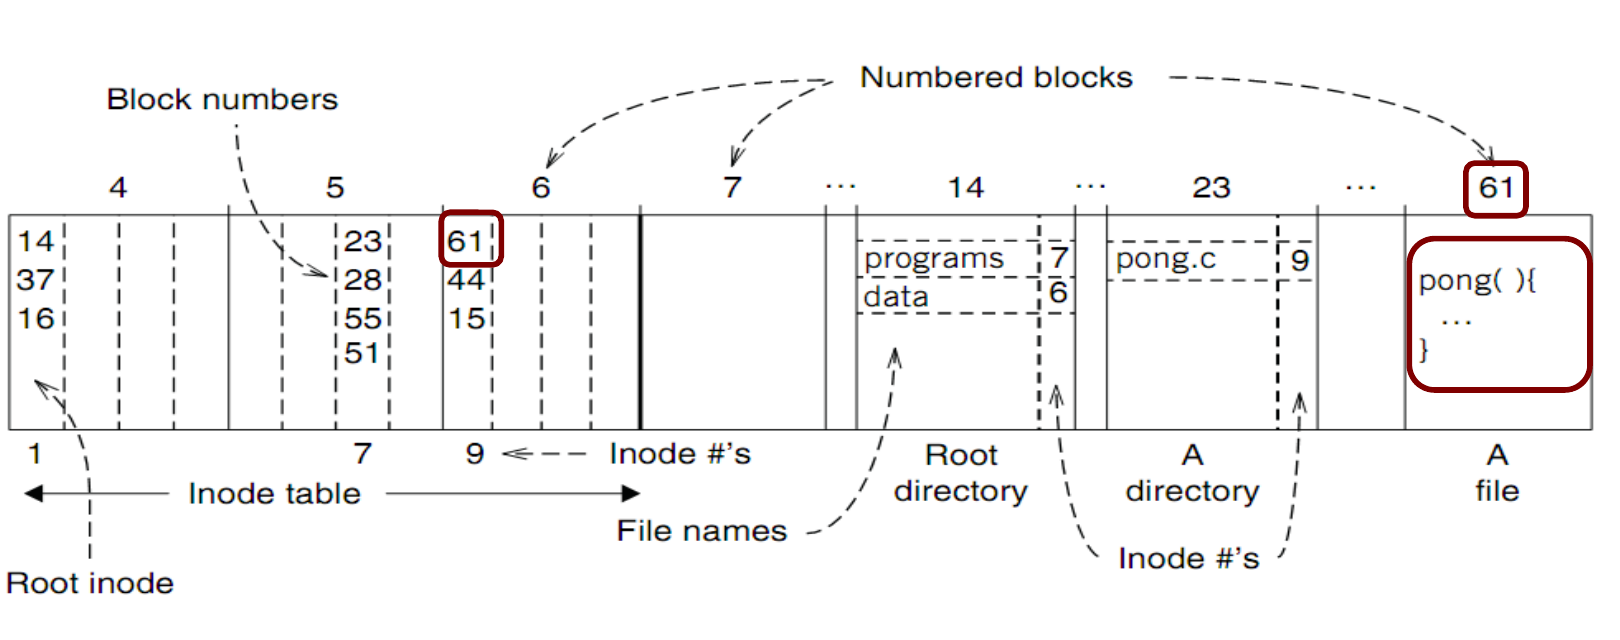
按图中的逐帧过程:
- 从根 inode 1 取得根目录块,图中先查块 14。
- 在根目录项中找到
programs,得到 inode 7。 - 读取 inode 7 所指向的目录内容,图中先查块 23。
- 找到
pong.c,得到 inode 9。 - 读取 inode 9 的大小与索引,数据块依次为 61、44、15。
- 根据文件偏移选择相应块,并在块内取所需字节。
假设每块为 4096 B,读取偏移 5000,则 、。系统读取第二个数据块 44,从块内偏移 904(从 0 计数)处取内容。虽然 61、44、15 在磁盘上分散存放,应用仍可按连续文件偏移读取。
硬链接
链接计数记录有多少目录项直接指向同一个 inode。硬链接增加一个名称,因此计数增加;unlink 删除一个名称,因此计数减少。已打开的 fd 还保留文件引用,只有名称和打开引用都不再使用这个对象时,系统才回收其存储空间。
link("a.txt","b.txt") 增加一个目录项,让两个名称指向同一 inode。两者地位相同,通过其中一个名称修改内容,另一个名称也读同一文件。
假设 inode 25 原来只有 a.txt,链接计数为 1;增加 b.txt 后为 2。执行 unlink("a.txt") 后,计数降为 1,b.txt 仍可访问。最后一个名称删除后,系统还要等已打开的文件引用释放,再回收 inode 和数据块。
硬链接通常只允许在同一文件系统内创建。系统也通常禁止用户给目录创建硬链接,以避免目录形成环。
执行 LINK("Mail/inbox/new-assignment","assignment"),给同一文件增加短名称 assignment。两个目录项指向同一个 inode,删除其中一个名称后,另一个仍可访问文件。
思考题:目录硬链接形成环后,删除根目录到 a 的入口,inode 25 的链接计数仍为 1,会发生什么?为什么删除目录前需要处理其中的文件和子目录?
解答:
环内仍有目录项指向 inode 25,所以链接计数保留为 1;根入口删除后,用户又无法从根沿路径进入这组对象,仅靠链接计数难以回收其占用。删除目录前要处理子项,避免留下无法通过目录路径管理的内容;rmdir 通常要求目录已空,递归删除则先遍历并移除子项。
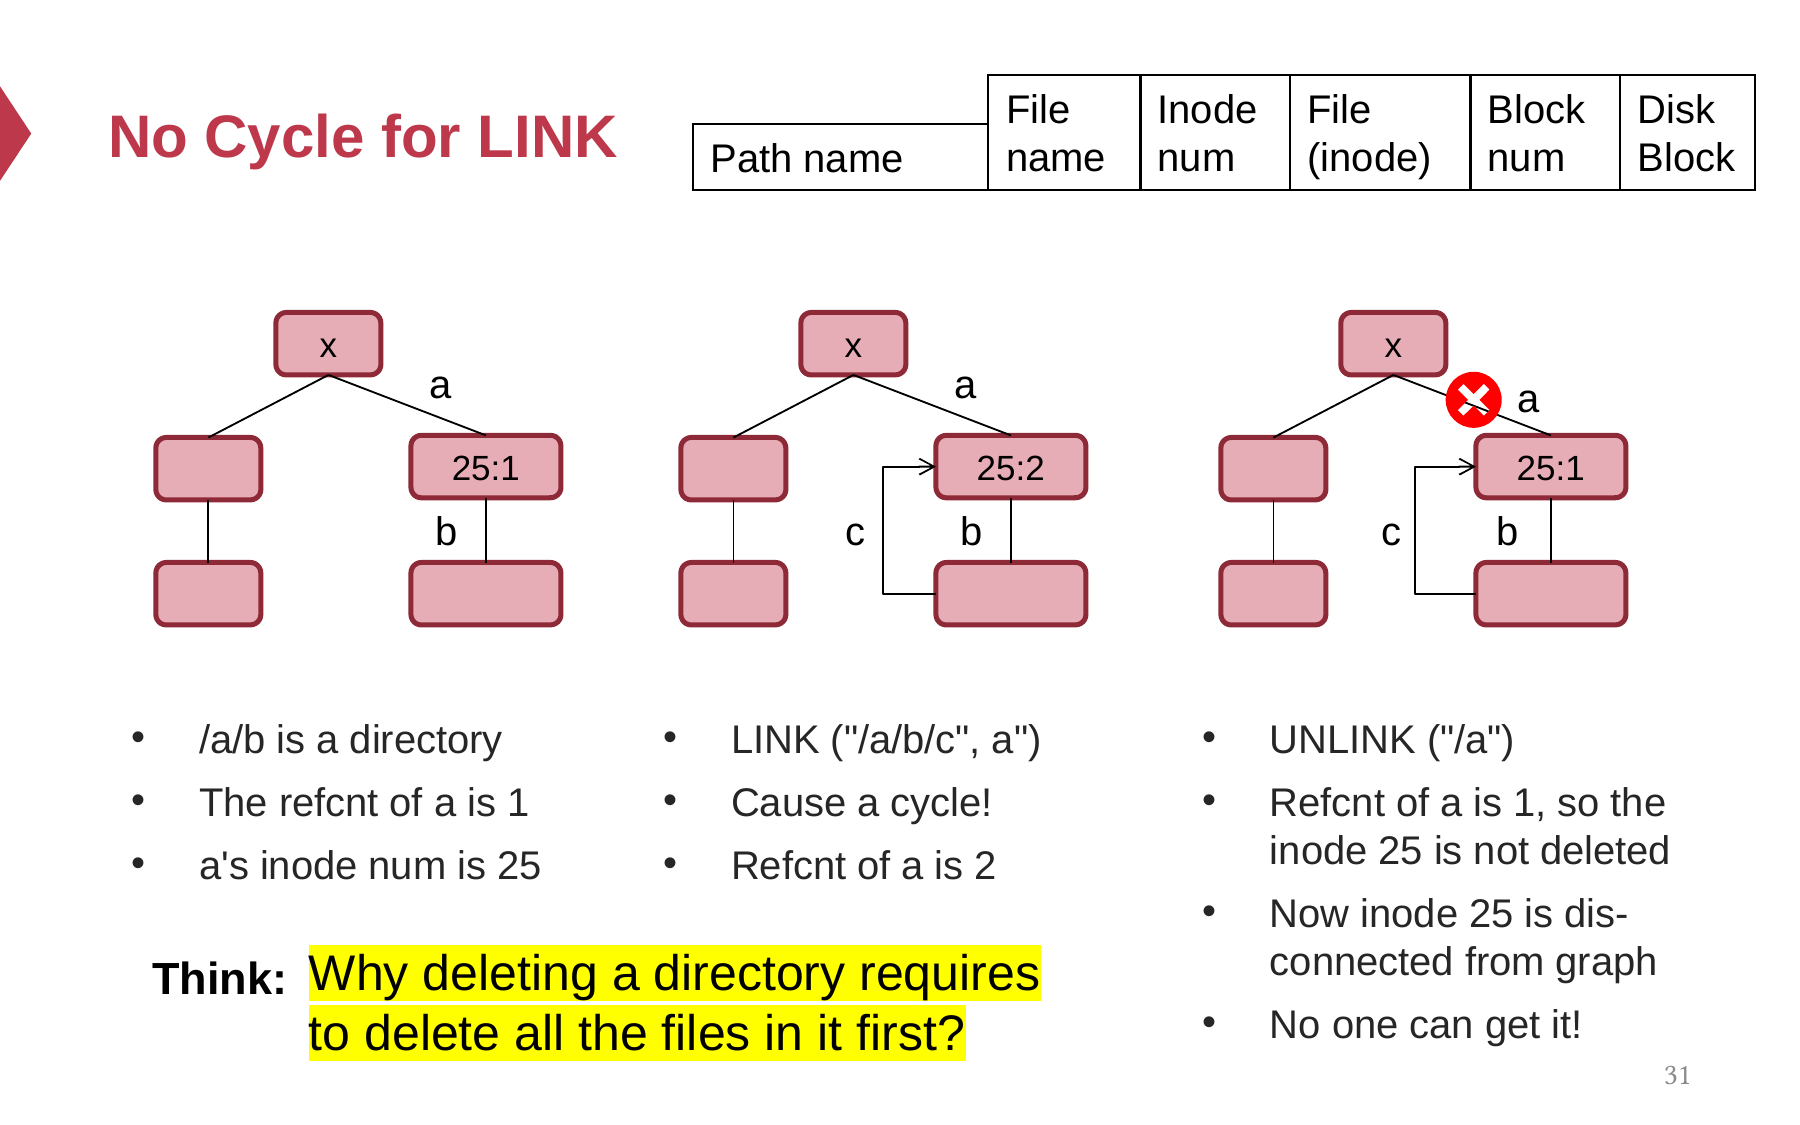
这个环的示例省略了系统维护的目录项计数,用来观察新增的环形引用。典型 Unix 目录的链接计数常为 2+直接子目录数:父目录中的名称和自身的 . 提供基本引用,每个子目录的 .. 再引用父目录。具体文件系统特性可能调整计数方式,管理这些关系的是文件系统。
重命名
保存新内容时,程序可以先写出临时文件,再让正式名称指向它。对其他程序来说,这个名称应当完整地指向旧文件或新文件。恢复还需要知道保存过程做到哪一步,因此名称替换、日志记录和磁盘同步要一起安排。
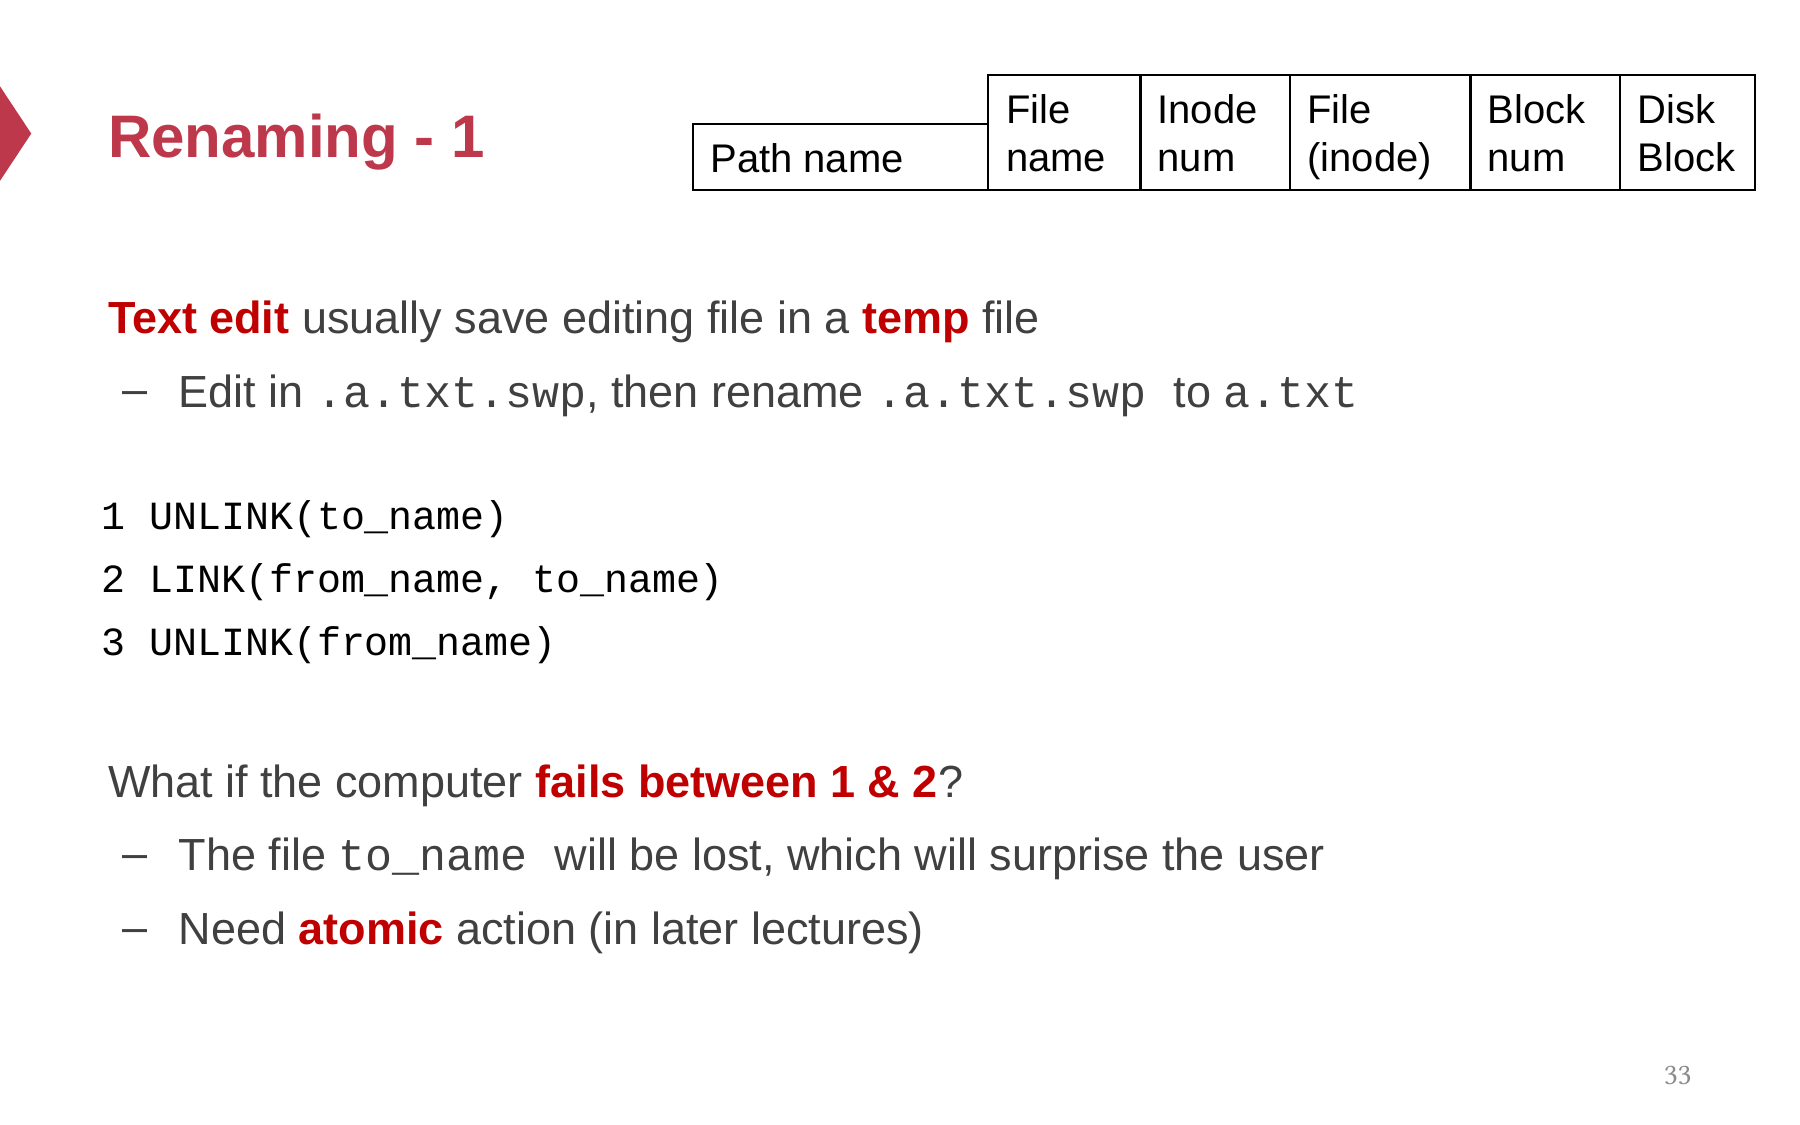
保存文件时可以使用临时名称 .a.txt.swp 和正式名称 a.txt:先把新内容写到临时文件,再用它替换正式文件。下面分析两种操作顺序。
思考题:保存时按下面的顺序替换正式文件名。
UNLINK(to_name)。LINK(from_name,to_name)。UNLINK(from_name)。如果机器在第 1、2 步之间崩溃,原路径和临时文件可能各处于什么状态?需要什么保证才能让名称替换呈现完整结果?
解答:
正式名称已经消失,临时名称可能仍在;只有临时内容和目录记录已保存时,才能据此恢复。名称替换应使用相应的原子接口,故障后保留结果还需同步文件及有关目录。目录项和链接计数的恢复过程见改名故障。
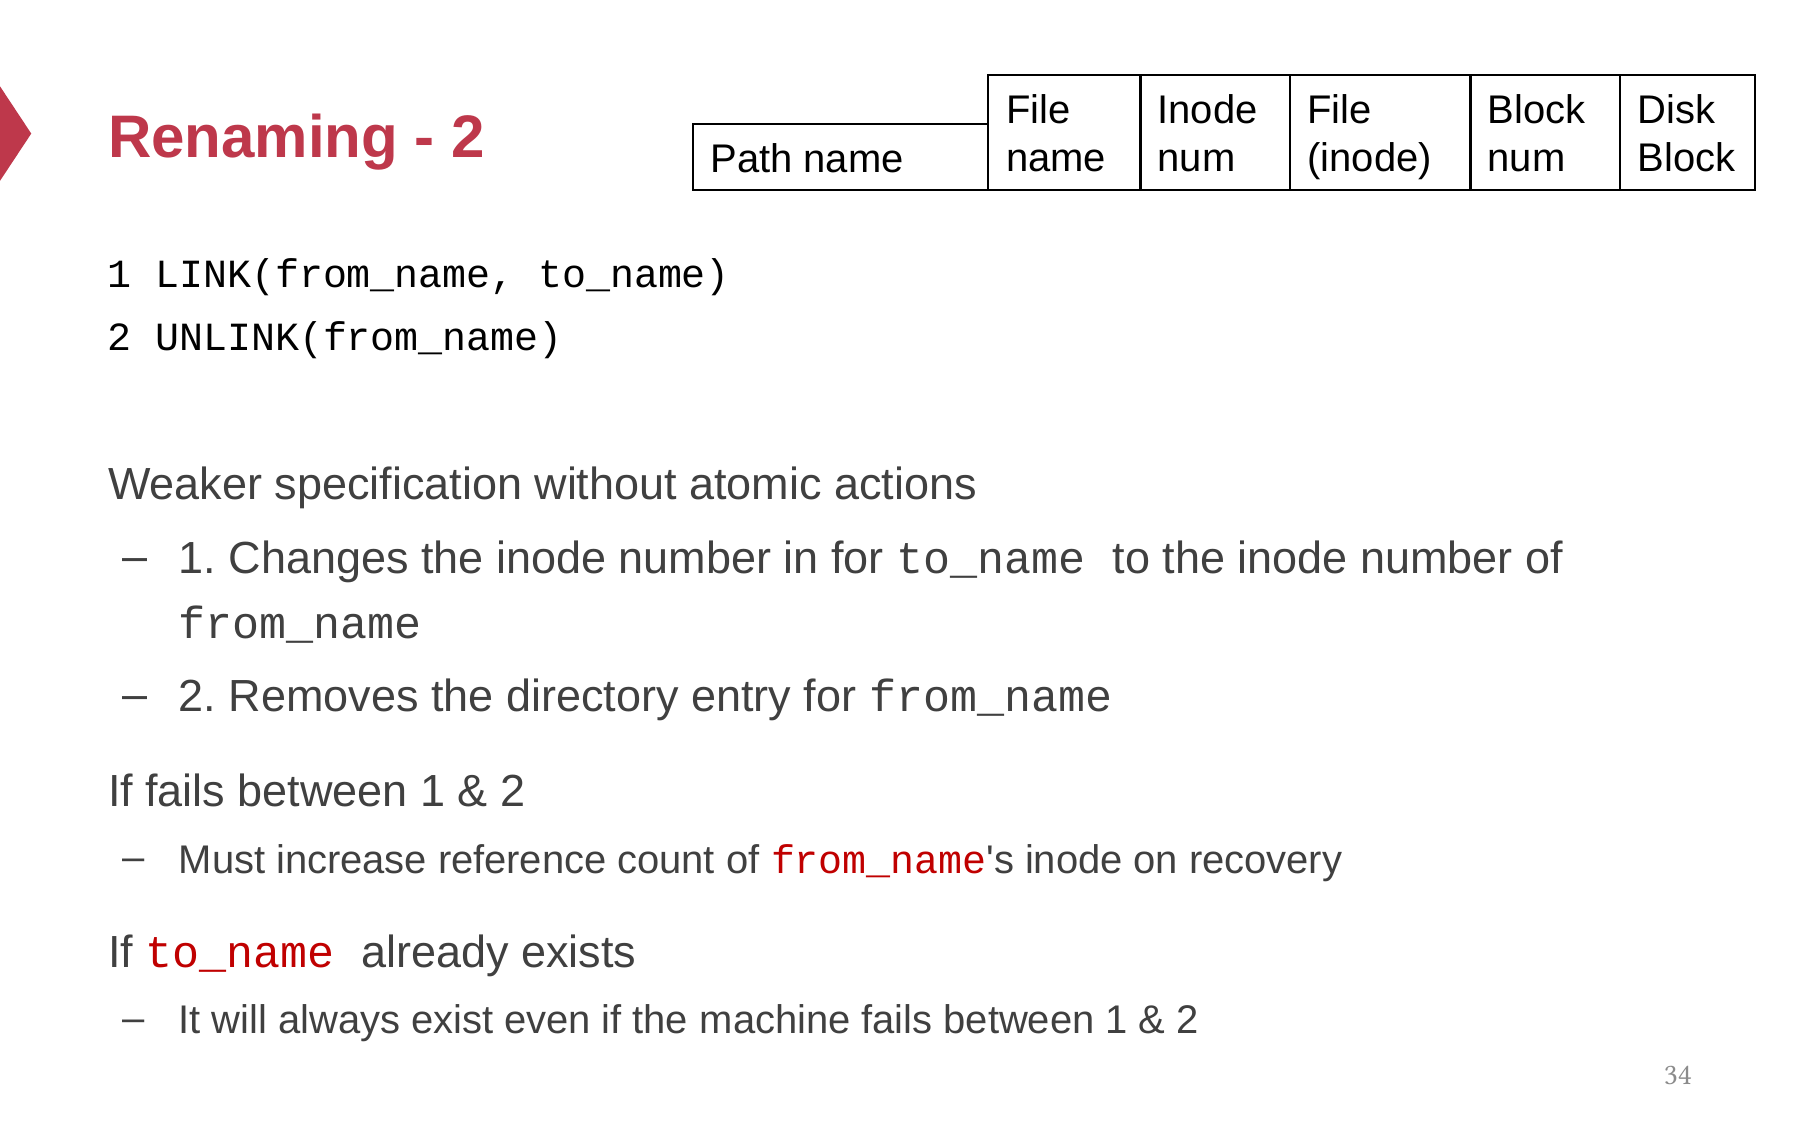
第二种方案先让 a.txt 指向临时文件的 inode,再删除临时名称。两步之间发生故障时,新文件可能同时有两个名字,恢复程序需要检查目录项和链接计数。图中的 LINK(from,to) 用于表示修改名称对应关系;实际调用 link 创建硬链接时,目标名称须尚未存在。
rename 要让其他进程看到完整的名称替换结果。要在断电后保留保存结果,程序还需要按文件系统要求同步文件和目录,并检查错误。恢复程序依据已保存的记录处理中断的操作。
练习:a.txt 与 b.txt 起初是两份不同内容,将 a.txt 移到 b.txt 并覆盖目标。若先删除 b.txt,尚未建立新名称就发生故障,重启后看到了什么?完整旧状态和完整新状态分别是什么?
解答:
完整旧状态有两份文件,a.txt 和 b.txt 各保留自己的内容。完整新状态只有 b.txt,内容为原 a.txt 的内容。
只完成删除目标这一步时,可能只剩 a.txt,旧 b.txt 已经丢失。若先原子替换 b.txt 的绑定、再删除 a.txt,中间状态又可能让两个名称指向同一新内容。要让整个改名操作恢复为完整结果,需要对应的原子更新与日志恢复机制。
符号链接
符号链接保存一段路径文字。读取链接自身,可以得到这段文字;正常打开链接时,系统把文字当作新路径继续查找。绝对目标路径从根解析,相对目标路径从链接所在目录解析。例如 docs/link 保存 ../data/a.txt 时,查找从 docs 出发,再去它的父目录下寻找 data/a.txt。
符号链接有自己的 inode,保存目标路径字符串;访问它时按字符串继续查找。硬链接则直接绑定目标 inode。
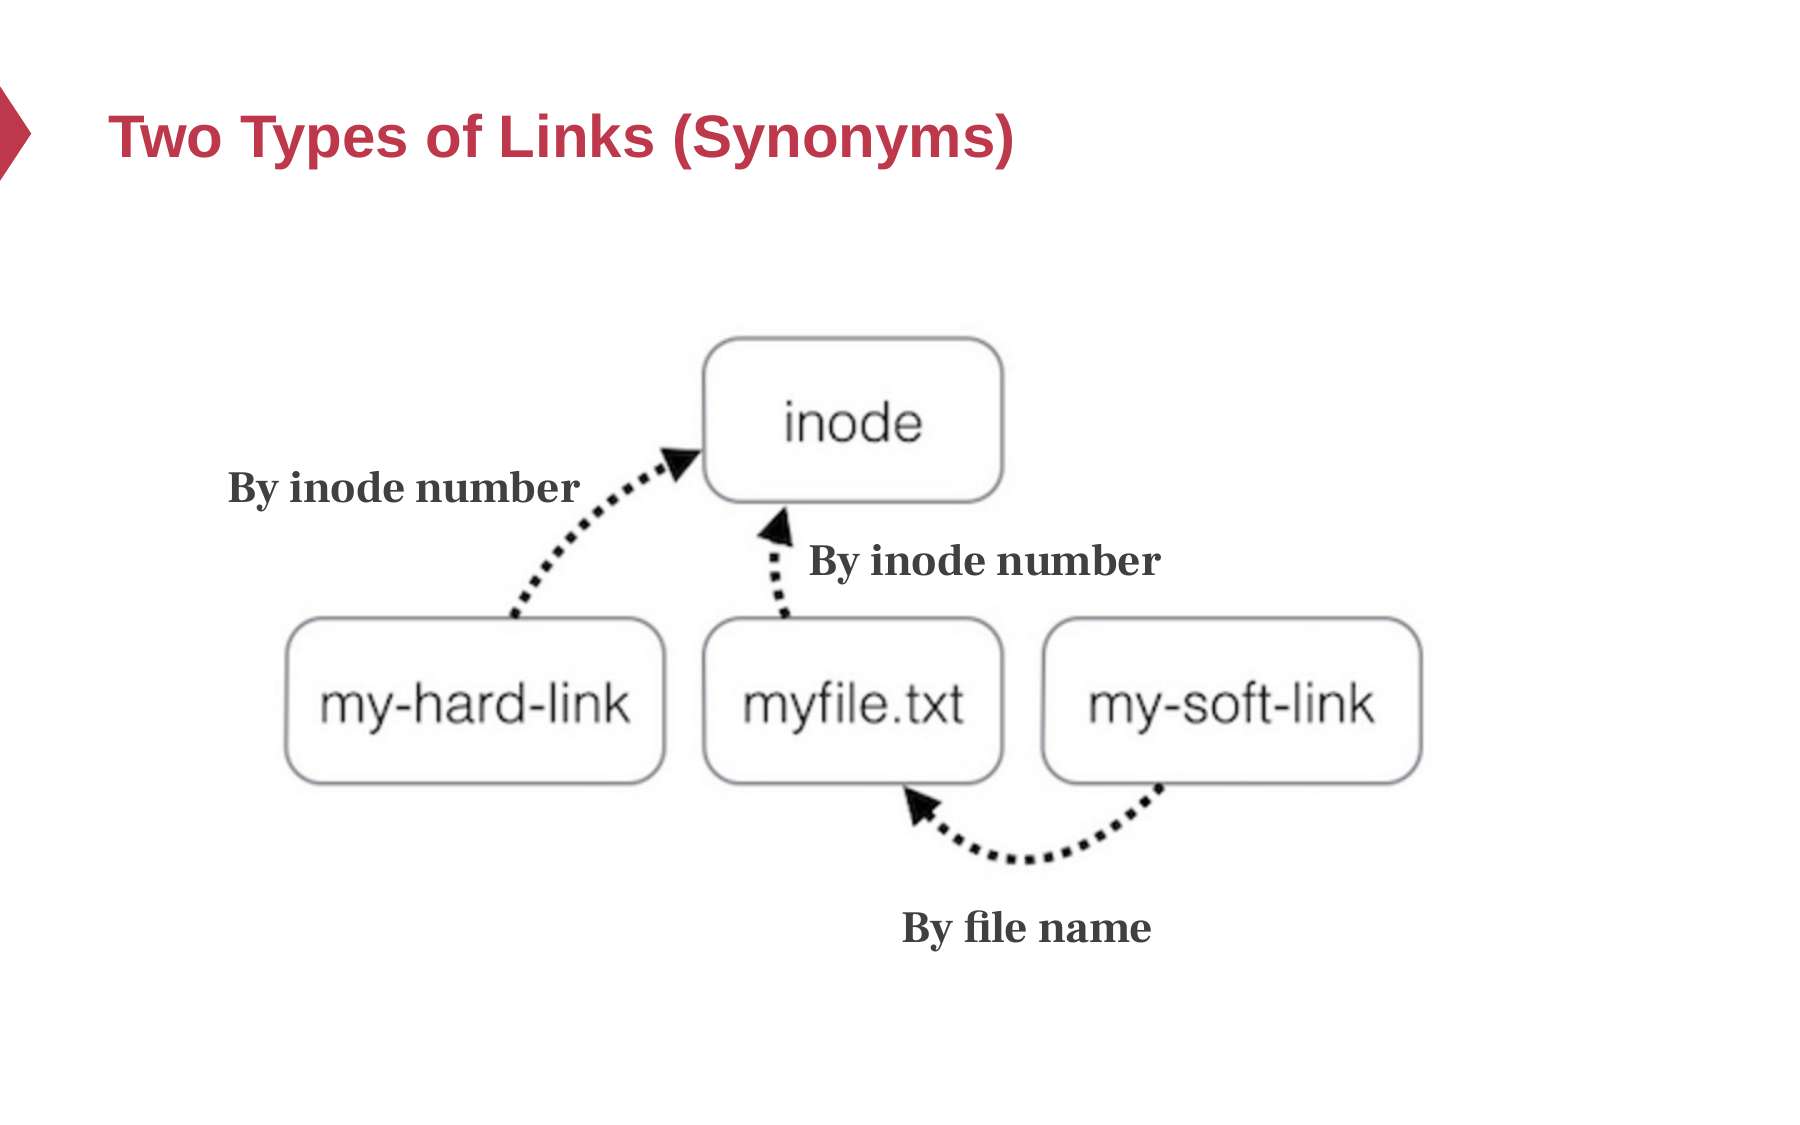
图中 myfile.txt 与 my-hard-link 都直接到同一 inode,my-soft-link 先指向目标名字。因此目标改名或消失时,符号链接可能悬空;它可以指向跨文件系统的路径,也可以指向目录。符号链接链条可能成环,解析过程必须限制遍历或检测错误。
练习:执行
ln -s /tmp/abc s-link后,ls -l显示链接大小为 8。8 表示什么?目标文件暂时不存在时,readlink s-link与cat s-link各返回什么?随后创建目标,原链接能否使用?解答:
8 是链接自身保存的路径字符串
/tmp/abc的字节数:。readlink返回这段路径;cat跟随路径找目标,目标不存在时报告找不到文件。随后在同一路径创建目标,原链接即可解析并读取新内容,链接字符串本身无需改写。
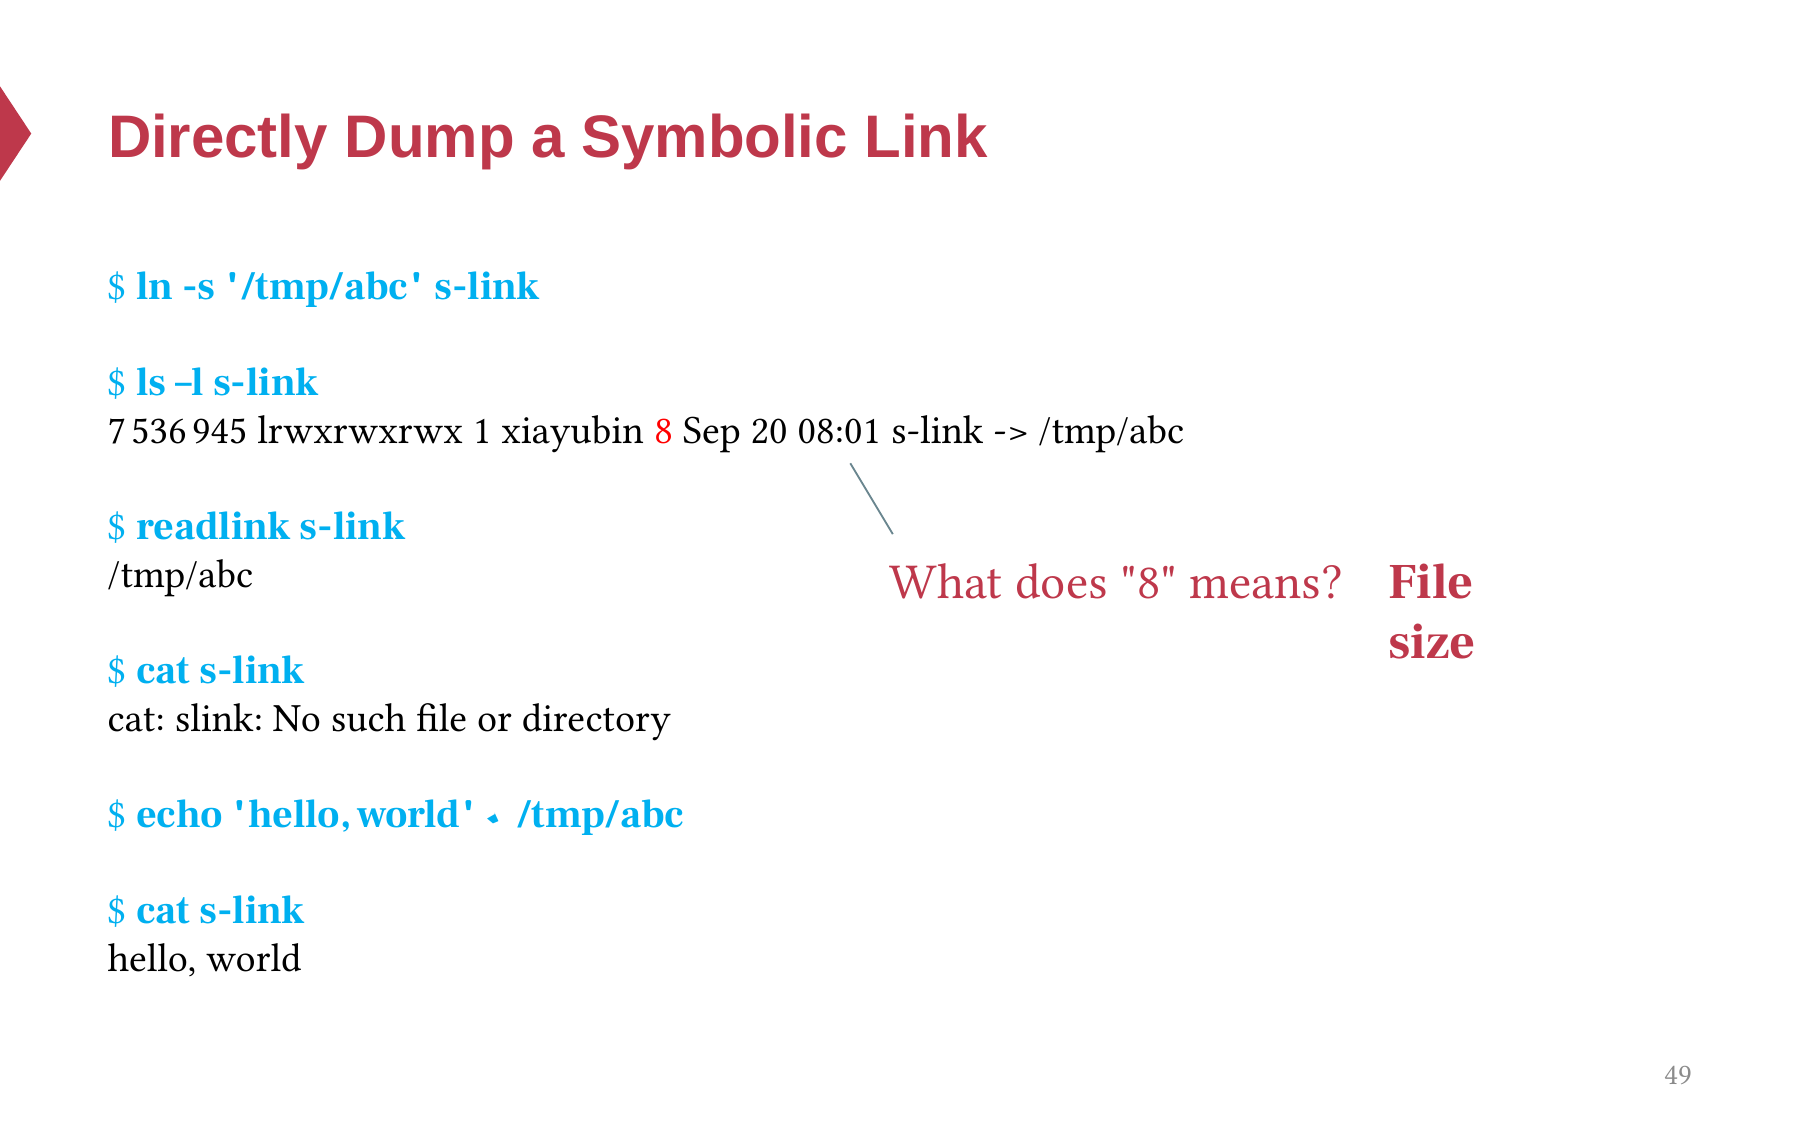
图中后来向目标写入 hello, world,再通过原链接即可读到这些字节。短路径还可以直接存入 inode;链接自身保存路径字节,其存放方式由文件系统格式决定。
路径上下文
shell 是接收并执行命令的程序,cd 修改当前工作目录,pwd 显示当前路径。逻辑路径保留用户进入目录时使用的名称;物理路径沿文件系统实际的目录关系解析。通过符号链接进入目录后,shell 可以保留链接名称,也可以展示解析后的目标路径。
练习:根目录中的
/CSE-web指向/Scholarly/programs/www。从根目录开始,使用 bash 默认的逻辑路径处理,先执行cd CSE-web,再执行cd ..,当前目录是什么?若使用cd -P ..,结果又是什么?解答:
默认逻辑路径处理保留
/CSE-web这个名称,cd ..去掉它的最后一部分,所以回到/。物理路径解析后的目录是/Scholarly/programs/www,使用cd -P ..后进入/Scholarly/programs。两次操作分别按 shell 保存的逻辑路径和实际目录关系寻找父目录。
| 操作模式 | 进入后看到的位置 | 随后进入父目录 |
|---|---|---|
逻辑路径,pwd、逻辑 cd |
/CSE-web |
/ |
物理路径,pwd -P、cd -P .. |
/Scholarly/programs/www |
/Scholarly/programs |
PWD 保存当前的逻辑路径,OLDPWD 保存上一次改变目录前的位置,用于 cd - 等操作。物理路径处理依据实际目录关系,两种表示各自保留相应上下文。
文件名
从名称到内容的关系可以逐步读:a.txt 所在目录给出 inode 号,inode 给出文件大小和块索引,块索引给出设备块号。改名改变目录项,硬链接增加目录项,修改文件内容更新数据块;这些操作修改的记录各有位置。
目录项保存文件名和 inode 号,inode 再记录文件属性和数据块位置。多个硬链接可以给同一个文件多个名字。目录保存这些对应关系,子文件的内容保存在各自的数据块中。
读取文件时,可以沿“路径 → 目录项 → inode 号 → inode → 块号 → 数据”追踪整个过程。创建、链接和删除会修改其中的记录;权限检查、缓存和故障恢复也围绕这些记录进行。
文件属性
inode 保存的数据块索引之外,还包含访问控制与时间信息。UID 表示所有者的用户编号,GID 表示所属组的编号,mode 保存类型与权限。内核结合进程的用户、所属组和打开方式检查访问。
常见权限按所有者、组成员、其他用户分成三组,每组用 r、w、x 表示读取、写入和执行,数值分别为 4、2、1。例如 755 表示所有者拥有 4+2+1=7,组和其他用户拥有 4+1=5。对目录,x 表示搜索并穿过该目录;创建子项通常还需要父目录的写入权限。
读取一个文件时,需要能穿过路径中的目录,并具备目标文件所需权限。所有者、组和其他用户的权限是相应检查条件,完整系统还会处理 ACL 等附加访问规则。
时间属性
| 字段 | 记录的时间 | 典型变化 |
|---|---|---|
| atime | 最近访问内容的时间 | 读取时按访问时间策略更新 |
| mtime | 最近修改内容的时间 | 写入或截断内容时更新 |
| ctime | 最近改变文件状态的时间 | 修改权限、所有者、链接数或内容时更新 |
创建文件时初始化有关时间;读取主要涉及 atime,修改内容通常同时影响 mtime 和 ctime。chmod 改权限、chown 改所有者、增加硬链接改变链接数,都会涉及状态变化时间。ctime 记录这些状态变化,创建时间若由系统提供,则通过相应的独立字段表示。
open 负责找到对象并建立打开记录,实际读取内容时再依据策略处理访问时间。文件以只读方式打开,仍可能由内核更新访问元数据;应用没有因此取得修改文件内容的权限。stat 手册说明了这些属性的含义。
访问时间
按每次读取都更新时间,会给大量读取增加元数据工作。内存缓存可以合并一些修改,挂载策略还可以调整访问时间的更新条件:
| 策略 | 访问时间处理 |
|---|---|
| strictatime | 按严格访问时间规则更新 |
| noatime | 抑制读取引起的自动 atime 更新 |
| relatime | 满足相对 mtime、ctime 或经过规定时间等条件时更新 |
| lazytime | 先在内存记录时间变化,按同步及其他规定条件持久保存 |
“关闭时再写一次”可以作为理解批量持久化的简化方案,但实际接口要分别说明更新了什么、何时保存以及崩溃后可能失去哪些时间变化。mount 手册给出了这些策略的具体条件。
思考题:只读操作为什么也可能产生磁盘写入?把一万次访问时间更新合并后,还要考虑什么?
解答:
读取可以更新 inode 的 atime,脏元数据随后可能写回磁盘。缓存与访问时间策略会改变更新频率,所以实际设备写入量要结合这些条件计算。
合并写入能减少 I/O,也需要规定故障时允许丢失多少尚未持久化的时间信息。noatime 抑制访问更新,lazytime 延迟持久保存,它们各有自己的语义。
打开记录
一个文件可以被打开多次。inode 保存文件本身的属性和位置;打开记录保存本次打开的方式与读写游标;进程的 fd 表保存“本进程的编号指向哪份打开记录”。
这条访问关系为:
进程的 fd → 内核打开记录 → 文件 inode → 数据块
打开记录常称为 open file description。教材中的系统 file table 可以帮助理解这些记录之间的关系,实际内核可以用动态对象等方式组织它们。fd 是进程交给内核查询的编号,使用时还要检查它是否有效、打开方式是否允许相应操作。
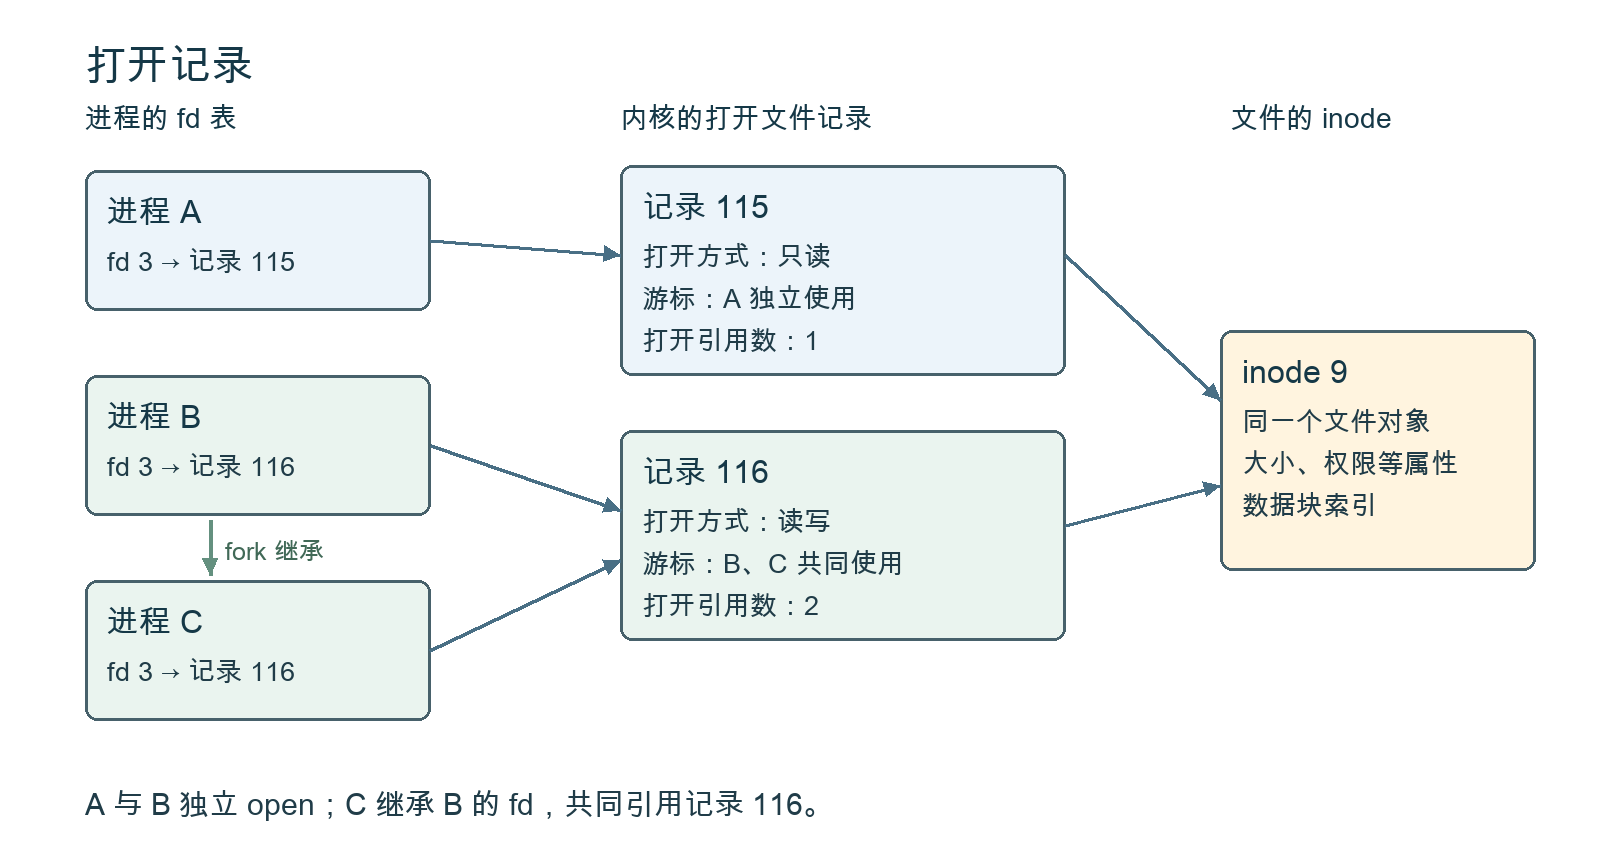
A 与 B 分别 open 同一个文件,取得各自进程中的 fd 3。A 指向记录 115,B 指向记录 116,两份记录最终都指向 inode 9。即使两个 fd 的数值相同,它们也分别由各自进程的表解释。
B 调用 fork 创建子进程 C,C 继承 B 的 fd;两者共同引用记录 116。对该记录的打开引用数变为 2,游标和有关打开状态由两者共同使用。fork 手册规定了这种继承关系。
练习:记录 115 与 116 的游标最初都为 0。按 A 读 10 B、B 读 10 B、C 读 5 B 的顺序执行,忽略错误与文件末尾,游标分别怎样变化?
解答:
A 读取后,记录 115 的游标变为 10,记录 116 仍为 0。B 读取后,记录 116 变为 10;C 随后从位置 10 读取 5 B,把同一记录的游标推进到 15。A 的游标仍为 10。
两次独立 open 各自建立游标,fork 继承的描述符共同引用一份游标。同一进程中的 dup 也可以让多个 fd 引用同一打开记录。
打开引用数与 inode 的硬链接计数管理不同关系。close 减少打开引用,unlink 移除目录中的名称引用。最后一个名称移除后,已打开文件仍能被相关 fd 使用;这些引用都结束以后,系统才按规则回收文件。
共享游标可以让多个写入者接续写入,也需要协调执行。使用支持相应语义的 O_APPEND,每次 write 按当前文件末尾定位;若一条日志由多次 write 组成,还要安排记录边界,防止不同记录交错。
同一进程的线程共享 fd 表,频繁并发 open、close 时,分配与释放需要协调。位图等结构可以加快寻找空位,但共享表的竞争仍可能增加成本。实际瓶颈需要通过调用耗时和锁等待等数据判断。
读取文件
继续用 /foo/bar 展开打开与读取。假设 foo 是目录,bar 是普通文件,使用只读打开:
- 从挂载记录确定根目录,读取它的 inode 与目录数据。
- 匹配名称 foo,取得 foo 的 inode 号,读取它的目录内容。
- 匹配名称 bar,取得 bar 的 inode,检查类型、权限和打开条件。
- 建立打开记录,游标初始化为相应位置,返回 fd。
下一次 read 传入 fd 后,内核从描述符表取得打开记录,再根据游标和 inode 查数据块,组合返回字节,并推进游标。已经完成的名称查找可以通过打开记录继续使用。
例如 bar 有三个逻辑数据块,一次读取可以顺序处理第 0、1、2 块;每一步都把逻辑块号转换成设备块号。目录、inode、索引和数据若已在缓存中,相关步骤可以由缓存提供,所以逻辑访问次数与实际设备 I/O 次数需要分开计数。
磁盘有寻道与旋转等待,频繁在管理区域和数据区域之间访问会增加等待;SSD 的物理机制不同,数据与元数据读取仍有成本。缓存、预读和数据布局可以改变实际访问路径。
创建文件
创建 /foo/bar,需要先定位父目录 foo,并检查在其中创建名称的条件。下面列出有关的逻辑动作,持久化顺序由文件系统的日志和同步协议安排:
| 位置 | 需要完成的动作 |
|---|---|
| 父目录 | 找到 foo,检查名称是否存在与创建权限 |
| inode 位图 | 找到空闲 inode,将它分配给新文件 |
| 新 inode | 初始化大小、类型、权限、所有者、索引和时间等信息 |
| foo 的目录数据 | 建立 bar → 新 inode 号 的目录项 |
| foo 的 inode | 更新有关大小、修改时间和状态变化信息 |
新普通文件可以从大小 0 开始;建立一个目录名称后,通常具有一个硬链接。暂时还没有文件内容时,可以不分配内容数据块。父目录需要容纳新增目录项,如果原有空间不足,还要分配目录数据块并维护其索引。
之后写入 bar 时,fd 直接找到新文件的打开记录。文件需要增长到新数据块时,再分配数据块、写入内容、记录块指针与文件大小,并更新时间。
整块修改
若某层接口按整个 4 KiB 块读写,而一个 inode 在其中只占 1 KiB,修改这条记录时要保留另外 3 KiB 的内容。可以先读取整块,改动对应的 1 KiB,再写回整块,这称为读改写(read-modify-write)。
位图也有类似要求:占用一个空位时,其他 bit 的分配状态需要保持。已有数据块只修改部分字节时,未修改部分也需要保留。缓存已含有原内容时,可以直接修改缓存;真实设备 I/O 还取决于缓存状态、设备单位和实现方式。
思考题:为什么新 inode 的初始化也可能先读后写?把空闲状态直接放在每条 inode 里,与单独位图相比,会怎样影响查找?
解答:
新 inode 所在块还可能保存其他 inode。先取得整块原内容,再修改目标区域,能够保留其他记录。目标块已经缓存时,可以避免再次从设备读取。
单独位图把分配状态集中在紧凑区域,扫描时只需读取这些 bit。每条 inode 内放一个状态位也能表示空闲,但找到空位可能需要访问许多分散且较大的记录。两种布局还需要各自维护一致的分配状态。
写入顺序
向文件追加一个新块,需要共同修改三类信息:数据块位图、新块内容,以及 inode 的块指针和大小。若 inode 已经把新块纳入文件,而内容还没保存,读取就可能取得该空闲块之前留下的字节。
思考题:下面三种追加顺序中,故障后分别可能留下什么?假设各步确实按列出的顺序持久保存,且已通过分配协调取得目标块。
A. 占用位图 → 写入新内容 → 更新 inode 指针与大小。
B. 占用位图 → 更新 inode 指针与大小 → 写入新内容。
C. 更新 inode 指针与大小 → 占用位图 → 写入新内容。
解答:
A 在前两步之后故障,可能留下已分配却没有被文件引用的块,造成空间泄漏;原文件的可见内容仍保留旧范围。三步都完成后,文件才引用已写好的新内容。
B 更新 inode 后、新内容写入前故障,文件已经引用新块,读取可能返回旧字节,包括此前文件留下的信息。
C 最先发布 inode 指针,既可能读到旧内容,位图又可能仍把块视为空闲,使其他文件再次取得它。
A 能减少这一模型中的故障损害,但仍需要处理空间泄漏和中断更新。日志可以保留恢复依据,让这些修改共同恢复为完整结果。
程序调用的先后顺序需要落实为持久化顺序。后台可能自动回写脏页,显式同步用于确认指定修改已保存;文件系统实现还会使用日志、写入屏障等机制协调元数据。
同步也有成本。可以在满足依赖的阶段边界上合并同步,但每个被允许持久化的中间状态,都需要有相应恢复依据。应用保存新版本时,还要处理文件内容与名称发布的顺序,具体转账和日志例子见故障原子性。
参考资料
- Linux,open、read、fopen、fork 与 stat 手册。
- Linux,mount 手册,访问时间与挂载条件。
- Linux,ext4 inode与目录格式文档。
- Arpaci-Dusseau 与 Arpaci-Dusseau,OSTEP 第 40 章,文件系统布局与访问方法。