分治思想
分治 (divide and conquer)把原问题拆成若干个同类型、规模更小的子问题,递归求解,再把子问题的答案合并。分析这类算法时,需要同时看子问题的个数、每个子问题的规模,以及拆分和合并的代价。后文的整数乘法、归并排序、选择算法和矩阵乘法都遵循这一思路。
快速整数乘法
上一讲的竖式乘法需要 O ( n 2 ) O(n^2) O ( n 2 ) O ( n ) O(n) O ( n )
高斯的复数乘法技巧 给出了一个直观例子。通常计算
( a + b i ) ( c + d i ) = ( a c − b d ) + ( a d + b c ) i (a+bi)(c+di)=(ac-bd)+(ad+bc)i
( a + bi ) ( c + d i ) = ( a c − b d ) + ( a d + b c ) i
要做四次实数乘法。令 P = a c P=ac P = a c Q = b d Q=bd Q = b d R = ( a + b ) ( c + d ) R=(a+b)(c+d) R = ( a + b ) ( c + d ) a d + b c = R − P − Q ad+bc=R-P-Q a d + b c = R − P − Q
设 x , y x,y x , y n n n n n n n ′ n' n ′ n ≤ n ′ < 2 n n\le n'<2n n ≤ n ′ < 2 n n / 2 n/2 n /2
x = 2 n / 2 x L + x R , y = 2 n / 2 y L + y R . x=2^{n/2}x_L+x_R,
\qquad
y=2^{n/2}y_L+y_R.
x = 2 n /2 x L + x R , y = 2 n /2 y L + y R .
直接展开有
x y = 2 n x L y L + 2 n / 2 ( x L y R + x R y L ) + x R y R . xy=2^n x_Ly_L+2^{n/2}(x_Ly_R+x_Ry_L)+x_Ry_R.
x y = 2 n x L y L + 2 n /2 ( x L y R + x R y L ) + x R y R .
若四个乘积分别递归计算,拆分、移位、加法合计为 O ( n ) O(n) O ( n )
T ( n ) = 4 T ( n / 2 ) + O ( n ) = O ( n 2 ) . T(n)=4T(n/2)+O(n)=O(n^2).
T ( n ) = 4 T ( n /2 ) + O ( n ) = O ( n 2 ) .
这与竖式乘法同阶。模仿高斯的技巧,只计算三个乘积:
P 1 = x L y L , P 2 = x R y R , P 3 = ( x L + x R ) ( y L + y R ) . P_1=x_Ly_L,
\qquad
P_2=x_Ry_R,
\qquad
P_3=(x_L+x_R)(y_L+y_R).
P 1 = x L y L , P 2 = x R y R , P 3 = ( x L + x R ) ( y L + y R ) .
因为 P 3 − P 1 − P 2 = x L y R + x R y L P_3-P_1-P_2=x_Ly_R+x_Ry_L P 3 − P 1 − P 2 = x L y R + x R y L O ( n ) O(n) O ( n )
x y = 2 n P 1 + 2 n / 2 ( P 3 − P 1 − P 2 ) + P 2 . xy=2^nP_1+2^{n/2}(P_3-P_1-P_2)+P_2.
x y = 2 n P 1 + 2 n /2 ( P 3 − P 1 − P 2 ) + P 2 .
用上一讲的 11 × 13 11\times13 11 × 13 11 = 1011 2 11=1011_2 11 = 101 1 2 13 = 1101 2 13=1101_2 13 = 110 1 2 x L = 2 , x R = 3 , y L = 3 , y R = 1 x_L=2,x_R=3,y_L=3,y_R=1 x L = 2 , x R = 3 , y L = 3 , y R = 1 P 1 = 6 P_1=6 P 1 = 6 P 2 = 3 P_2=3 P 2 = 3 P 3 = ( 2 + 3 ) ( 3 + 1 ) = 20 P_3=(2+3)(3+1)=20 P 3 = ( 2 + 3 ) ( 3 + 1 ) = 20 16 ⋅ 6 + 4 ⋅ ( 20 − 6 − 3 ) + 3 = 143 16\cdot6+4\cdot(20-6-3)+3=143 16 ⋅ 6 + 4 ⋅ ( 20 − 6 − 3 ) + 3 = 143
Karatsuba 乘法 的伪代码如下。为使任意长度都能直接递归实现,令 m = ⌈ n / 2 ⌉ m=\lceil n/2\rceil m = ⌈ n /2 ⌉ m m m n n n x L + x R x_L+x_R x L + x R y L + y R y_L+y_R y L + y R n / 2 + O ( 1 ) n/2+O(1) n /2 + O ( 1 )
算法:MULTIPLY ( x , y ) 输入: 两个非负二进制整数 x , y n = max { 两数的位数 } , m = ⌈ n / 2 ⌉ if n ≤ 4 then return x y ( x L , x R ) = 把 x 按高位、低 m 位拆分 ( y L , y R ) = 把 y 按高位、低 m 位拆分 P 1 = MULTIPLY ( x L , y L ) P 2 = MULTIPLY ( x R , y R ) P 3 = MULTIPLY ( x L + x R , y L + y R ) return 2 2 m P 1 + 2 m ( P 3 − P 1 − P 2 ) + P 2 \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:MULTIPLY}(x,y) \\[4pt]
\hline
\textbf{输入:}\ \text{两个非负二进制整数 }x,y \\
n=\max\{\text{两数的位数}\},\quad m=\lceil n/2\rceil \\
\textbf{if}\ n\le4\ \textbf{then}\ \text{return}\ xy \\
(x_L,x_R)=\text{把 }x\text{ 按高位、低 }m\text{ 位拆分} \\
(y_L,y_R)=\text{把 }y\text{ 按高位、低 }m\text{ 位拆分} \\
P_1=\text{MULTIPLY}(x_L,y_L) \\
P_2=\text{MULTIPLY}(x_R,y_R) \\
P_3=\text{MULTIPLY}(x_L+x_R,y_L+y_R) \\
\text{return}\ 2^{2m}P_1+2^m(P_3-P_1-P_2)+P_2 \\
\hline
\end{array}&&
\end{aligned}
算法: MULTIPLY ( x , y ) 输入: 两个非负二进制整数 x , y n = max { 两数的位数 } , m = ⌈ n /2 ⌉ if n ≤ 4 then return x y ( x L , x R ) = 把 x 按高位、低 m 位拆分 ( y L , y R ) = 把 y 按高位、低 m 位拆分 P 1 = MULTIPLY ( x L , y L ) P 2 = MULTIPLY ( x R , y R ) P 3 = MULTIPLY ( x L + x R , y L + y R ) return 2 2 m P 1 + 2 m ( P 3 − P 1 − P 2 ) + P 2
正确性由上面的展开式和 P 3 − P 1 − P 2 P_3-P_1-P_2 P 3 − P 1 − P 2 x L y L x_Ly_L x L y L x R y R x_Ry_R x R y R ( x L − x R ) ( y L − y R ) (x_L-x_R)(y_L-y_R) ( x L − x R ) ( y L − y R )
x L y R + x R y L = x L y L + x R y R − ( x L − x R ) ( y L − y R ) . x_Ly_R+x_Ry_L=x_Ly_L+x_Ry_R-(x_L-x_R)(y_L-y_R).
x L y R + x R y L = x L y L + x R y R − ( x L − x R ) ( y L − y R ) .
负的中间数可以带符号计算。讲义用这两种三乘法写法说明:Kolmogorov 曾猜想竖式乘法已是最优,Karatsuba 在 1960 年给出了反例。
忽略取整和相加时多出的一位,递归式写成 T ( n ) = 3 T ( n / 2 ) + O ( n ) T(n)=3T(n/2)+O(n) T ( n ) = 3 T ( n /2 ) + O ( n ) T ( n ) ≤ 3 T ( ⌈ n / 2 ⌉ + 1 ) + O ( n ) T(n)\le3T(\lceil n/2\rceil+1)+O(n) T ( n ) ≤ 3 T (⌈ n /2 ⌉ + 1 ) + O ( n ) k k k 3 k 3^k 3 k n / 2 k n/2^k n / 2 k
3 k O ( n 2 k ) = O ( n ( 3 2 ) k ) . 3^k O\!\left(\frac{n}{2^k}\right)
=O\!\left(n\left(\frac32\right)^k\right).
3 k O ( 2 k n ) = O ( n ( 2 3 ) k ) .
树高为 log 2 n \log_2n log 2 n 3 / 2 3/2 3/2 3 log 2 n = n log 2 3 3^{\log_2n}=n^{\log_23} 3 l o g 2 n = n l o g 2 3
T ( n ) = Θ ( n log 2 3 ) ≈ Θ ( n 1.585 ) . T(n)=\Theta\!\left(n^{\log_23}\right)
\approx\Theta(n^{1.585}).
T ( n ) = Θ ( n l o g 2 3 ) ≈ Θ ( n 1.585 ) .
课件提问:能否进一步改进乘法?
可以。三次半规模乘法已经突破 O ( n 2 ) O(n^2) O ( n 2 )
主定理
对于等规模子问题,课件给出的主定理处理
T ( n ) = a T ( ⌈ n / b ⌉ ) + O ( n d ) , a > 0 , b > 1 , d ≥ 0 , T(n)=aT(\lceil n/b\rceil)+O(n^d),
\qquad a>0,\ b>1,\ d\ge0,
T ( n ) = a T (⌈ n / b ⌉) + O ( n d ) , a > 0 , b > 1 , d ≥ 0 ,
其中 a a a b b b O ( n d ) O(n^d) O ( n d ) O ( 1 ) O(1) O ( 1 )
T ( n ) = { O ( n d ) , d > log b a , O ( n d log n ) , d = log b a , O ( n log b a ) , d < log b a . T(n)=
\begin{cases}
O(n^d), & d>\log_ba,\\
O(n^d\log n), & d=\log_ba,\\
O(n^{\log_ba}), & d<\log_ba.
\end{cases}
T ( n ) = ⎩ ⎨ ⎧ O ( n d ) , O ( n d log n ) , O ( n l o g b a ) , d > log b a , d = log b a , d < log b a .
若本层代价实际为 Θ ( n d ) \Theta(n^d) Θ ( n d ) Θ \Theta Θ
证明可先假设 n n n b b b log b n \log_bn log b n k k k a k a^k a k n / b k n/b^k n / b k
a k O ( n b k ) d = O ( n d ) ( a b d ) k . a^kO\!\left(\frac{n}{b^k}\right)^d
=O(n^d)\left(\frac{a}{b^d}\right)^k.
a k O ( b k n ) d = O ( n d ) ( b d a ) k .
层代价构成公比 a / b d a/b^d a / b d
a / b d < 1 a/b^d<1 a / b d < 1 O ( n d ) O(n^d) O ( n d ) a / b d = 1 a/b^d=1 a / b d = 1 O ( log n ) O(\log n) O ( log n ) O ( n d log n ) O(n^d\log n) O ( n d log n ) a / b d > 1 a/b^d>1 a / b d > 1 O ( a log b n ) = O ( n log b a ) O(a^{\log_bn})=O(n^{\log_ba}) O ( a l o g b n ) = O ( n l o g b a )
例如 Karatsuba 乘法中 a = 3 , b = 2 , d = 1 a=3,b=2,d=1 a = 3 , b = 2 , d = 1 a = 4 , b = 2 , d = 1 a=4,b=2,d=1 a = 4 , b = 2 , d = 1 O ( n 2 ) O(n^2) O ( n 2 )
不等规模递推
当各子问题按不同的比例缩小,主定理通常不能直接使用。课件给出 Akra-Bazzi 定理 :若
T ( n ) = ∑ i = 1 k a i T ( b i n + h i ( n ) ) + g ( n ) , T(n)=\sum_{i=1}^{k}a_iT(b_in+h_i(n))+g(n),
T ( n ) = i = 1 ∑ k a i T ( b i n + h i ( n )) + g ( n ) ,
其中 a i > 0 a_i>0 a i > 0 0 < b i < 1 0<b_i<1 0 < b i < 1 ∣ h i ( n ) ∣ = O ( n / log 2 n ) |h_i(n)|=O(n/\log^2n) ∣ h i ( n ) ∣ = O ( n / log 2 n ) g ( n ) g(n) g ( n ) p p p
∑ i = 1 k a i b i p = 1. \sum_{i=1}^{k}a_ib_i^p=1.
i = 1 ∑ k a i b i p = 1.
则在这些条件下
T ( n ) = Θ ( n p ( 1 + ∫ 1 n g ( u ) u p + 1 d u ) ) . T(n)=\Theta\!\left(
n^p\left(1+\int_1^n\frac{g(u)}{u^{p+1}}\,\mathrm du\right)
\right).
T ( n ) = Θ ( n p ( 1 + ∫ 1 n u p + 1 g ( u ) d u ) ) .
课件中的例子为
T ( n ) = T ( ⌊ n 5 ⌋ ) + T ( n − 3 ⌊ n 10 ⌋ ) + 11 5 n , T ( 0 ) = T ( 1 ) = 0. T(n)=T\!\left(\left\lfloor\frac n5\right\rfloor\right)
+T\!\left(n-3\left\lfloor\frac n{10}\right\rfloor\right)
+\frac{11}{5}n,
\qquad T(0)=T(1)=0.
T ( n ) = T ( ⌊ 5 n ⌋ ) + T ( n − 3 ⌊ 10 n ⌋ ) + 5 11 n , T ( 0 ) = T ( 1 ) = 0.
课件只写出 T ( 0 ) = T ( 1 ) = 0 T(0)=T(1)=0 T ( 0 ) = T ( 1 ) = 0 2 ≤ n < 10 2\le n<10 2 ≤ n < 10 T ( n ) T(n) T ( n ) n n n
两个主比例分别是 b 1 = 1 / 5 b_1=1/5 b 1 = 1/5 b 2 = 7 / 10 b_2=7/10 b 2 = 7/10
h 1 ( n ) = ⌊ n 5 ⌋ − n 5 , h 2 ( n ) = 3 n 10 − 3 ⌊ n 10 ⌋ , h_1(n)=\left\lfloor\frac n5\right\rfloor-\frac n5,
\qquad
h_2(n)=\frac{3n}{10}-3\left\lfloor\frac n{10}\right\rfloor,
h 1 ( n ) = ⌊ 5 n ⌋ − 5 n , h 2 ( n ) = 10 3 n − 3 ⌊ 10 n ⌋ ,
两者都为 O ( 1 ) O(1) O ( 1 ) ( 1 / 5 ) p + ( 7 / 10 ) p = 1 (1/5)^p+(7/10)^p=1 ( 1/5 ) p + ( 7/10 ) p = 1 p = 0.83978 < 1 p=0.83978<1 p = 0.83978 < 1 g ( u ) = 11 u / 5 g(u)=11u/5 g ( u ) = 11 u /5
n p ( 1 + ∫ 1 n 11 u / 5 u p + 1 d u ) = n p ( 1 + 11 5 ( 1 − p ) ( n 1 − p − 1 ) ) = Θ ( n ) . n^p\left(1+\int_1^n\frac{11u/5}{u^{p+1}}\,\mathrm du\right)
=n^p\left(1+\frac{11}{5(1-p)}(n^{1-p}-1)\right)
=\Theta(n).
n p ( 1 + ∫ 1 n u p + 1 11 u /5 d u ) = n p ( 1 + 5 ( 1 − p ) 11 ( n 1 − p − 1 ) ) = Θ ( n ) .
故该递推的解为 T ( n ) = Θ ( n ) T(n)=\Theta(n) T ( n ) = Θ ( n ) n n n
Quiz:求递推 T ( n ) = 4 T ( n ) + 1 T(n)=4T(\sqrt n)+1 T ( n ) = 4 T ( n ) + 1
解答 :补充常数规模的基例后,设 m = log 2 n m=\log_2n m = log 2 n S ( m ) = T ( 2 m ) S(m)=T(2^m) S ( m ) = T ( 2 m ) 2 m = 2 m / 2 \sqrt{2^m}=2^{m/2} 2 m = 2 m /2
S ( m ) = 4 S ( m / 2 ) + 1. S(m)=4S(m/2)+1.
S ( m ) = 4 S ( m /2 ) + 1.
对新变量 m m m a = 4 , b = 2 , d = 0 a=4,b=2,d=0 a = 4 , b = 2 , d = 0 S ( m ) = Θ ( m log 2 4 ) = Θ ( m 2 ) S(m)=\Theta(m^{\log_24})=\Theta(m^2) S ( m ) = Θ ( m l o g 2 4 ) = Θ ( m 2 )
T ( n ) = Θ ( ( log n ) 2 ) . \boxed{T(n)=\Theta((\log n)^2)}.
T ( n ) = Θ (( log n ) 2 ) .
也可从递归树验证:输入规模经过 k k k n 1 / 2 k n^{1/2^k} n 1/ 2 k log 2 log n \log_2\log n log 2 log n 4 log 2 log 2 n = ( log 2 n ) 2 4^{\log_2\log_2n}=(\log_2n)^2 4 l o g 2 l o g 2 n = ( log 2 n ) 2 n \sqrt n n n / b n/b n / b
归并排序
归并排序 把长度为 n n n ≤ \le ≤
算法:MERGE ( x [ 1 … k ] , y [ 1 … l ] ) if k = 0 then return y if l = 0 then return x if x [ 1 ] ≤ y [ 1 ] then return x [ 1 ] ∘ MERGE ( x [ 2 … k ] , y ) else return y [ 1 ] ∘ MERGE ( x , y [ 2 … l ] ) \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:MERGE}(x[1\ldots k],y[1\ldots l]) \\[4pt]
\hline
\textbf{if}\ k=0\ \textbf{then}\ \text{return}\ y \\
\textbf{if}\ l=0\ \textbf{then}\ \text{return}\ x \\
\textbf{if}\ x[1]\le y[1]\ \textbf{then} \\
\qquad \text{return}\ x[1]\circ\text{MERGE}(x[2\ldots k],y) \\
\textbf{else}\ \text{return}\ y[1]\circ\text{MERGE}(x,y[2\ldots l]) \\
\hline
\end{array}&&
\end{aligned}
算法: MERGE ( x [ 1 … k ] , y [ 1 … l ]) if k = 0 then return y if l = 0 then return x if x [ 1 ] ≤ y [ 1 ] then return x [ 1 ] ∘ MERGE ( x [ 2 … k ] , y ) else return y [ 1 ] ∘ MERGE ( x , y [ 2 … l ])
这里 ∘ \circ ∘ O ( k + l ) O(k+l) O ( k + l )
算法:MERGESORT ( a [ 1 … n ] ) if n ≤ 1 then return a m = ⌊ n / 2 ⌋ x = MERGESORT ( a [ 1 … m ] ) y = MERGESORT ( a [ m + 1 … n ] ) return MERGE ( x , y ) \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:MERGESORT}(a[1\ldots n]) \\[4pt]
\hline
\textbf{if}\ n\le1\ \textbf{then}\ \text{return}\ a \\
m=\lfloor n/2\rfloor \\
x=\text{MERGESORT}(a[1\ldots m]) \\
y=\text{MERGESORT}(a[m+1\ldots n]) \\
\text{return}\ \text{MERGE}(x,y) \\
\hline
\end{array}&&
\end{aligned}
算法: MERGESORT ( a [ 1 … n ]) if n ≤ 1 then return a m = ⌊ n /2 ⌋ x = MERGESORT ( a [ 1 … m ]) y = MERGESORT ( a [ m + 1 … n ]) return MERGE ( x , y )
两半在递归结束后分别有序,而 MERGE 正确地合并且不丢失元素,因此 MERGESORT 正确。时间递推为 T ( n ) = 2 T ( n / 2 ) + O ( n ) T(n)=2T(n/2)+O(n) T ( n ) = 2 T ( n /2 ) + O ( n ) O ( n log n ) O(n\log n) O ( n log n ) Θ ( n log n ) \Theta(n\log n) Θ ( n log n ) O ( n ) O(n) O ( n )
例如 [ 5 , 1 , 4 , 2 ] [5,1,4,2] [ 5 , 1 , 4 , 2 ] [ 5 , 1 ] [5,1] [ 5 , 1 ] [ 4 , 2 ] [4,2] [ 4 , 2 ] [ 1 , 5 ] [1,5] [ 1 , 5 ] [ 2 , 4 ] [2,4] [ 2 , 4 ] [ 1 , 2 , 4 , 5 ] [1,2,4,5] [ 1 , 2 , 4 , 5 ]
练习 2.14:给定一个含 n n n O ( n log n ) O(n\log n) O ( n log n )
本题考查排序后的相等元素连续性,以及排序后线性扫描的应用。
先用归并排序将数组 A [ 1 … n ] A[1\ldots n] A [ 1 … n ]
若 n = 0 n=0 n = 0 w = 1 w=1 w = 1 i = 2 , … , n i=2,\ldots,n i = 2 , … , n A [ i ] ≠ A [ w ] A[i]\ne A[w] A [ i ] = A [ w ] w ← w + 1 w\leftarrow w+1 w ← w + 1 A [ w ] ← A [ i ] A[w]\leftarrow A[i] A [ w ] ← A [ i ] A [ 1 … w ] A[1\ldots w] A [ 1 … w ]
伪代码如下。数组下标从 1 1 1
1
2
3
4
5
6
7
8
9
10
11
12
// 排序后原地压缩重复段,返回每个不同取值的一份副本。 function REMOVE-DUPLICATES(A): n ← length(A) if n = 0: return [] A ← MERGESORT(A) w ← 1 for i ← 2 to n: if A[i] ≠ A[w]: w ← w + 1 A[w] ← A[i] return A[1..w]
处理完原数组的前 i i i A [ 1 … w ] A[1\ldots w] A [ 1 … w ]
排序需要 O ( n log n ) O(n\log n) O ( n log n ) O ( n ) O(n) O ( n )
T ( n ) = O ( n log n ) + O ( n ) = O ( n log n ) . T(n)=O(n\log n)+O(n)=O(n\log n).
T ( n ) = O ( n log n ) + O ( n ) = O ( n log n ) .
课件还给出队列版本:先把每个元素作为长度为 1 的有序序列入队;反复从队首取出两个序列,合并后放到队尾;队列只剩一个序列时返回。若 n = 0 n=0 n = 0
算法:ITERATIVE-MERGESORT ( a [ 1 … n ] ) if n = 0 then return [ ] Q = 空队列 for i = 1 to n do INJECT ( Q , [ a [ i ] ] ) while ∣ Q ∣ > 1 do x = EJECT ( Q ) , y = EJECT ( Q ) INJECT ( Q , MERGE ( x , y ) ) return EJECT ( Q ) \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:ITERATIVE-MERGESORT}(a[1\ldots n]) \\[4pt]
\hline
\textbf{if}\ n=0\ \textbf{then}\ \text{return}\ [\ ] \\
Q=\text{空队列} \\
\textbf{for}\ i=1\ \textbf{to}\ n\ \textbf{do}\ \text{INJECT}(Q,[a[i]]) \\
\textbf{while}\ |Q|>1\ \textbf{do} \\
\qquad x=\text{EJECT}(Q),\ y=\text{EJECT}(Q) \\
\qquad \text{INJECT}(Q,\text{MERGE}(x,y)) \\
\text{return}\ \text{EJECT}(Q) \\
\hline
\end{array}&&
\end{aligned}
算法: ITERATIVE-MERGESORT ( a [ 1 … n ]) if n = 0 then return [ ] Q = 空队列 for i = 1 to n do INJECT ( Q , [ a [ i ]]) while ∣ Q ∣ > 1 do x = EJECT ( Q ) , y = EJECT ( Q ) INJECT ( Q , MERGE ( x , y )) return EJECT ( Q )
INJECT 表示队尾入队,EJECT 表示队首出队。队列中的每个序列始终有序,且全部序列恰好组成原始元素的一个划分,因此最终序列有序并包含所有输入。先进先出的合并顺序使各元素经历 O ( log n ) O(\log n) O ( log n ) O ( n log n ) O(n\log n) O ( n log n ) n n n
练习 2.19:给定 k k k n n n k n kn kn
本题考查归并代价、求和分析和平衡分治。
(a) 先归并前两个数组,再依次合入第三、第四个数组,直到全部合并。用 k , n k,n k , n
记输入数组为 L [ 1 ] , … , L [ k ] L[1],\ldots,L[k] L [ 1 ] , … , L [ k ] k ≥ 1 k\ge1 k ≥ 1
1
2
3
4
5
6
// 依次把下一个有序数组归并进累计结果。 function SEQUENTIAL-MERGE(L[1..k]): R ← L[1] for j ← 2 to k: R ← MERGE(R, L[j]) return R
合入第 j j j ( j − 1 ) n (j-1)n ( j − 1 ) n n n n Θ ( j n ) \Theta(jn) Θ ( jn ) k ≥ 2 k\ge2 k ≥ 2
T ( k , n ) = ∑ j = 2 k Θ ( j n ) = Θ ( n ( k ( k + 1 ) 2 − 1 ) ) = Θ ( n k 2 ) . T(k,n)=\sum_{j=2}^{k}\Theta(jn)
=\Theta\!\left(n\left(\frac{k(k+1)}2-1\right)\right)
=\Theta(nk^2).
T ( k , n ) = j = 2 ∑ k Θ ( jn ) = Θ ( n ( 2 k ( k + 1 ) − 1 ) ) = Θ ( n k 2 ) .
(b) 用分治给出一个更高效的算法。
将 k k k
记输入数组为 L [ 1 ] , … , L [ k ] L[1],\ldots,L[k] L [ 1 ] , … , L [ k ] ( L , 1 , k ) (L,1,k) ( L , 1 , k )
1
2
3
4
5
6
7
8
// 平衡划分数组编号区间 [left, right],归并该区间的所有数组。 function MERGE-K(L, left, right): if left = right: return L[left] middle ← floor((left + right) / 2) X ← MERGE-K(L, left, middle) Y ← MERGE-K(L, middle + 1, right) return MERGE(X, Y)
递归返回的两个数组均有序,且分别恰好包含对应组的所有元素;归并后仍有序且不丢失元素,因此算法由归纳法保证正确。
若 k k k 2 2 2
T ( k , n ) = 2 T ( k / 2 , n ) + Θ ( k n ) = Θ ( k n log k ) . T(k,n)=2T(k/2,n)+\Theta(kn)=\Theta(kn\log k).
T ( k , n ) = 2 T ( k /2 , n ) + Θ ( kn ) = Θ ( kn log k ) .
一般的 k k k 2 2 2 k n kn kn ⌈ log 2 k ⌉ \lceil\log_2k\rceil ⌈ log 2 k ⌉ O ( k n log k ) O(kn\log k) O ( kn log k ) Θ ( k n log k ) \Theta(kn\log k) Θ ( kn log k ) k = 1 k=1 k = 1
课件提问:归并排序还能更快吗?
若仅靠两两比较区分任意不同的输入元素,在最坏情况下不能突破 Ω ( n log n ) \Omega(n\log n) Ω ( n log n )
证明用决策树 :每次比较只有两种结果,比较排序可表示成一棵二叉树。n n n n ! n! n ! n ! n! n ! h h h 2 h 2^h 2 h
2 h ≥ n ! , h ≥ log 2 ( n ! ) = Ω ( n log n ) , 2^h\ge n!,
\qquad
h\ge\log_2(n!)=\Omega(n\log n),
2 h ≥ n ! , h ≥ log 2 ( n !) = Ω ( n log n ) ,
最后一步可由 Stirling 公式得到。这个下界限定于比较模型;若输入具有额外结构,其他排序方法可以使用不同的操作。
课件的三元素决策树需要区分 3 ! = 6 3!=6 3 ! = 6 ⌈ log 2 6 ⌉ = 3 \lceil\log_2 6\rceil=3 ⌈ log 2 6 ⌉ = 3
随机选择
中位数 用于给一组数选出典型值。课件约定:若序列长度为偶数,取排序后靠左的那个中间元素,即第 ⌈ n / 2 ⌉ \lceil n/2\rceil ⌈ n /2 ⌉ O ( n log n ) O(n\log n) O ( n log n ) 选择 :输入序列 S S S 1 ≤ k ≤ ∣ S ∣ 1\le k\le|S| 1 ≤ k ≤ ∣ S ∣ k k k
选取主元 v ∈ S v\in S v ∈ S S L S_L S L v v v S v S_v S v v v v S R S_R S R v v v v v v
selection ( S , k ) = { selection ( S L , k ) , k ≤ ∣ S L ∣ , v , ∣ S L ∣ < k ≤ ∣ S L ∣ + ∣ S v ∣ , selection ( S R , k − ∣ S L ∣ − ∣ S v ∣ ) , k > ∣ S L ∣ + ∣ S v ∣ . \operatorname{selection}(S,k)=
\begin{cases}
\operatorname{selection}(S_L,k), & k\le|S_L|,\\
v, & |S_L|<k\le|S_L|+|S_v|,\\
\operatorname{selection}(S_R,k-|S_L|-|S_v|), & k>|S_L|+|S_v|.
\end{cases}
selection ( S , k ) = ⎩ ⎨ ⎧ selection ( S L , k ) , v , selection ( S R , k − ∣ S L ∣ − ∣ S v ∣ ) , k ≤ ∣ S L ∣ , ∣ S L ∣ < k ≤ ∣ S L ∣ + ∣ S v ∣ , k > ∣ S L ∣ + ∣ S v ∣.
分区后只需递归进入包含目标排名的那一侧,不必同时求解两侧。若主元始终接近中位数,递推 T ( n ) = T ( n / 2 ) + O ( n ) = O ( n ) T(n)=T(n/2)+O(n)=O(n) T ( n ) = T ( n /2 ) + O ( n ) = O ( n ) 均匀随机选取 主元的方法。
例如 S = [ 7 , 2 , 9 , 2 , 5 , 11 , 4 ] S=[7,2,9,2,5,11,4] S = [ 7 , 2 , 9 , 2 , 5 , 11 , 4 ] k = 4 k=4 k = 4 v = 5 v=5 v = 5 S L = [ 2 , 2 , 4 ] S_L=[2,2,4] S L = [ 2 , 2 , 4 ] S v = [ 5 ] S_v=[5] S v = [ 5 ] S R = [ 7 , 9 , 11 ] S_R=[7,9,11] S R = [ 7 , 9 , 11 ] ∣ S L ∣ = 3 < 4 ≤ 4 = ∣ S L ∣ + ∣ S v ∣ |S_L|=3<4\le4=|S_L|+|S_v| ∣ S L ∣ = 3 < 4 ≤ 4 = ∣ S L ∣ + ∣ S v ∣ 5 5 5 2 2 2
算法:SELECTION ( S , k ) 输入: ∣ S ∣ ≥ 1 , 1 ≤ k ≤ ∣ S ∣ v = 从 S 中均匀随机选出的元素 S L = { x ∈ S : x < v } , S v = { x ∈ S : x = v } , S R = { x ∈ S : x > v } if k ≤ ∣ S L ∣ then return SELECTION ( S L , k ) if k ≤ ∣ S L ∣ + ∣ S v ∣ then return v return SELECTION ( S R , k − ∣ S L ∣ − ∣ S v ∣ ) \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:SELECTION}(S,k) \\[4pt]
\hline
\textbf{输入:}\ |S|\ge1,\ 1\le k\le|S| \\
v=\text{从 }S\text{ 中均匀随机选出的元素} \\
S_L=\{x\in S:x<v\},\ S_v=\{x\in S:x=v\},\ S_R=\{x\in S:x>v\} \\
\textbf{if}\ k\le|S_L|\ \textbf{then}\ \text{return}\ \text{SELECTION}(S_L,k) \\
\textbf{if}\ k\le|S_L|+|S_v|\ \textbf{then}\ \text{return}\ v \\
\text{return}\ \text{SELECTION}(S_R,k-|S_L|-|S_v|) \\
\hline
\end{array}&&
\end{aligned}
算法: SELECTION ( S , k ) 输入: ∣ S ∣ ≥ 1 , 1 ≤ k ≤ ∣ S ∣ v = 从 S 中均匀随机选出的元素 S L = { x ∈ S : x < v } , S v = { x ∈ S : x = v } , S R = { x ∈ S : x > v } if k ≤ ∣ S L ∣ then return SELECTION ( S L , k ) if k ≤ ∣ S L ∣ + ∣ S v ∣ then return v return SELECTION ( S R , k − ∣ S L ∣ − ∣ S v ∣ )
每次分区为 O ( n ) O(n) O ( n ) n + ( n − 1 ) + ⋯ + 1 = Θ ( n 2 ) n+(n-1)+\cdots+1=\Theta(n^2) n + ( n − 1 ) + ⋯ + 1 = Θ ( n 2 )
期望时间却是 O ( n ) O(n) O ( n ) 好主元 。随机取一个元素时,选到好主元的概率至少约 1 / 2 1/2 1/2 3 n / 4 3n/4 3 n /4 E E E
E = 1 + 1 2 E , E = 2. E=1+\frac12E,
\qquad E=2.
E = 1 + 2 1 E , E = 2.
因此在当前规模不超过 n n n 1 / 4 1/4 1/4 3 n / 4 , ( 3 / 4 ) 2 n , … 3n/4,(3/4)^2n,\ldots 3 n /4 , ( 3/4 ) 2 n , …
E [ T ( n ) ] ≤ O ( n ) ∑ j ≥ 0 ( 3 4 ) j = O ( n ) . \mathbb E[T(n)]
\le O(n)\sum_{j\ge0}\left(\frac34\right)^j
=O(n).
E [ T ( n )] ≤ O ( n ) j ≥ 0 ∑ ( 4 3 ) j = O ( n ) .
这也解释了课件所写的期望递推 T ( n ) ≲ T ( 3 n / 4 ) + O ( n ) T(n)\lesssim T(3n/4)+O(n) T ( n ) ≲ T ( 3 n /4 ) + O ( n ) 3 n / 4 3n/4 3 n /4
课件提问:求中位数需要先排序吗?
不需要。调用 SELECTION ( S , ⌈ n / 2 ⌉ ) \operatorname{SELECTION}(S,\lceil n/2\rceil) SELECTION ( S , ⌈ n /2 ⌉) O ( n ) O(n) O ( n )
练习 2.22:给定两个长度分别为 m , n m,n m , n O ( log m + log n ) O(\log m+\log n) O ( log m + log n ) k k k
本题考查有序性、二分搜索,以及第 k 小元素的前缀划分条件。
记两个有序表为 A [ 1 … m ] A[1\ldots m] A [ 1 … m ] B [ 1 … n ] B[1\ldots n] B [ 1 … n ] 1 ≤ k ≤ m + n 1\le k\le m+n 1 ≤ k ≤ m + n O ( 1 ) O(1) O ( 1 ) k k k
考虑从 A A A i i i B B B j = k − i j=k-i j = k − i k k k i i i
L = max ( 0 , k − n ) ≤ i ≤ U = min ( k , m ) . L=\max(0,k-n)\le i\le U=\min(k,m).
L = max ( 0 , k − n ) ≤ i ≤ U = min ( k , m ) .
为统一边界,定义
A [ 0 ] = B [ 0 ] = − ∞ , A [ m + 1 ] = B [ n + 1 ] = + ∞ . A[0]=B[0]=-\infty,\qquad A[m+1]=B[n+1]=+\infty.
A [ 0 ] = B [ 0 ] = − ∞ , A [ m + 1 ] = B [ n + 1 ] = + ∞.
在 [ L , U ] [L,U] [ L , U ] i = ⌊ ( L + U ) / 2 ⌋ i=\lfloor(L+U)/2\rfloor i = ⌊( L + U ) /2 ⌋ j = k − i j=k-i j = k − i
若
A [ i ] ≤ B [ j + 1 ] , B [ j ] ≤ A [ i + 1 ] , A[i]\le B[j+1],\qquad B[j]\le A[i+1],
A [ i ] ≤ B [ j + 1 ] , B [ j ] ≤ A [ i + 1 ] ,
则左侧的 k k k max { A [ i ] , B [ j ] } \max\{A[i],B[j]\} max { A [ i ] , B [ j ]}
若 A [ i ] > B [ j + 1 ] A[i]>B[j+1] A [ i ] > B [ j + 1 ] A A A U ← i − 1 U\leftarrow i-1 U ← i − 1 i ′ ≥ i i'\ge i i ′ ≥ i
A [ i ′ ] ≥ A [ i ] > B [ k − i + 1 ] ≥ B [ k − i ′ + 1 ] , A[i']\ge A[i]>B[k-i+1]\ge B[k-i'+1],
A [ i ′ ] ≥ A [ i ] > B [ k − i + 1 ] ≥ B [ k − i ′ + 1 ] ,
所以不可能是正确划分。若 B [ j ] > A [ i + 1 ] B[j]>A[i+1] B [ j ] > A [ i + 1 ] A A A L ← i + 1 L\leftarrow i+1 L ← i + 1 i ′ ≤ i i'\le i i ′ ≤ i
下面的伪代码通过条件读取实现哨兵,不实际扩展输入表;数组下标从 1 1 1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// 输入两张可随机访问的有序表,返回第 k 小元素;1 ≤ k ≤ m + n。 function KTH-TWO-SORTED(A, B, k): m ← length(A) n ← length(B) if m = 0: return B[k] if n = 0: return A[k] L ← max(0, k - n) U ← min(k, m) while L ≤ U: i ← floor((L + U) / 2) j ← k - i aLeft ← A[i] if i > 0 else -∞ aRight ← A[i + 1] if i < m else +∞ bLeft ← B[j] if j > 0 else -∞ bRight ← B[j + 1] if j < n else +∞ if aLeft ≤ bRight and bLeft ≤ aRight: return max(aLeft, bLeft) if aLeft > bRight: U ← i - 1 else: L ← i + 1
概念上把两表归并后取前 k k k min ( m , n ) + 1 \min(m,n)+1 min ( m , n ) + 1
O ( log ( min { m , n } + 1 ) ) , O\!\left(\log(\min\{m,n\}+1)\right),
O ( log ( min { m , n } + 1 ) ) ,
满足要求的 O ( log m + log n ) O(\log m+\log n) O ( log m + log n ) O ( 1 ) O(1) O ( 1 )
矩阵乘法
两个 n × n n\times n n × n X , Y X,Y X , Y Z = X Y Z=XY Z = X Y
Z i j = ∑ k = 1 n X i k Y k j . Z_{ij}=\sum_{k=1}^{n}X_{ik}Y_{kj}.
Z ij = k = 1 ∑ n X ik Y kj .
共有 n 2 n^2 n 2 O ( n ) O(n) O ( n ) O ( n 3 ) O(n^3) O ( n 3 ) 不满足交换律 ,即 X Y ≠ Y X XY\ne YX X Y = Y X
把矩阵各分成四个 n / 2 × n / 2 n/2\times n/2 n /2 × n /2
X = ( A B C D ) , Y = ( E F G H ) . X=\begin{pmatrix}A&B\\C&D\end{pmatrix},
\qquad
Y=\begin{pmatrix}E&F\\G&H\end{pmatrix}.
X = ( A C B D ) , Y = ( E G F H ) .
普通分块乘法为
X Y = ( A E + B G A F + B H C E + D G C F + D H ) . XY=
\begin{pmatrix}
AE+BG & AF+BH\\
CE+DG & CF+DH
\end{pmatrix}.
X Y = ( A E + BG CE + D G A F + B H CF + DH ) .
四个结果块各需两次半规模矩阵乘法,共八次;块加法总共 O ( n 2 ) O(n^2) O ( n 2 ) T ( n ) = 8 T ( n / 2 ) + O ( n 2 ) = O ( n 3 ) T(n)=8T(n/2)+O(n^2)=O(n^3) T ( n ) = 8 T ( n /2 ) + O ( n 2 ) = O ( n 3 )
Strassen 算法 把八次块乘法减少为七次。课件中的七个中间矩阵是
P 1 = A ( F − H ) , P 2 = ( A + B ) H , P 3 = ( C + D ) E , P 4 = D ( G − E ) , P 5 = ( A + D ) ( E + H ) , P 6 = ( B − D ) ( G + H ) , P 7 = ( A − C ) ( E + F ) . \begin{aligned}
P_1&=A(F-H), & P_2&=(A+B)H,\\
P_3&=(C+D)E, & P_4&=D(G-E),\\
P_5&=(A+D)(E+H), & P_6&=(B-D)(G+H),\\
P_7&=(A-C)(E+F).
\end{aligned}
P 1 P 3 P 5 P 7 = A ( F − H ) , = ( C + D ) E , = ( A + D ) ( E + H ) , = ( A − C ) ( E + F ) . P 2 P 4 P 6 = ( A + B ) H , = D ( G − E ) , = ( B − D ) ( G + H ) ,
用这些乘积恢复结果:
X Y = ( P 5 + P 4 − P 2 + P 6 P 1 + P 2 P 3 + P 4 P 1 + P 5 − P 3 − P 7 ) . XY=
\begin{pmatrix}
P_5+P_4-P_2+P_6 & P_1+P_2\\
P_3+P_4 & P_1+P_5-P_3-P_7
\end{pmatrix}.
X Y = ( P 5 + P 4 − P 2 + P 6 P 3 + P 4 P 1 + P 2 P 1 + P 5 − P 3 − P 7 ) .
例如右上块 P 1 + P 2 = A ( F − H ) + ( A + B ) H = A F + B H P_1+P_2=A(F-H)+(A+B)H=AF+BH P 1 + P 2 = A ( F − H ) + ( A + B ) H = A F + B H P 3 + P 4 = ( C + D ) E + D ( G − E ) = C E + D G P_3+P_4=(C+D)E+D(G-E)=CE+DG P 3 + P 4 = ( C + D ) E + D ( G − E ) = CE + D G A E + B G AE+BG A E + BG C F + D H CF+DH CF + DH
取 X = ( 1 2 3 4 ) X=\begin{pmatrix}1&2\\3&4\end{pmatrix} X = ( 1 3 2 4 ) Y = ( 5 6 7 8 ) Y=\begin{pmatrix}5&6\\7&8\end{pmatrix} Y = ( 5 7 6 8 ) − 2 , 24 , 35 , 8 , 65 , − 30 , − 22 -2,24,35,8,65,-30,-22 − 2 , 24 , 35 , 8 , 65 , − 30 , − 22
X Y = ( 19 22 43 50 ) , XY=\begin{pmatrix}19&22\\43&50\end{pmatrix},
X Y = ( 19 43 22 50 ) ,
与普通矩阵乘法逐项计算的结果相同。
加减矩阵块共用 O ( n 2 ) O(n^2) O ( n 2 )
T ( n ) = 7 T ( n / 2 ) + O ( n 2 ) = O ( n log 2 7 ) ≈ O ( n 2.807 ) . T(n)=7T(n/2)+O(n^2)
=O\!\left(n^{\log_27}\right)
\approx O(n^{2.807}).
T ( n ) = 7 T ( n /2 ) + O ( n 2 ) = O ( n l o g 2 7 ) ≈ O ( n 2.807 ) .
矩阵维度不是 2 的幂时可补零到最近的 2 的幂,维度增加不到一倍。这里的 O ( n 3 ) O(n^3) O ( n 3 ) O ( n log 2 7 ) O(n^{\log_27}) O ( n l o g 2 7 )
分治练习
这一讲先复习分治的三个步骤,以及上一讲的主定理:拆成更小的同类子问题、递归求解、合并答案。下面两道练习分别对应确定性分治和随机分治。
练习:用 L 形骨牌覆盖一块 n × n n\times n n × n n n n
把棋盘分成四块 n / 2 × n / 2 n/2\times n/2 n /2 × n /2 n = 2 n=2 n = 2
归纳可证整个构造不会重叠,也不会遗漏应覆盖的格子。骨牌数 Q ( n ) Q(n) Q ( n ) Q ( 2 ) = 1 Q(2)=1 Q ( 2 ) = 1 Q ( n ) = 4 Q ( n / 2 ) + 1 Q(n)=4Q(n/2)+1 Q ( n ) = 4 Q ( n /2 ) + 1
Q ( n ) = n 2 − 1 3 . Q(n)=\frac{n^2-1}{3}.
Q ( n ) = 3 n 2 − 1 .
当 n = 4 n=4 n = 4 ( 16 − 1 ) / 3 = 5 (16-1)/3=5 ( 16 − 1 ) /3 = 5 Θ ( n 2 ) \Theta(n^2) Θ ( n 2 )
练习:分析 Karger-Stein 随机最小割算法的递归复杂度。
课件给出的过程是:小于 6 个顶点时直接枚举;否则独立运行两次随机收缩,每次将 n n n n / 2 n/\sqrt2 n / 2 O ( n 2 ) O(n^2) O ( n 2 )
T ( n ) = 2 T ( ⌈ n 2 ⌉ ) + O ( n 2 ) . T(n)=2T\!\left(\left\lceil\frac n{\sqrt2}\right\rceil\right)+O(n^2).
T ( n ) = 2 T ( ⌈ 2 n ⌉ ) + O ( n 2 ) .
在主定理中 a = 2 a=2 a = 2 b = 2 b=\sqrt2 b = 2 log 2 2 = 2 \log_{\sqrt2}2=2 log 2 2 = 2 d = 2 d=2 d = 2 O ( n 2 log n ) O(n^2\log n) O ( n 2 log n ) Θ ( n 2 ) \Theta(n^2) Θ ( n 2 ) Θ ( n 2 log n ) \Theta(n^2\log n) Θ ( n 2 log n )
逆序对
逆序对 是序列中满足 i < j i<j i < j a i > a j a_i>a_j a i > a j 1 , 2 , … , n 1,2,\ldots,n 1 , 2 , … , n a 1 , a 2 , … , a n a_1,a_2,\ldots,a_n a 1 , a 2 , … , a n [ 1 , 3 , 4 , 2 , 5 ] [1,3,4,2,5] [ 1 , 3 , 4 , 2 , 5 ] ( 3 , 2 ) (3,2) ( 3 , 2 ) ( 4 , 2 ) (4,2) ( 4 , 2 )
直接枚举所有 i < j i<j i < j Θ ( n 2 ) \Theta(n^2) Θ ( n 2 ) A A A B B B A A A B B B A A A B B B
课件中的序列
[ 1 , 5 , 4 , 8 , 10 ∣ 2 , 6 , 9 , 3 , 7 ] [1,5,4,8,10\mid2,6,9,3,7]
[ 1 , 5 , 4 , 8 , 10 ∣ 2 , 6 , 9 , 3 , 7 ]
左半段有 1 1 1 3 3 3 1 , 5 , 4 , 8 , 10 1,5,4,8,10 1 , 5 , 4 , 8 , 10 0 , 2 , 2 , 4 , 5 0,2,2,4,5 0 , 2 , 2 , 4 , 5 13 13 13 1 + 3 + 13 = 17 1+3+13=17 1 + 3 + 13 = 17
合并问题 :若 A A A B B B a ∈ A , b ∈ B a\in A,b\in B a ∈ A , b ∈ B a > b a>b a > b b ∈ B b\in B b ∈ B A A A A A A A = [ 3 , 7 , 10 , 14 , 18 ] A=[3,7,10,14,18] A = [ 3 , 7 , 10 , 14 , 18 ] B = [ 2 , 11 , 16 , 20 , 23 ] B=[2,11,16,20,23] B = [ 2 , 11 , 16 , 20 , 23 ] b b b 5 , 2 , 1 , 0 , 0 5,2,1,0,0 5 , 2 , 1 , 0 , 0 8 8 8 O ( n log n ) O(n\log n) O ( n log n ) O ( n log 2 n ) O(n\log^2 n) O ( n log 2 n )
还可以利用归并排序的线性合并过程。设 i , j i,j i , j A , B A,B A , B
若 A [ i ] ≤ B [ j ] A[i]\le B[j] A [ i ] ≤ B [ j ] A [ i ] A[i] A [ i ] B B B
若 A [ i ] > B [ j ] A[i]>B[j] A [ i ] > B [ j ] B [ j ] B[j] B [ j ] A A A A [ i ] A[i] A [ i ] ∣ A ∣ − i + 1 |A|-i+1 ∣ A ∣ − i + 1 B [ j ] B[j] B [ j ]
余下的一侧直接接到结果末尾。整个过程的指针只向右移动,因此合并、计数均为 O ( ∣ A ∣ + ∣ B ∣ ) O(|A|+|B|) O ( ∣ A ∣ + ∣ B ∣ )
算法:MERGE-AND-COUNT ( A , B ) 输入: 两个已排序数组 A , B i = 1 , j = 1 , r = 0 , C = [ ] while i ≤ ∣ A ∣ 且 j ≤ ∣ B ∣ do if A [ i ] ≤ B [ j ] then 将 A [ i ] 接到 C , i = i + 1 else r = r + ∣ A ∣ − i + 1 , 将 B [ j ] 接到 C , j = j + 1 将 A , B 尚未处理的元素依次接到 C return ( r , C ) \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:MERGE-AND-COUNT}(A,B) \\[4pt]
\hline
\textbf{输入:}\ \text{两个已排序数组 }A,B \\
i=1,\ j=1,\ r=0,\ C=[\ ] \\
\textbf{while}\ i\le|A|\ \text{且}\ j\le|B|\ \textbf{do} \\
\qquad\textbf{if}\ A[i]\le B[j]\ \textbf{then}\ \text{将 }A[i]\text{ 接到 }C,\ i=i+1 \\
\qquad\textbf{else}\ r=r+|A|-i+1,\ \text{将 }B[j]\text{ 接到 }C,\ j=j+1 \\
\text{将 }A,B\text{ 尚未处理的元素依次接到 }C \\
\text{return}\ (r,C) \\
\hline
\end{array}&&
\end{aligned}
算法: MERGE-AND-COUNT ( A , B ) 输入: 两个已排序数组 A , B i = 1 , j = 1 , r = 0 , C = [ ] while i ≤ ∣ A ∣ 且 j ≤ ∣ B ∣ do if A [ i ] ≤ B [ j ] then 将 A [ i ] 接到 C , i = i + 1 else r = r + ∣ A ∣ − i + 1 , 将 B [ j ] 接到 C , j = j + 1 将 A , B 尚未处理的元素依次接到 C return ( r , C )
把合并计数嵌入归并排序,即得到 SORT-AND-COUNT :
算法:SORT-AND-COUNT ( L ) 输入: 序列 L if ∣ L ∣ ≤ 1 then return ( 0 , L ) 把 L 分成前半段 A 和后半段 B ( r A , A ′ ) = SORT-AND-COUNT ( A ) ( r B , B ′ ) = SORT-AND-COUNT ( B ) ( r A B , C ) = MERGE-AND-COUNT ( A ′ , B ′ ) return ( r A + r B + r A B , C ) \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:SORT-AND-COUNT}(L) \\[4pt]
\hline
\textbf{输入:}\ \text{序列 }L \\
\textbf{if}\ |L|\le1\ \textbf{then}\ \text{return}\ (0,L) \\
\text{把 }L\text{ 分成前半段 }A\text{ 和后半段 }B \\
(r_A,A')=\text{SORT-AND-COUNT}(A) \\
(r_B,B')=\text{SORT-AND-COUNT}(B) \\
(r_{AB},C)=\text{MERGE-AND-COUNT}(A',B') \\
\text{return}\ (r_A+r_B+r_{AB},C) \\
\hline
\end{array}&&
\end{aligned}
算法: SORT-AND-COUNT ( L ) 输入: 序列 L if ∣ L ∣ ≤ 1 then return ( 0 , L ) 把 L 分成前半段 A 和后半段 B ( r A , A ′ ) = SORT-AND-COUNT ( A ) ( r B , B ′ ) = SORT-AND-COUNT ( B ) ( r A B , C ) = MERGE-AND-COUNT ( A ′ , B ′ ) return ( r A + r B + r A B , C )
正确性可对序列长度归纳:递归结果已分别正确统计两半内部的逆序对,并给出有序的 A ′ , B ′ A',B' A ′ , B ′ C C C
T ( n ) = T ( ⌊ n / 2 ⌋ ) + T ( ⌈ n / 2 ⌉ ) + Θ ( n ) = Θ ( n log n ) . T(n)=T(\lfloor n/2\rfloor)+T(\lceil n/2\rceil)+\Theta(n)
=\Theta(n\log n).
T ( n ) = T (⌊ n /2 ⌋) + T (⌈ n /2 ⌉) + Θ ( n ) = Θ ( n log n ) .
这个界按常数时间比较、索引和计数的通常模型计算;总数最多为 n ( n − 1 ) / 2 n(n-1)/2 n ( n − 1 ) /2 O ( log n ) O(\log n) O ( log n )
复数与单位根
快速傅里叶变换会在一组特殊的复数点上求多项式值。复数 z = a + b i z=a+bi z = a + bi ( a , b ) (a,b) ( a , b )
z = r ( cos θ + i sin θ ) = r e i θ , r = a 2 + b 2 , z=r(\cos\theta+i\sin\theta)=re^{i\theta},
\qquad r=\sqrt{a^2+b^2},
z = r ( cos θ + i sin θ ) = r e i θ , r = a 2 + b 2 ,
其中角度 θ \theta θ 2 π 2\pi 2 π − 1 = e i π -1=e^{i\pi} − 1 = e iπ i = e i π / 2 i=e^{i\pi/2} i = e iπ /2 5 + 5 i = 5 2 e i π / 4 5+5i=5\sqrt2e^{i\pi/4} 5 + 5 i = 5 2 e iπ /4
( r 1 e i θ 1 ) ( r 2 e i θ 2 ) = r 1 r 2 e i ( θ 1 + θ 2 ) . (r_1e^{i\theta_1})(r_2e^{i\theta_2})
=r_1r_2e^{i(\theta_1+\theta_2)}.
( r 1 e i θ 1 ) ( r 2 e i θ 2 ) = r 1 r 2 e i ( θ 1 + θ 2 ) .
因此 − z = r e i ( θ + π ) -z=re^{i(\theta+\pi)} − z = r e i ( θ + π ) ∣ z ∣ = 1 |z|=1 ∣ z ∣ = 1 z n = e i n θ z^n=e^{in\theta} z n = e in θ z n = 1 z^n=1 z n = 1
n n n ω = e 2 π i / n \omega=e^{2\pi i/n} ω = e 2 πi / n z n = 1 z^n=1 z n = 1 n n n 1 , ω , ω 2 , … , ω n − 1 1,\omega,\omega^2,\ldots,\omega^{n-1} 1 , ω , ω 2 , … , ω n − 1
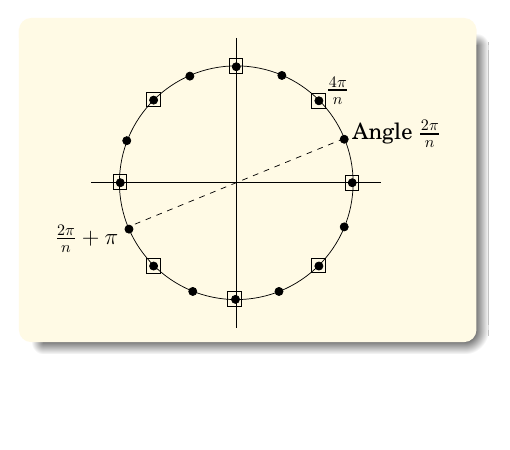
当 n n n ω j + n / 2 = − ω j \omega^{j+n/2}=-\omega^j ω j + n /2 = − ω j ω 2 j = ( ω 2 ) j \omega^{2j}=(\omega^2)^j ω 2 j = ( ω 2 ) j ω 2 \omega^2 ω 2 n / 2 n/2 n /2 将配对的点平方后,得到规模减半但结构相同的一组点 。这正是后文递归可以继续进行的原因。
图中以 n = 16 n=16 n = 16 π \pi π
复共轭将在插值时使用。若 z = r e i θ = a + b i z=re^{i\theta}=a+bi z = r e i θ = a + bi z ‾ = r e − i θ = a − b i \overline z=re^{-i\theta}=a-bi z = r e − i θ = a − bi
⟨ u , v ⟩ = ∑ j = 0 n − 1 u j v j ‾ . \langle u,v\rangle=\sum_{j=0}^{n-1}u_j\overline{v_j}.
⟨ u , v ⟩ = j = 0 ∑ n − 1 u j v j .
内积为零时,两个复向量正交。对矩阵逐项取共轭再转置,得到共轭转置 M ∗ M^* M ∗
多项式乘法
设两个次数至多为 d d d
A ( x ) = ∑ j = 0 d a j x j , B ( x ) = ∑ j = 0 d b j x j . A(x)=\sum_{j=0}^{d}a_jx^j,
\qquad
B(x)=\sum_{j=0}^{d}b_jx^j.
A ( x ) = j = 0 ∑ d a j x j , B ( x ) = j = 0 ∑ d b j x j .
乘积 C ( x ) = A ( x ) B ( x ) = ∑ k = 0 2 d c k x k C(x)=A(x)B(x)=\sum_{k=0}^{2d}c_kx^k C ( x ) = A ( x ) B ( x ) = ∑ k = 0 2 d c k x k 卷积公式
c k = ∑ j = 0 k a j b k − j , c_k=\sum_{j=0}^{k}a_jb_{k-j},
c k = j = 0 ∑ k a j b k − j ,
其中越过 0 , … , d 0,\ldots,d 0 , … , d 2 d + 1 2d+1 2 d + 1 Θ ( d 2 ) \Theta(d^2) Θ ( d 2 )
多项式还有取值表示 :次数不超过 d d d d + 1 d+1 d + 1 d d d d + 1 d+1 d + 1
乘积次数至多为 2 d 2d 2 d n ≥ 2 d + 1 n\ge2d+1 n ≥ 2 d + 1 x 0 , … , x n − 1 x_0,\ldots,x_{n-1} x 0 , … , x n − 1
在这些点上分别计算 A ( x j ) A(x_j) A ( x j ) B ( x j ) B(x_j) B ( x j )
逐点相乘,得到 C ( x j ) = A ( x j ) B ( x j ) C(x_j)=A(x_j)B(x_j) C ( x j ) = A ( x j ) B ( x j )
从 C C C
已知两组取值时,第二步只需 O ( n ) O(n) O ( n ) O ( n ) O(n) O ( n ) Θ ( n 2 ) \Theta(n^2) Θ ( n 2 ) 快速傅里叶变换 (FFT)为特殊的取值点同时实现 O ( n log n ) O(n\log n) O ( n log n )
快速求值
把 A ( x ) A(x) A ( x )
3 + 4 x + 6 x 2 + 2 x 3 + x 4 + 10 x 5 = ( 3 + 6 x 2 + x 4 ) + x ( 4 + 2 x 2 + 10 x 4 ) . 3+4x+6x^2+2x^3+x^4+10x^5
=(3+6x^2+x^4)+x(4+2x^2+10x^4).
3 + 4 x + 6 x 2 + 2 x 3 + x 4 + 10 x 5 = ( 3 + 6 x 2 + x 4 ) + x ( 4 + 2 x 2 + 10 x 4 ) .
一般地,设
A e ( t ) = a 0 + a 2 t + a 4 t 2 + ⋯ , A o ( t ) = a 1 + a 3 t + a 5 t 2 + ⋯ , A_e(t)=a_0+a_2t+a_4t^2+\cdots,
\qquad
A_o(t)=a_1+a_3t+a_5t^2+\cdots,
A e ( t ) = a 0 + a 2 t + a 4 t 2 + ⋯ , A o ( t ) = a 1 + a 3 t + a 5 t 2 + ⋯ ,
则 A ( x ) = A e ( x 2 ) + x A o ( x 2 ) A(x)=A_e(x^2)+xA_o(x^2) A ( x ) = A e ( x 2 ) + x A o ( x 2 ) x , − x x,-x x , − x A e ( x 2 ) A_e(x^2) A e ( x 2 ) A o ( x 2 ) A_o(x^2) A o ( x 2 )
A ( x ) = A e ( x 2 ) + x A o ( x 2 ) , A ( − x ) = A e ( x 2 ) − x A o ( x 2 ) . A(x)=A_e(x^2)+xA_o(x^2),
\qquad
A(-x)=A_e(x^2)-xA_o(x^2).
A ( x ) = A e ( x 2 ) + x A o ( x 2 ) , A ( − x ) = A e ( x 2 ) − x A o ( x 2 ) .
课件提问:怎样选点,才能在下一层继续递归?
下一层的点是本层一半点的平方,因此它们也必须可以两两配成相反数。从最底层的点 1 1 1 ± 1 \pm1 ± 1 ± 1 , ± i \pm1,\pm i ± 1 , ± i n n n n / 2 n/2 n /2
取 n n n ω = e 2 π i / n \omega=e^{2\pi i/n} ω = e 2 πi / n n n n FFT 计算的就是
FFT ( a , ω ) = ( A ( 1 ) , A ( ω ) , … , A ( ω n − 1 ) ) , a = ( a 0 , … , a n − 1 ) . \operatorname{FFT}(a,\omega)
=\bigl(A(1),A(\omega),\ldots,A(\omega^{n-1})\bigr),
\qquad a=(a_0,\ldots,a_{n-1}).
FFT ( a , ω ) = ( A ( 1 ) , A ( ω ) , … , A ( ω n − 1 ) ) , a = ( a 0 , … , a n − 1 ) .
递归对偶数下标系数和奇数下标系数分别调用 FFT,使用 ω 2 \omega^2 ω 2 n / 2 n/2 n /2
算法:FFT ( a , ω ) 输入: a = ( a 0 , … , a n − 1 ) , n 是 2 的幂; ω 是原始 n 次单位根 if n = 1 then return ( a 0 ) s = FFT ( ( a 0 , a 2 , … , a n − 2 ) , ω 2 ) t = FFT ( ( a 1 , a 3 , … , a n − 1 ) , ω 2 ) for j = 0 to n / 2 − 1 do r j = s j + ω j t j r j + n / 2 = s j − ω j t j return ( r 0 , r 1 , … , r n − 1 ) \begin{aligned}
&\begin{array}{l}
\hline
\textbf{算法:FFT}(a,\omega) \\[4pt]
\hline
\textbf{输入:}\ a=(a_0,\ldots,a_{n-1}),\ n\text{ 是 2 的幂;}\omega\text{ 是原始 }n\text{ 次单位根} \\
\textbf{if}\ n=1\ \textbf{then}\ \text{return}\ (a_0) \\
s=\text{FFT}((a_0,a_2,\ldots,a_{n-2}),\omega^2) \\
t=\text{FFT}((a_1,a_3,\ldots,a_{n-1}),\omega^2) \\
\textbf{for}\ j=0\ \textbf{to}\ n/2-1\ \textbf{do} \\
\qquad r_j=s_j+\omega^jt_j \\
\qquad r_{j+n/2}=s_j-\omega^jt_j \\
\text{return}\ (r_0,r_1,\ldots,r_{n-1}) \\
\hline
\end{array}&&
\end{aligned}
算法: FFT ( a , ω ) 输入: a = ( a 0 , … , a n − 1 ) , n 是 2 的幂; ω 是原始 n 次单位根 if n = 1 then return ( a 0 ) s = FFT (( a 0 , a 2 , … , a n − 2 ) , ω 2 ) t = FFT (( a 1 , a 3 , … , a n − 1 ) , ω 2 ) for j = 0 to n /2 − 1 do r j = s j + ω j t j r j + n /2 = s j − ω j t j return ( r 0 , r 1 , … , r n − 1 )
这里 s j = A e ( ω 2 j ) s_j=A_e(\omega^{2j}) s j = A e ( ω 2 j ) t j = A o ( ω 2 j ) t_j=A_o(\omega^{2j}) t j = A o ( ω 2 j ) A ( ω j ) A(\omega^j) A ( ω j ) ω j + n / 2 = − ω j \omega^{j+n/2}=-\omega^j ω j + n /2 = − ω j A ( ω j + n / 2 ) A(\omega^{j+n/2}) A ( ω j + n /2 ) O ( n ) O(n) O ( n )
T ( n ) = 2 T ( n / 2 ) + O ( n ) = O ( n log n ) . T(n)=2T(n/2)+O(n)=O(n\log n).
T ( n ) = 2 T ( n /2 ) + O ( n ) = O ( n log n ) .
课件的第一版伪代码按 j = 0 , … , n − 1 j=0,\ldots,n-1 j = 0 , … , n − 1
快速插值
设 a = ( a 0 , … , a n − 1 ) T a=(a_0,\ldots,a_{n-1})^{\mathsf T} a = ( a 0 , … , a n − 1 ) T n n n y y y j , k = 0 , … , n − 1 j,k=0,\ldots,n-1 j , k = 0 , … , n − 1
M n ( ω ) j k = ω j k . M_n(\omega)_{jk}=\omega^{jk}.
M n ( ω ) jk = ω jk .
于是 y = M n ( ω ) a y=M_n(\omega)a y = M n ( ω ) a O ( n 2 ) O(n^2) O ( n 2 ) O ( n log n ) O(n\log n) O ( n log n )
引理 :傅里叶矩阵的不同列相互正交,且每列的内积平方长度为 n n n
证明 :第 j j j k k k
∑ r = 0 n − 1 ω r ( j − k ) . \sum_{r=0}^{n-1}\omega^{r(j-k)}.
r = 0 ∑ n − 1 ω r ( j − k ) .
若 j = k j=k j = k n n n j ≠ k j\ne k j = k ω j − k ≠ 1 \omega^{j-k}\ne1 ω j − k = 1 ω n ( j − k ) = 1 \omega^{n(j-k)}=1 ω n ( j − k ) = 1
∑ r = 0 n − 1 ω r ( j − k ) = 1 − ω n ( j − k ) 1 − ω j − k = 0. \sum_{r=0}^{n-1}\omega^{r(j-k)}
=\frac{1-\omega^{n(j-k)}}{1-\omega^{j-k}}=0.
r = 0 ∑ n − 1 ω r ( j − k ) = 1 − ω j − k 1 − ω n ( j − k ) = 0.
由此 M n ( ω ) ∗ M n ( ω ) = n I M_n(\omega)^*M_n(\omega)=nI M n ( ω ) ∗ M n ( ω ) = n I M n ( ω ) − 1 = 1 n M n ( ω ) ∗ M_n(\omega)^{-1}=\frac1nM_n(\omega)^* M n ( ω ) − 1 = n 1 M n ( ω ) ∗ M n ( ω ) ∗ = M n ( ω − 1 ) M_n(\omega)^*=M_n(\omega^{-1}) M n ( ω ) ∗ = M n ( ω − 1 )
M n ( ω ) − 1 = 1 n M n ( ω − 1 ) . \boxed{M_n(\omega)^{-1}=\frac1nM_n(\omega^{-1})}.
M n ( ω ) − 1 = n 1 M n ( ω − 1 ) .
这说明插值只需再运行一次 FFT,并将结果逐项除以 n n n
a = 1 n FFT ( y , ω − 1 ) . \boxed{a=\frac1n\operatorname{FFT}(y,\omega^{-1})}.
a = n 1 FFT ( y , ω − 1 ) .
同样的偶、奇下标拆分适用于逆单位根 ω − 1 \omega^{-1} ω − 1 O ( n log n ) O(n\log n) O ( n log n ) n \sqrt n n
FFT 乘法
至此可以把多项式乘法的四个步骤具体化。对次数至多为 d d d A , B A,B A , B 2 d + 1 2d+1 2 d + 1 n n n n n n ω = e 2 π i / n \omega=e^{2\pi i/n} ω = e 2 πi / n
u = FFT ( a , ω ) , v = FFT ( b , ω ) , w j = u j v j ( 0 ≤ j < n ) , c = 1 n FFT ( w , ω − 1 ) . \begin{aligned}
u&=\operatorname{FFT}(a,\omega),\\
v&=\operatorname{FFT}(b,\omega),\\
w_j&=u_jv_j\quad(0\le j<n),\\
c&=\frac1n\operatorname{FFT}(w,\omega^{-1}).
\end{aligned}
u v w j c = FFT ( a , ω ) , = FFT ( b , ω ) , = u j v j ( 0 ≤ j < n ) , = n 1 FFT ( w , ω − 1 ) .
最后取 c 0 , … , c 2 d c_0,\ldots,c_{2d} c 0 , … , c 2 d n ≥ 2 d + 1 n\ge2d+1 n ≥ 2 d + 1 n n n
例如 A ( x ) = 1 + x A(x)=1+x A ( x ) = 1 + x B ( x ) = 1 − x B(x)=1-x B ( x ) = 1 − x n = 4 n=4 n = 4 ω = i \omega=i ω = i 1 , i , − 1 , − i 1,i,-1,-i 1 , i , − 1 , − i ( 2 , 1 + i , 0 , 1 − i ) (2,1+i,0,1-i) ( 2 , 1 + i , 0 , 1 − i ) ( 0 , 1 − i , 2 , 1 + i ) (0,1-i,2,1+i) ( 0 , 1 − i , 2 , 1 + i ) ( 0 , 2 , 0 , 2 ) (0,2,0,2) ( 0 , 2 , 0 , 2 ) ( 1 , 0 , − 1 , 0 ) (1,0,-1,0) ( 1 , 0 , − 1 , 0 ) C ( x ) = 1 − x 2 C(x)=1-x^2 C ( x ) = 1 − x 2
两次正向 FFT、一次逆向 FFT 各耗时 O ( n log n ) O(n\log n) O ( n log n ) O ( n ) O(n) O ( n ) n < 2 ( 2 d + 1 ) n<2(2d+1) n < 2 ( 2 d + 1 ) O ( d log d ) O(d\log d) O ( d log d ) d ≥ 1 d\ge1 d ≥ 1 Θ ( d 2 ) \Theta(d^2) Θ ( d 2 )