计算机系统工程-05:并发一致性
并发读写
多个用户同时读写数据时,系统需要规定操作的顺序,以及每次读取能看到哪些更新。数据有多个副本后,更新还要经过网络传播;消息延迟、节点故障和本地缓存都可能影响读取结果。
例如,两台手机各保存一份聊天记录。一台先发文件、再发引用,另一台可能先收到引用。两个人也可能各自看到接龙已有 17 人,同时把自己加在第 18 位。要解释这些结果,需要先了解读写、副本和消息传递,再讨论系统怎样安排顺序。
文件句柄、3FS 元数据与 native I/O 见分布式存储。下面从文件读取结果引出一致性,再用聊天记录逐步说明模型。
读写基础
程序保存在系统中的数据称为状态。聊天应用的状态可以是一份消息列表:[你好] 表示已有一条消息,[你好,谢谢] 表示已有两条。Write 或 Update 是写入、修改状态的操作;Read 是读取当前状态的操作。
状态机用“当前状态与操作决定下一状态”描述执行。例如列表先追加 X、再追加 Y,得到 [X,Y]。读取可以保持状态不变,但返回值取决于它在这些更新之间的位置:第一次追加后读取得到 [X],两次追加后读取得到 [X,Y]。
副本是同一份数据在另一位置保存的拷贝。手机、平板和服务器都可以保存聊天记录。缓存通常用于加快访问,副本还可以用于故障后继续服务;两者都需要处理内容更新。
程序的一次运行实例称为进程。进程可以依次执行多次操作,也可以与其他进程共同访问数据。客户端是发出请求的一方,服务器是接收请求、处理数据并返回结果的一方。一台电脑上可以同时运行多个客户端或服务器进程。
串行执行是做完一个操作后,再做下一个。并发执行时,多个操作的运行时间有重叠。例如 Alice 的消息还在等待回复,Bob 就已经发送了另一条消息。网络和服务器处理可能让这些操作以不同顺序完成。
内存保存正在使用的数据,程序可以快速访问;磁盘、SSD 等设备用于长期保存。断电后要保留的数据需要写入相应的稳定存储。下面每次提到“写入完成”,都要结合当时规定的确认条件理解。
图示读法
时序图中的每条横线或竖线代表一个参与者,例如客户端、服务器或某个副本。时间沿标有 time 的方向推进。箭头表示请求、回复或同步消息:箭头起点是发送,终点是接收,两者之间可能有网络等待。
ACK 是确认回复,Done 表示这次调用已按协议完成。RPC 是远程过程调用,客户端把函数参数发给服务器,由服务器执行并返回结果。RTT 是一次网络往返的时间,即请求发出后等到回复返回所用的网络时间。
图中的 x=1、f=v1 或 [你好] 都表示某一时刻的数据状态。沿时间方向逐步看每个箭头,再更新各条线上的状态,就能判断一次读取会得到什么。
文件读取
NFS 的 close-to-open 用法中,写入方关闭前,另一客户端可能仍读到旧版本;关闭后的写回与重新打开时的缓存检查见缓存更新。
GFS 的 primary 可以统一成功写入的顺序,失败写入仍可能只影响部分副本。下面专门检查这种状态下的读取;写入协议见写入文件。
思考题:GFS 已统一写入顺序,若某次写入只在部分副本完成并报告失败,两个客户端随后从不同副本读取,会得到什么?写入顺序与读取可见性各需要什么规则?
解答:
图中初始都为 A,写 B 只在节点 1、2 完成,节点 3 保留 A。客户端 1 可读到 B,随后客户端 2 从节点 3 读到 A。统一写入顺序规定副本怎样执行修改;读取规则还要明确失败或未确认修改是否可见、哪些副本可读。若要求统一的已确认读取状态,需要额外确认、验证或修复等待。
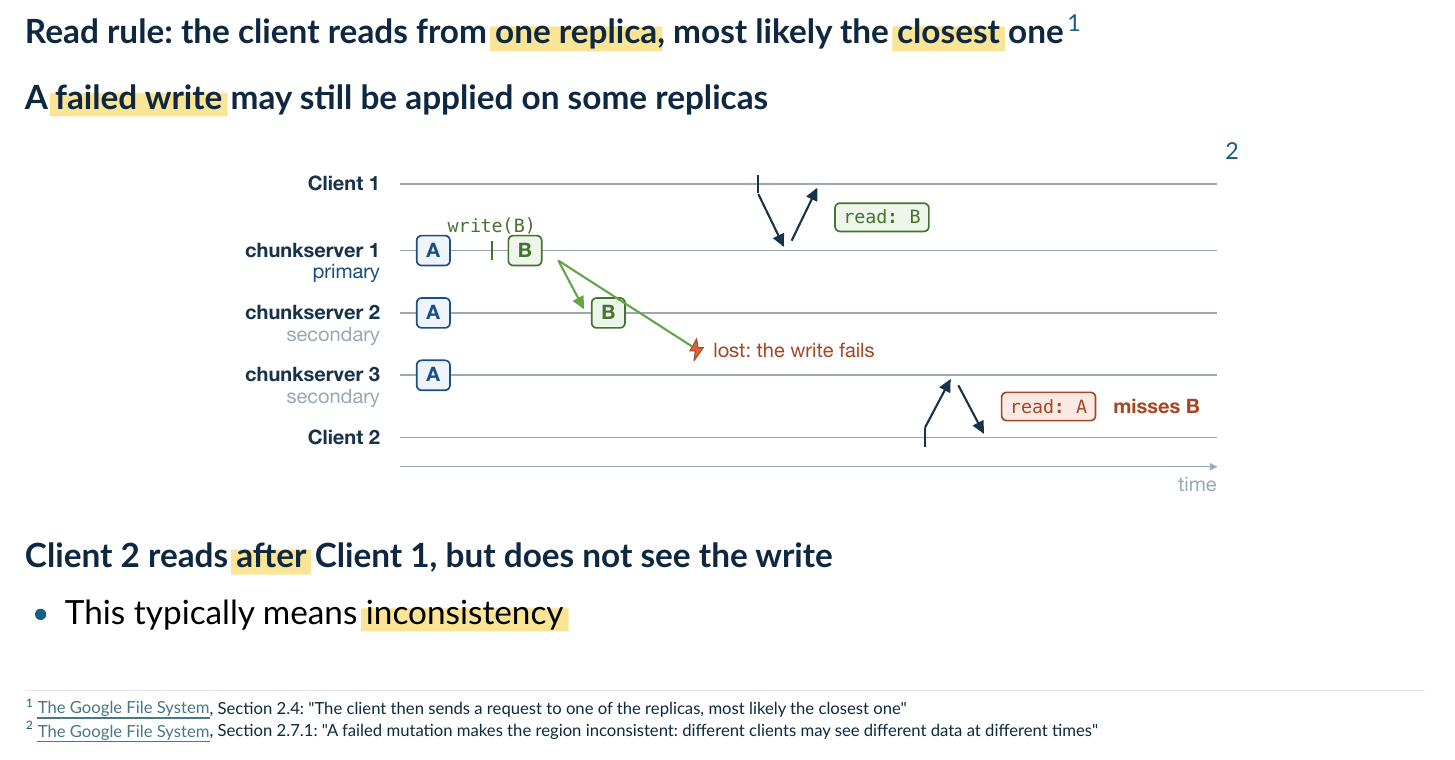
GFS 客户端通常从某个合适的副本直接读取,常会选择网络距离近的副本。失败写入可能留下部分修改,因此统一成功写入的顺序后,还需要规定失败期间允许怎样读取。一致性模型用来规定这些情况下允许返回的结果。
聊天记录
列表是一组有排列顺序的项。追加表示把新项放到末尾,[file,ref] 表示先有文件项,再有引用项。引用保存目标消息的标识,用户点击后,程序按这个标识寻找原消息和文件。目标消息还没到当前设备时,程序就需要等待取得它,才能显示引用内容。
聊天记录可以表示成一个列表,每项可以是文字或文件。更新操作 Update(msg/file) 向列表加入内容,读取操作 Read(history) 返回已有记录。
思考题:Alice 先发文件,再发引用它的消息,Bob 却先看到引用并提示“引用内容不存在”。哪些发送、同步和显示顺序可能产生这个结果?
解答:
Alice 本地产生文件,再产生引用,顺序为 file、ref。文件同步先启动,但传输较慢,引用先到服务器和 Bob;若按到达顺序立即显示,就先出现 ref,此时找不到目标。文件后来到达才补齐内容。要保留引用依赖,可记录目标消息 ID,并等目标可见后再展示引用。
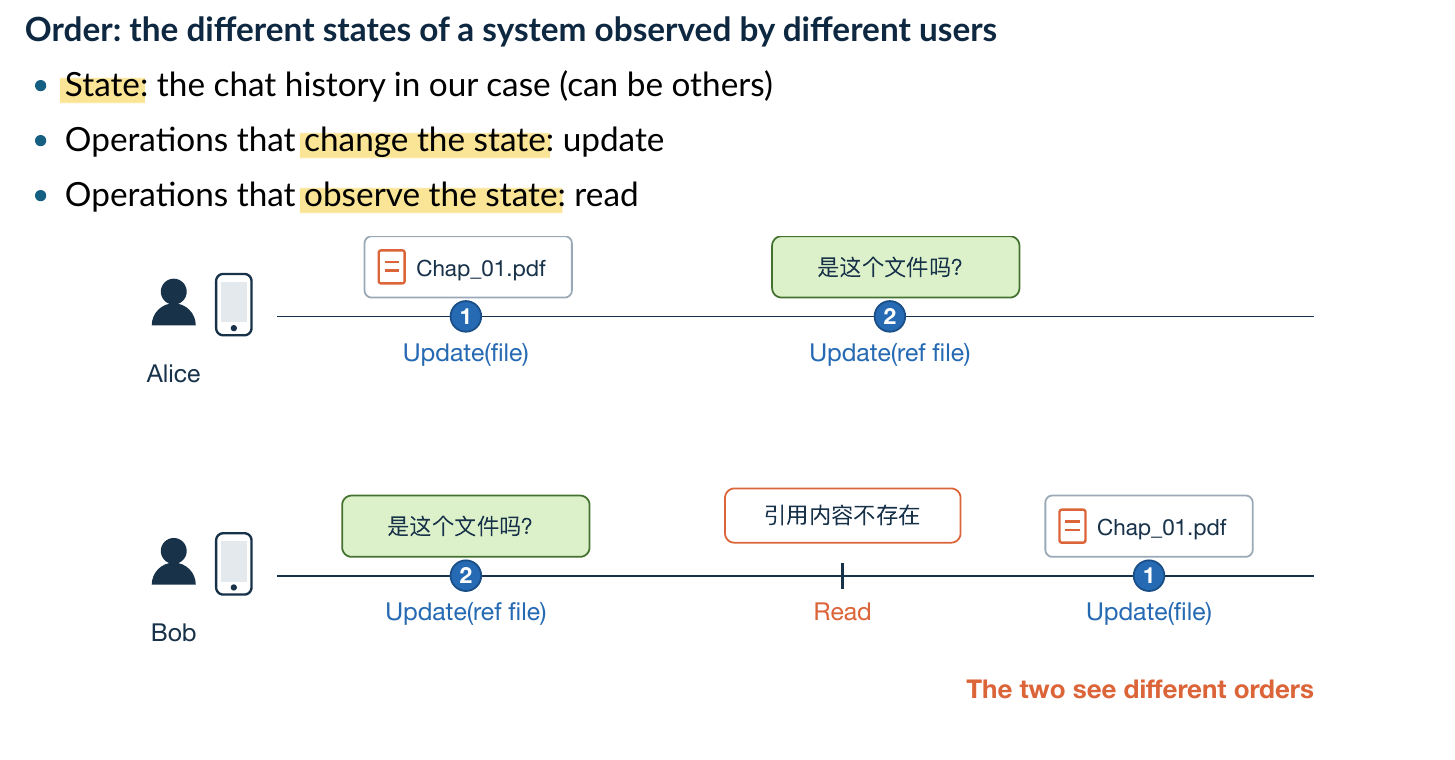
图中的文件是 Chap_01.pdf,“是这个文件吗?”这条消息保存了指向它的引用。
这里要分清三件事:用户创建更新的顺序、网络传递更新的顺序,以及设备显示更新的顺序。例子中 Alice 看到“文件、引用”,Bob 一度看到“引用、文件”。系统的一致性规则要说明这种情况是否允许,以及后来怎样处理。
这里用一个简化的传播过程解释这种可观察结果。实际“引用内容不存在”还可能与目标删除、权限或附件获取失败有关,需要记录消息与附件状态才能定位原因。分析一致性时,先明确假定哪些操作已发生、哪些消息已经到达,再检查允许的观察。
集中保存
在集中保存的实现里,服务器持有用于回答请求的列表。更新函数先修改列表,再返回确认;读取函数在安排好的位置取得当前列表。比如服务器已按顺序追加 A、B,读取就返回 [A,B]。同一台服务器有多个处理线程时,也要安排它们怎样共同访问这份列表。
先考虑一种简单实现:一台服务器保存完整聊天列表,所有更新和读取都通过 RPC。
思考题:由一台服务器统一追加消息,并让用户等待上次 ACK 后再发下一次请求,是否能保留这个用户的操作顺序?两项条件分别起什么作用?
解答:
在给定条件下,可以保留同一用户的顺序。服务器把上一条更新加入列表后才返回 ACK,用户收到它才发下一条,所以文件已加入后才可能发出引用。统一安排追加让读取取得同一份列表。重叠的其他用户请求则按服务器规定的合法顺序处理。
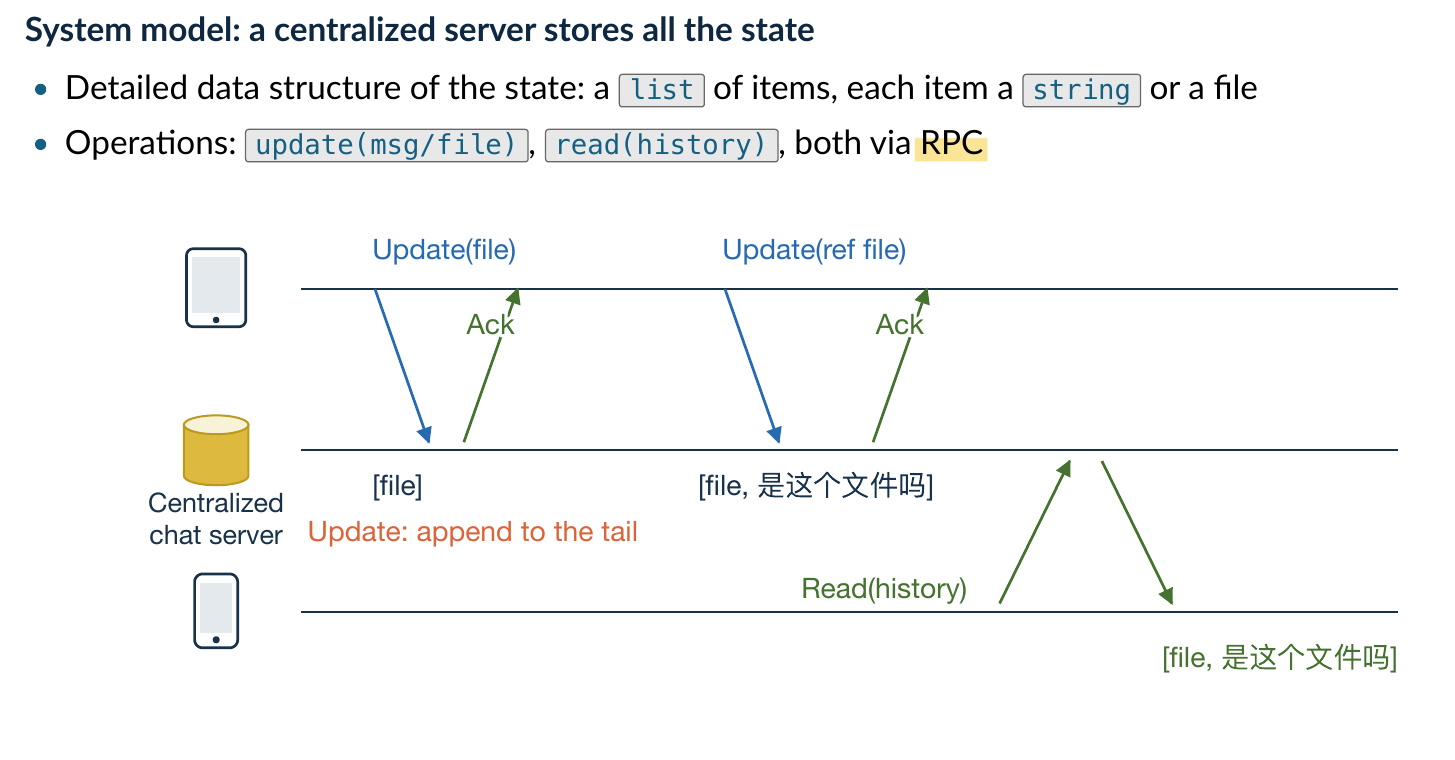
服务器收到 Update(file) 后追加文件,返回 ACK;用户收到回复后再发送 Update(ref file),服务器继续追加引用。随后读取就得到 [file,ref]。
这个例子的顺序成立需要两个条件:服务器统一安排追加顺序;每个用户收到上次调用的回复后再发下一次调用。服务器还应协调并发线程,保证每次追加和读取符合列表的操作规则。
这种实现有四项成本:
| 情况 | 对用户的影响 |
|---|---|
| 每次更新等待服务器回复 | 发消息要等待一次网络往返和服务器处理 |
| 每次读取返回全部历史 | 历史越长,需要传输的数据越多 |
| 设备离线 | 获取历史依赖服务器,本地也没有自己发过的完整记录 |
| 服务器失效 | 所有用户的远端更新和读取都要等待恢复 |
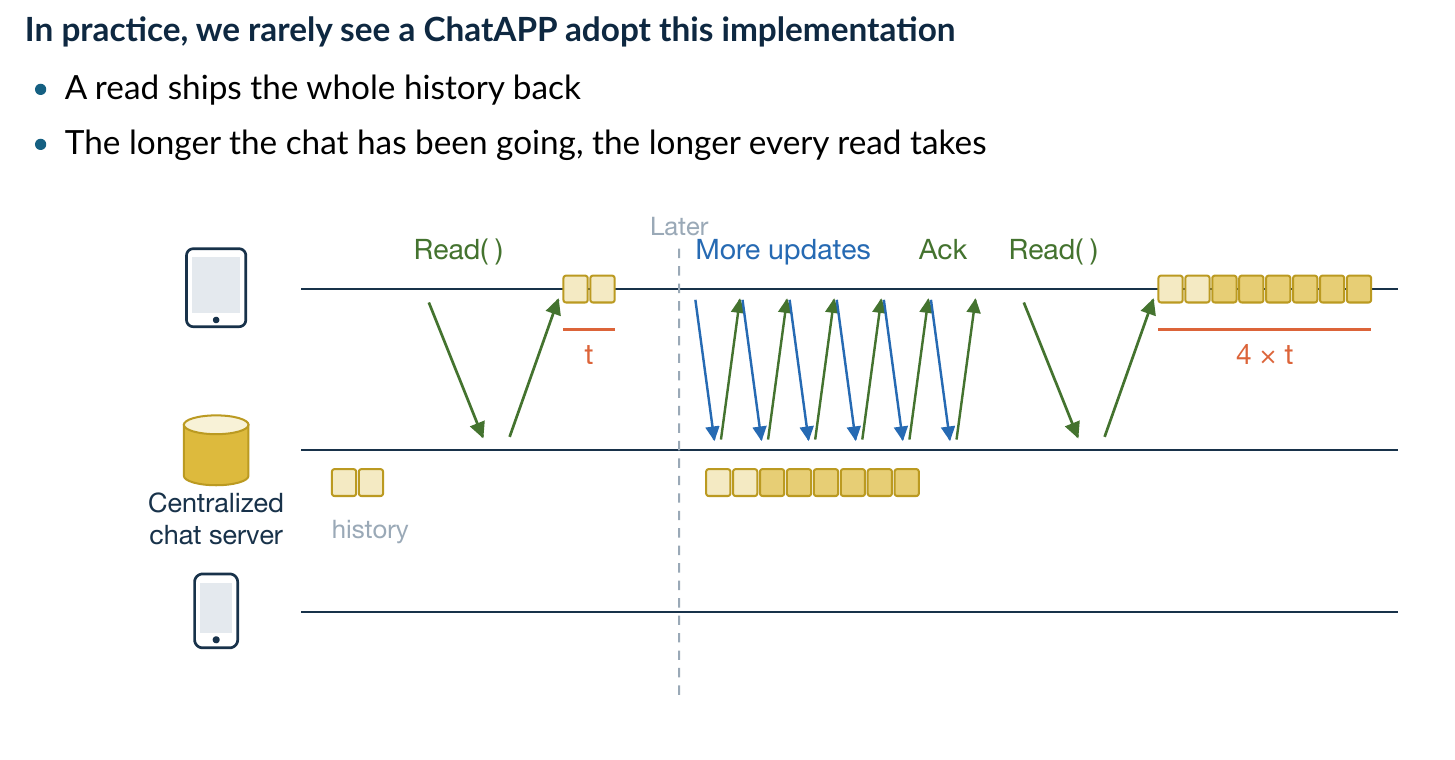
图中后一次历史量约为前一次的四倍,在相同带宽等简化条件下,传输时间由 t 增长到约 4t。按页加载、增量读取和本地缓存可以减少每次读取的数据量。
本地副本
一条新消息可以先写入当前设备,再发送给服务器或其他设备。当前设备立刻具备显示这条消息的内容,其他设备只有收到它之后才能显示。界面可以分别记录“已在本地保存”“已发送”“对方已收到”,让这些不同阶段有明确含义。
让手机、另一台设备和服务器各保存一份聊天列表,可以在设备上读取已有内容,也可以先保存自己刚发的消息。
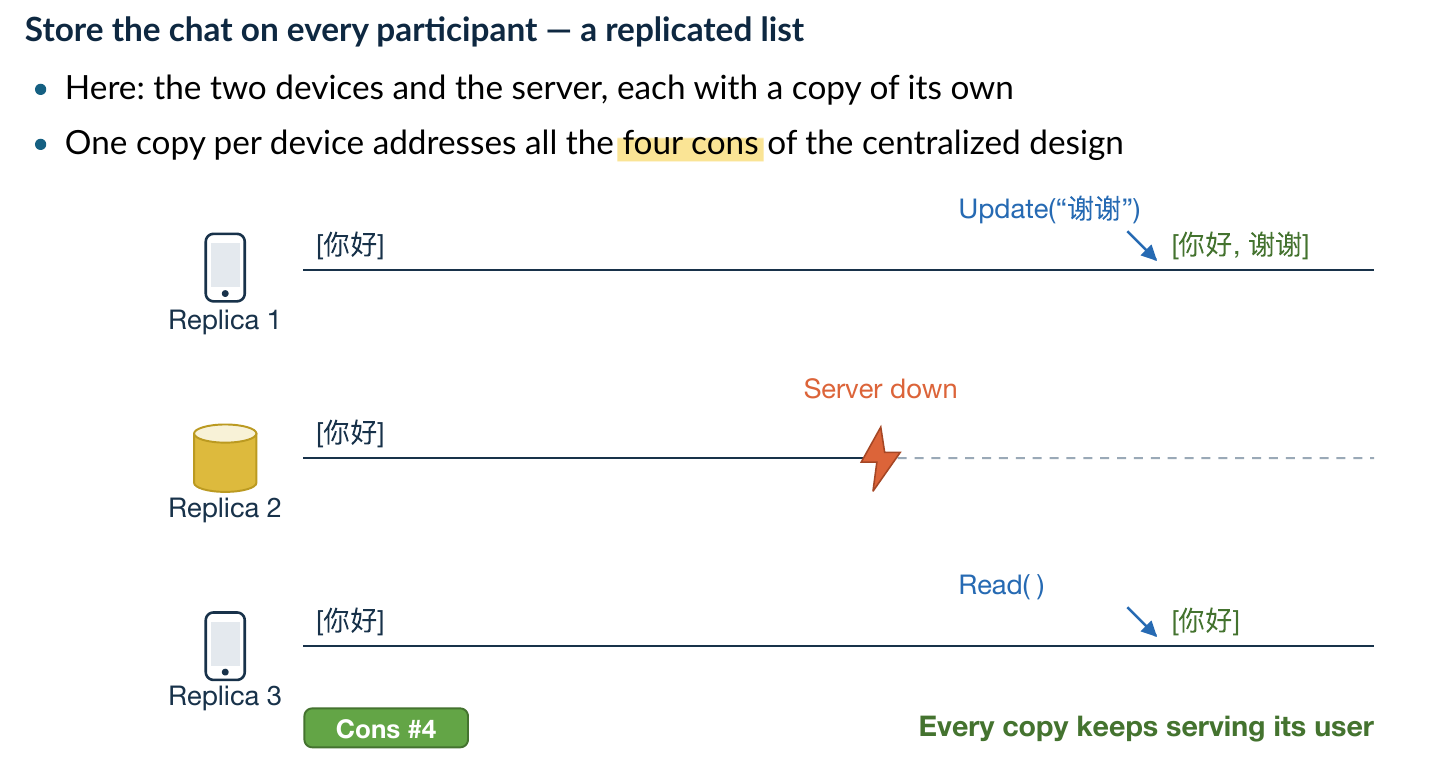
图中三个副本最初都有 [你好]。服务器失效后,副本 1 在本地加入“谢谢”,副本 3 仍能读到“你好”。设备恢复联系后再同步缺少的更新。
本地读写减少了等待:写入可以先完成本地处理,读取直接使用已保存的历史。离线时也能查看已有记录和暂存新消息。消息是否已经送达他人、是否已在远端保存,需要另外记录状态。
本地保存可以通过 SQLite 等本地数据库或日志实现,把消息 ID、内容、发送状态和待同步记录一起保存。进程退出或设备重启后,再从这些记录继续发送。界面上的“已显示”可以先于远端确认,应用需要按自己的语义标记当前阶段。
更新确认
确认是接收方按约定返回一条回复。例如一组确认条件要求本机和服务器都保存记录,这两方完成后即可报告成功,第三台设备稍后补齐。要求全部副本确认时,每一方的等待都计入这次请求;要求部分副本确认时,其他副本可能暂时缺少新记录。
只修改本地副本后,其他副本暂时还保留旧状态。系统需要传播更新,并规定在什么条件下向调用方报告完成。
思考题:只更新本地副本后,各设备会处于什么状态?一次写入要等多少个副本确认才返回?全部确认和部分确认分别影响哪些等待与故障情况?
解答:
只改本地时,一个副本已有新内容,其他副本仍保留旧内容。确认数量由协议规定:全部确认要等最慢的一方,失联节点会阻塞或使请求超时;部分确认在指定参与者完成后返回,其他节点后台补齐。成功回复所表示的保存和可见性程度,也必须与这些确认条件一起定义。
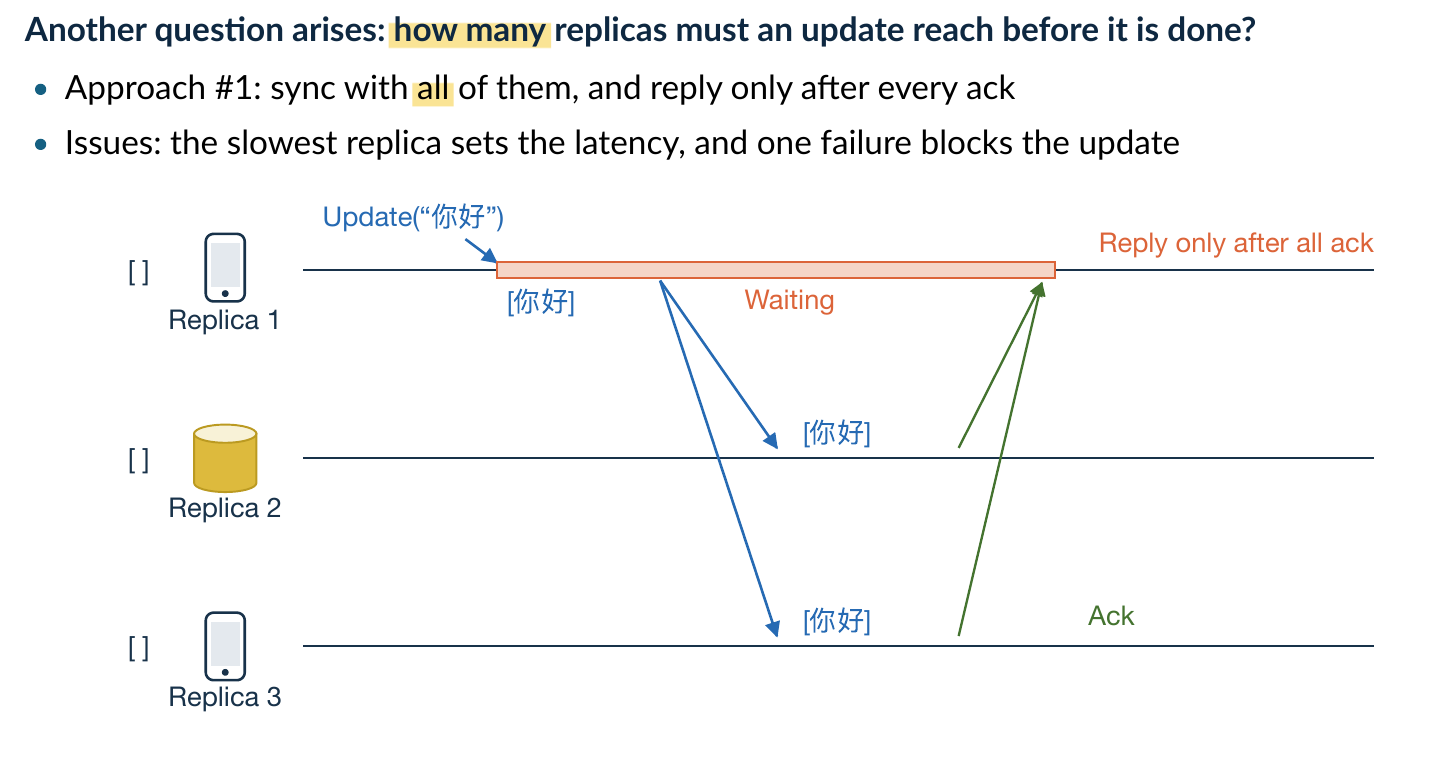
第一种做法要求每个副本都返回 ACK。所有副本完成后,调用方再收到成功回复。等待时间取决于最慢的一方;某个节点或链路失效时,写入可能一直等待或超时。
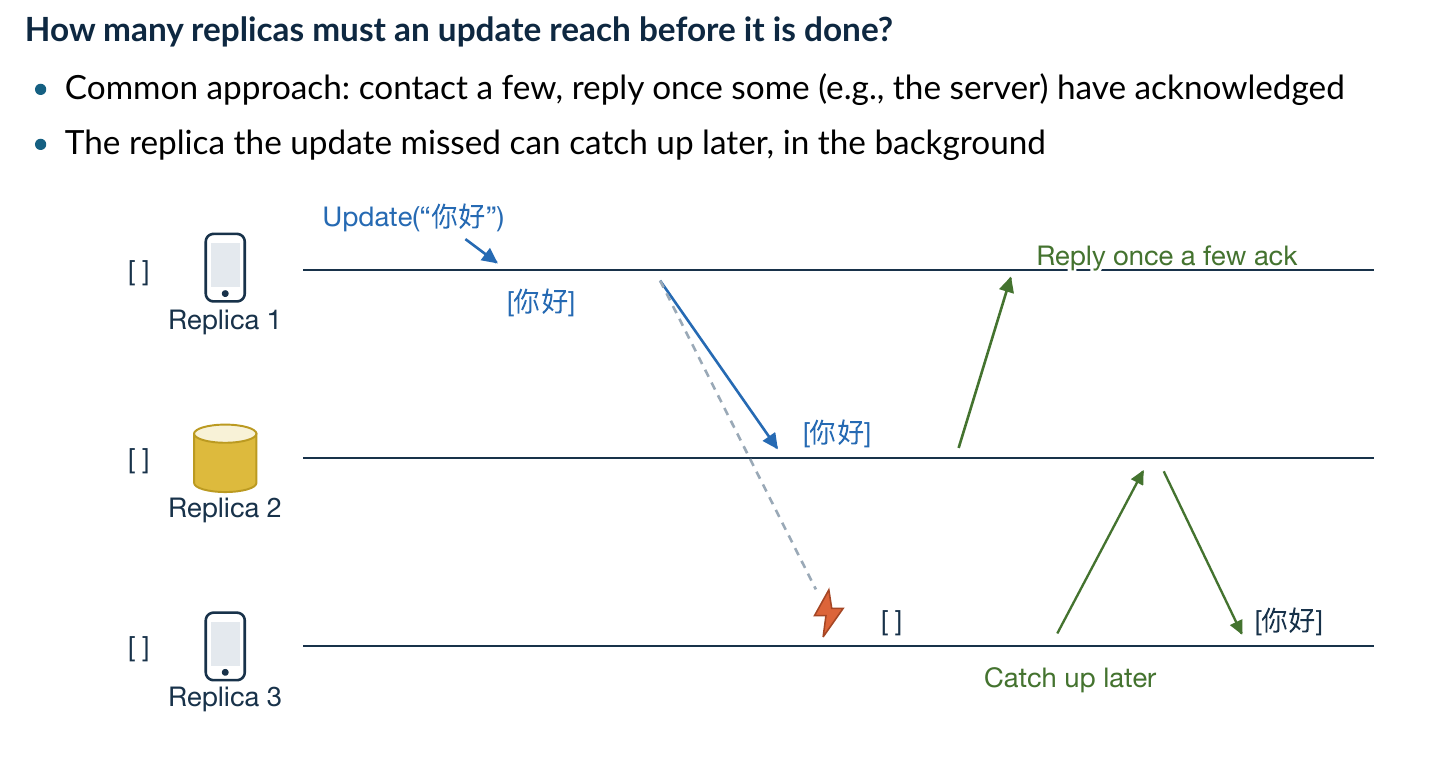
第二种做法先联系若干副本,例如本地设备和服务器,满足确认条件后返回。暂时失联的副本在后台补齐更新。
确认条件决定了这次成功所提供的保存与可见性保证。需要说明哪些节点已保存更新、哪些读取可能仍返回旧内容,以及后续如何补齐数据。
周期同步
同步交换设备已经收到的更新。设备可以保存上次同步位置或已知更新 ID,只请求缺少的记录。新消息到达、网络恢复或定时检查,都可以触发同步。一次同步可能带回多条消息,再逐条合并到本地列表。
读取本地副本时,返回的是这台设备已经收到的内容。其他设备刚产生的消息可能还在传输中。
思考题:读本地副本可以立即取得哪些消息?其他设备刚产生的更新何时能读到?周期同步与推送通知怎样补齐缺少的内容?
解答:
本地读取返回该设备已经收到的记录。新消息在传播完成前可能尚不可见,联网后通过同步补齐。周期检查定时交换缺少的更新,推送通知提醒设备有新内容并触发获取。图中的 10 s 是一次同步触发示例,实际可见时间还包含网络恢复、传输和处理等待。
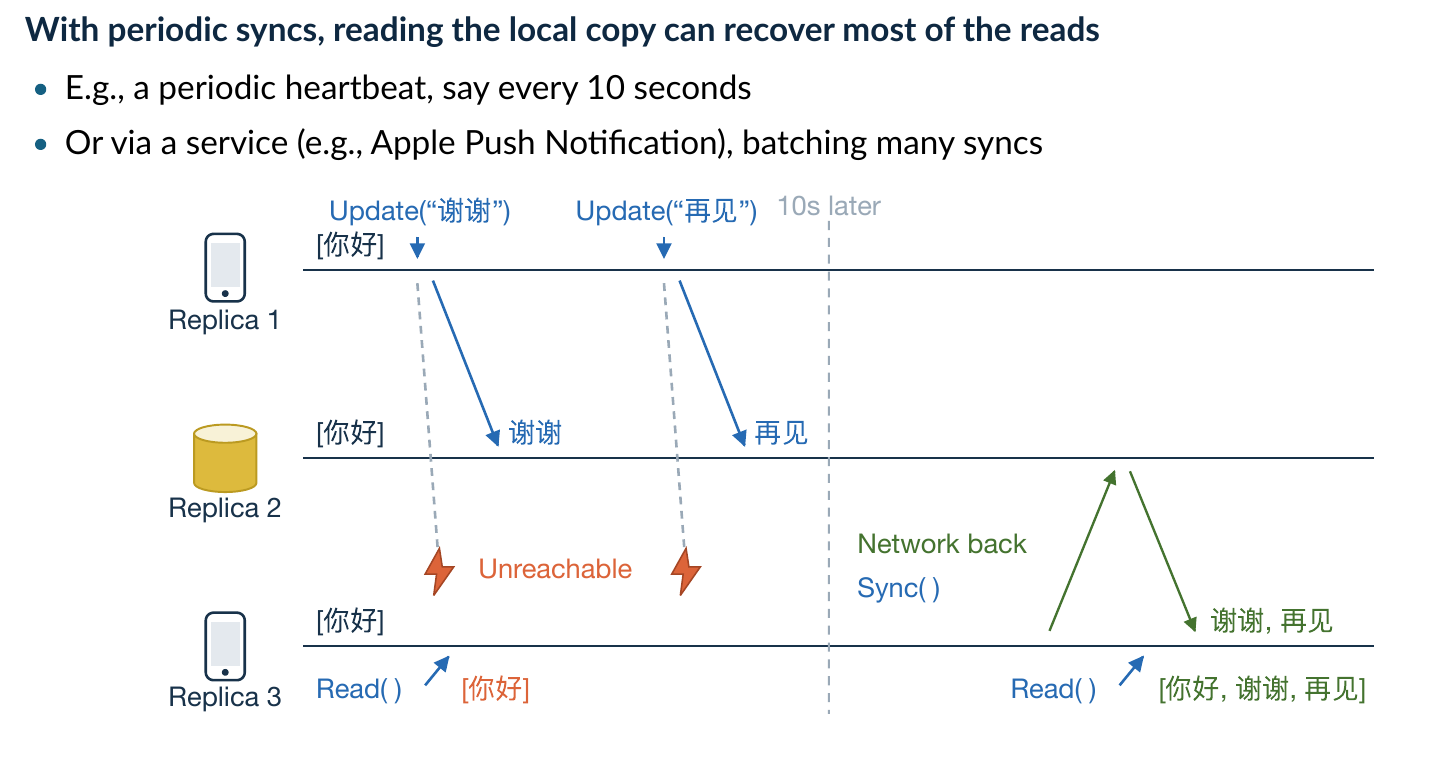
图中副本 1 先后产生“谢谢”和“再见”,副本 3 暂时失联,只能读取 [你好]。网络恢复后,同步带来两条更新,列表变成 [你好,谢谢,再见]。
可以每 10 秒通过心跳检查并同步,也可以使用 Apple Push Notification 等推送服务通知设备有新消息,再批量取得更新。同步间隔会影响更新多久可见;网络断开时,设备等待恢复后再继续交换记录。
推送通知可以触发一次增量获取,消息正文与附件还要按协议取得。一次同步可以合并多条更新,降低逐条往返的成本;重试重复带来的记录则按稳定 ID 检查。离线时间较长时,可以从服务器保留的日志或有效快照补齐状态。
到达顺序
把收到的更新立即追加到列表尾部,可能让同一批更新在各设备上排列不同。
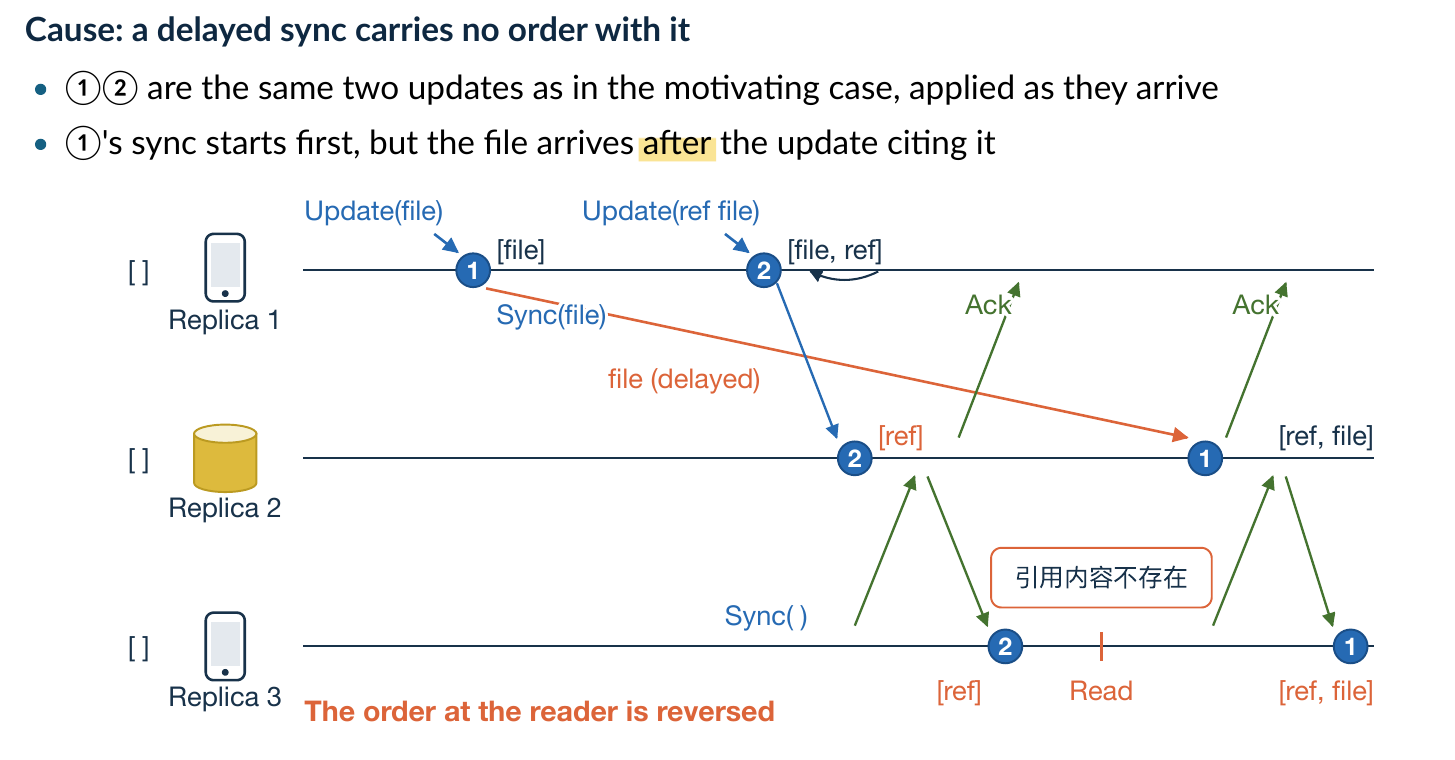
副本 1 先加入文件,再加入引用,本地为 [file,ref]。文件的同步先启动,但传输延迟;引用先到副本 2。副本 3 从服务器同步时也先收到引用,因此出现“引用内容不存在”。文件最后到达,按到达顺序追加就得到 [ref,file]。
两条更新最终都到了,显示顺序还需要由共同规则确定。系统要保存更新标识、依赖和排序信息,才能在不同到达顺序下得到约定的结果。
合并更新
合并要保留不同设备产生的新记录,并识别重复发送的同一记录。例如 R1:#8 是 R1 创建的第八条更新,重试时仍用这个 ID;接收方收到三次,也只加入一次。另一条内容相同、ID 为 R1:#9 的消息可以作为新的记录保留。
两台设备也可能从同一份历史开始,各自加入不同消息。
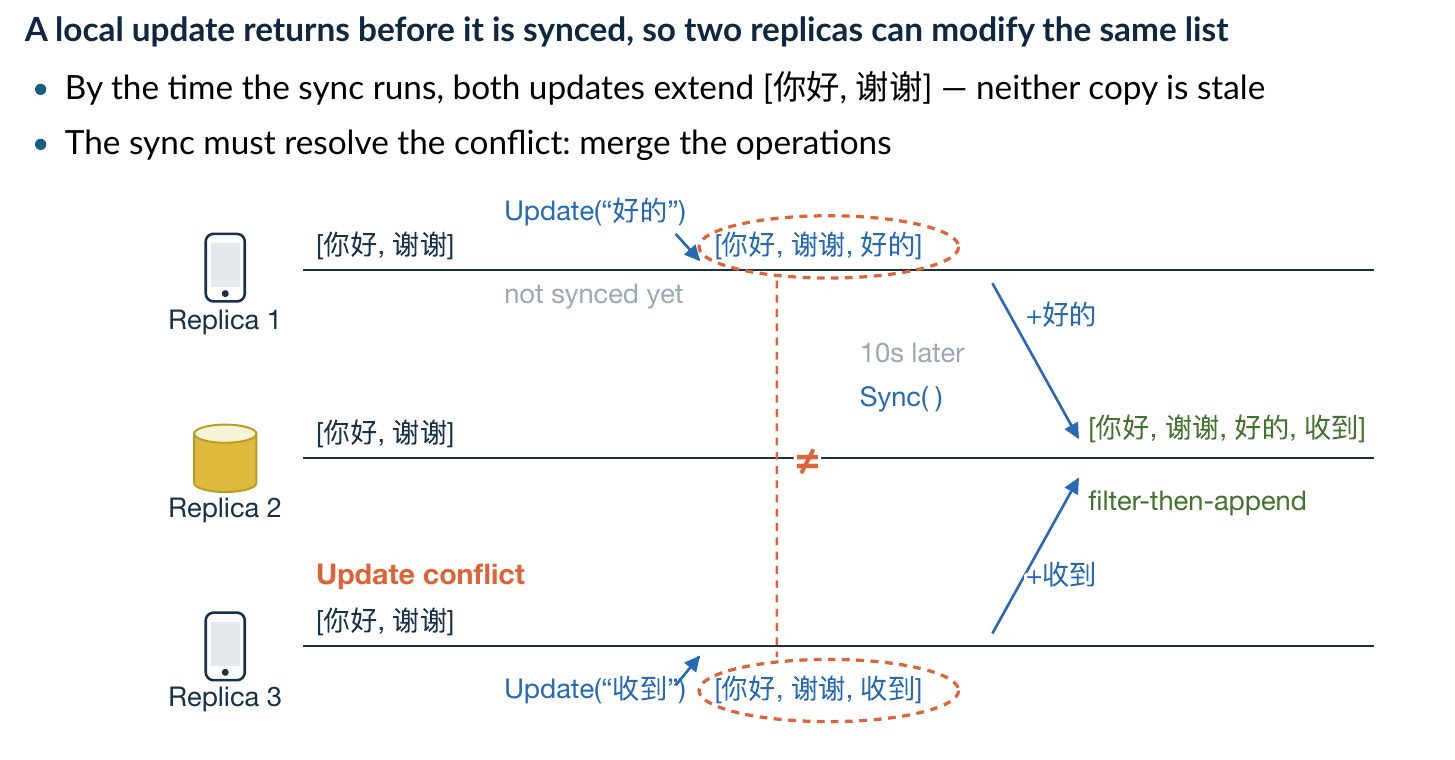
开始时都有 [你好,谢谢]。副本 1 加入“好的”,副本 3 加入“收到”。两份列表各自包含新更新,同步需要保留这两条消息。
若把收到的新消息追加在已有内容之后,副本 1 会得到 [你好,谢谢,好的,收到],副本 3 会得到 [你好,谢谢,收到,好的]。去重只能解决同一更新出现多次的问题,排列顺序还需要统一。
思考题:副本 1 先显示“好的”,副本 3 先显示“收到”。合并后若统一排列,能同时保留两边已经显示的顺序吗?应用要怎样处理消息移动?
解答:
统一后选“收到、好的”时,副本 1 原先显示的“好的”会向后移;选“好的、收到”时,副本 3 的显示会调整。因此,两边各自优先的临时观察需要由共同规则重新解释。聊天可标记待同步并合并更新;涉及业务名次时,应等确认或明确处理冲突。
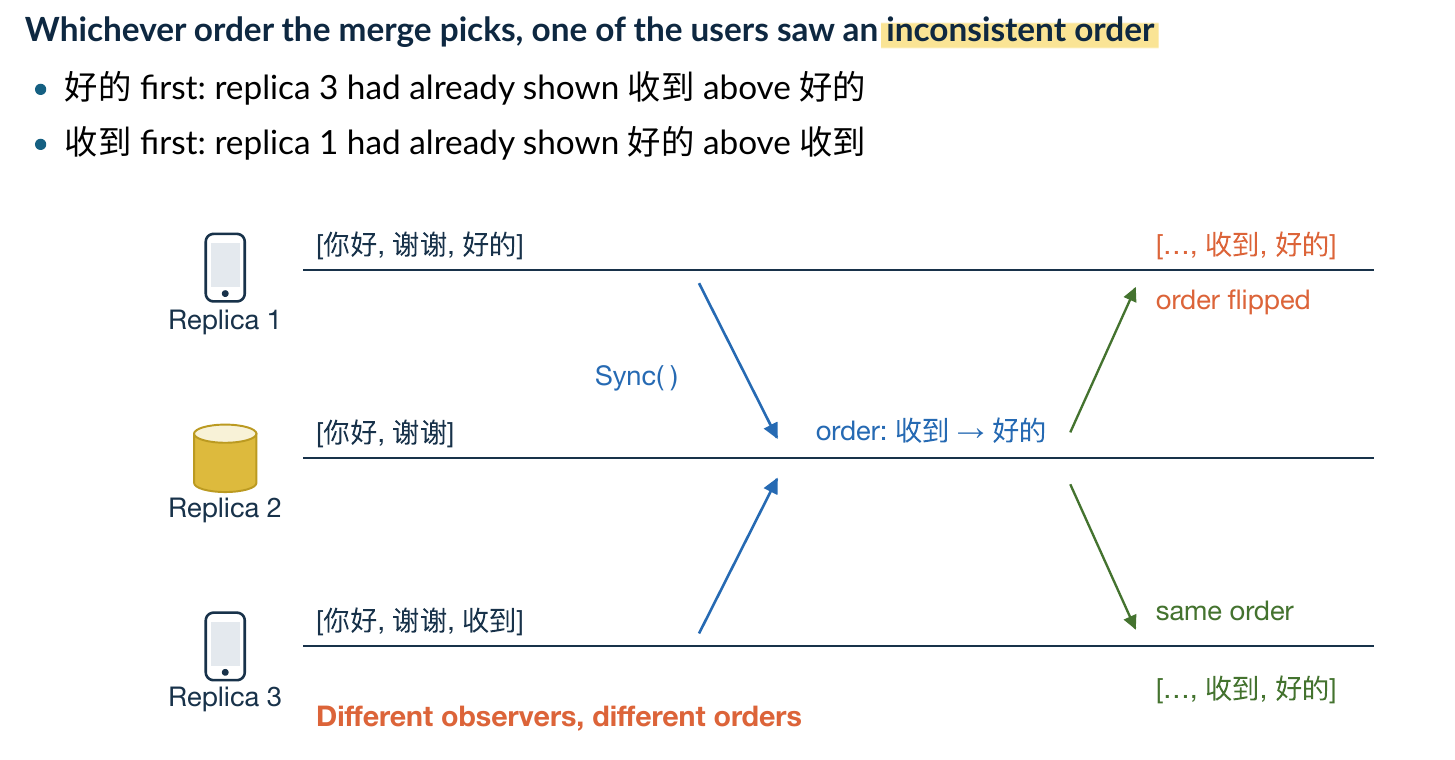
图中最终选定“收到、好的”,副本 1 原先显示的“好的”向后移动。若选定“好的、收到”,副本 3 的已有顺序就会变化。应用需要决定能否接受同步后的重新排列;聊天和按名次发奖的接龙可能有不同要求。
一致性模型
规定模型时,需要写出可检查的读取结果。比如 x 初始为 1,一次更新把它改为 2,随后另一个进程读取。模型要说明这次读能否返回 1、是否必须返回 2、需要等待什么条件。这样的规则让应用开发者知道可以依据哪次确认继续做下一步。
思考题:应用怎样通过一致性模型判断读取结果,而无需了解每条同步消息?应先确定哪些业务要求,再选择可实现的保证?
解答:
一致性模型规定允许的操作顺序和读取结果,开发者据此判断已确认更新是否应可见、引用是否需等待目标,以及是否允许临时旧值。选择前应确定离线操作、名次变化和冲突处理等业务要求,再检查实现的同步、排序和恢复机制能否提供相应保证。
一致性模型规定更新的可见性和操作的顺序,也就是每次读取可以返回哪些结果。它适用于数据副本、缓存、多核或多机并发,以及故障恢复中的读写。
观察到不同数值,需要结合操作历史判断。例如 x 从 1 改到 2,较早读取返回 1、较晚读取返回 2,本来就可以符合规则。若写入已确认后另一读取仍返回 1,是否允许取决于所选模型及确认条件。
这份约定也划分了应用和存储系统的职责。假设报名程序需要“确认成功后,任何后续查询都包含这次报名”,它就应选择提供相应保证的读取接口。若接口允许旧值,程序需要定义等待、重试和待确认状态。数据是否有复制、缓存或并发访问,都是检查这些条件的线索。
检查一段历史时,可以记录操作的发起、返回、输入与结果,寻找符合对象规则的解释。业务还可以有额外条件:转账保持总额、引用指向存在的目标、名次按确认规则分配。这些条件需要与一致性模型共同满足。
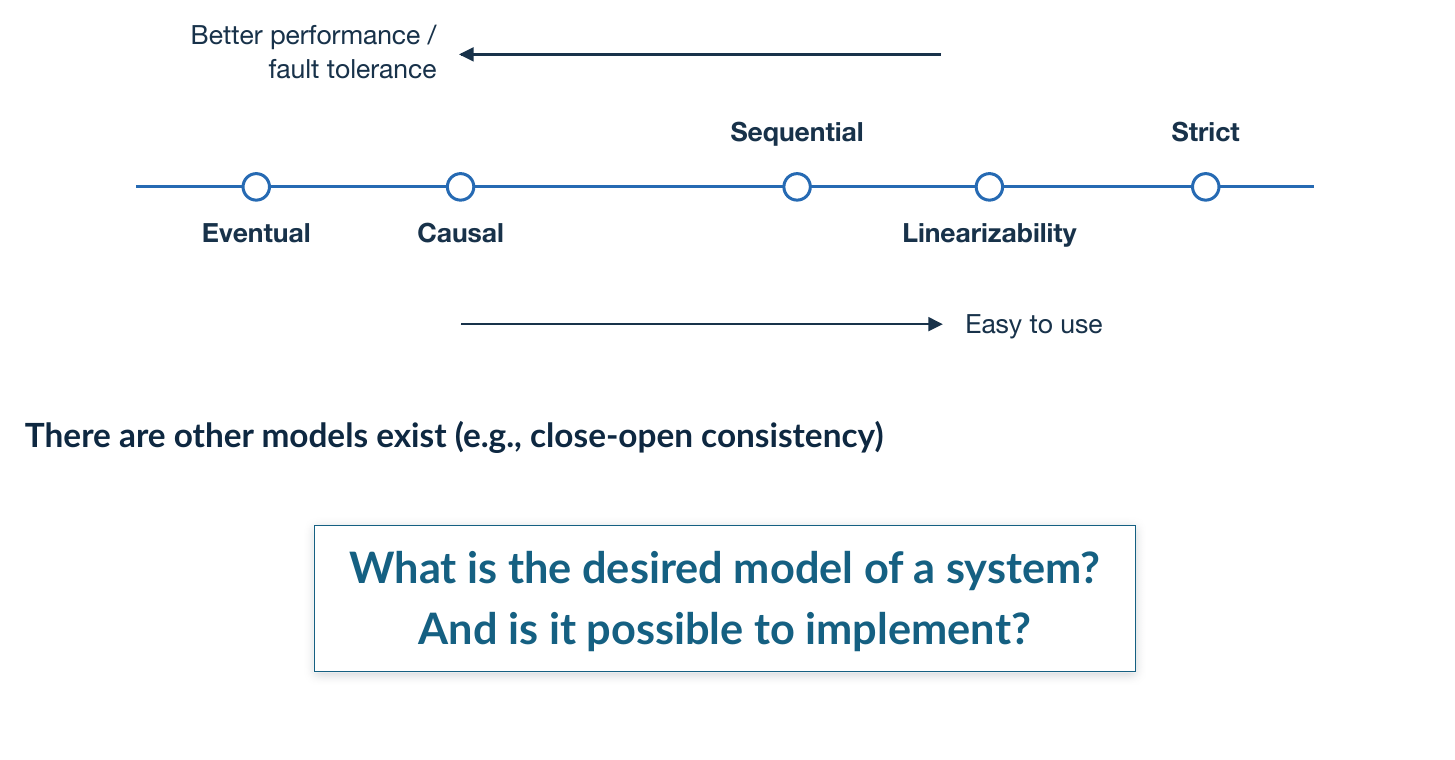
| 模型 | 主要要求 |
|---|---|
| 最终一致性 | 更新停止并完成传播后,各副本收敛到相同状态 |
| 因果一致性 | 有依赖的更新按因果顺序可见 |
| 顺序一致性 | 所有操作可解释为一个共同的串行顺序,并保留每个进程的程序顺序 |
| 线性一致性 | 在合法串行顺序中,保留操作完成到后续操作发起的实时先后关系 |
| 严格一致性 | 按全局实际发起时间规定操作顺序 |
模型对结果的要求越多,实现就需要满足更多协调条件。图中的性能和容错箭头概括了常见设计选择,实际速度还取决于算法、负载、网络和硬件。具有相同一致性保证的系统也可以采用不同架构。
选择模型时,先写清楚应用要求:消息是否允许延迟出现,引用是否要等目标内容到齐,接龙的名次是否允许同步后变化。再判断实现提供的保证能否满足这些要求。
最终一致性
收敛表示各副本经过同步后,内容和约定的排列变得相同。假设 x 最初都是 1,R1 改成 2,R2 在更新到达前仍读到 1;收到更新后,R2 改成 2。若之后没有新修改,持续同步会让相关副本都保留 2。这种保证允许传播期间存在暂时不同的读取结果。
思考题:聊天应用怎样在设备能继续读写已有状态的同时,让多台设备最终取得相同历史?最终收敛需要哪些传播和故障恢复条件?
解答:
设备先保存自己的更新并读取已有状态,后台持续传播记录,接收方按 ID 去重并按共同规则合并。更新记录需能在故障后恢复,相关副本重新通信后继续补齐。写入停止、更新最终送达、各副本从一致的基础状态按相同规则处理后,历史收敛为相同结果。
聊天例子的两个目标是:设备能继续读取已有内容、保存新消息;恢复通信后,各设备最终得到相同历史。
最终一致性要求,在更新停止、相关副本恢复通信并持续传播更新后,读取最终返回相同状态。同时,持有相同更新集合的副本,需要按共同规则产生相同结果。
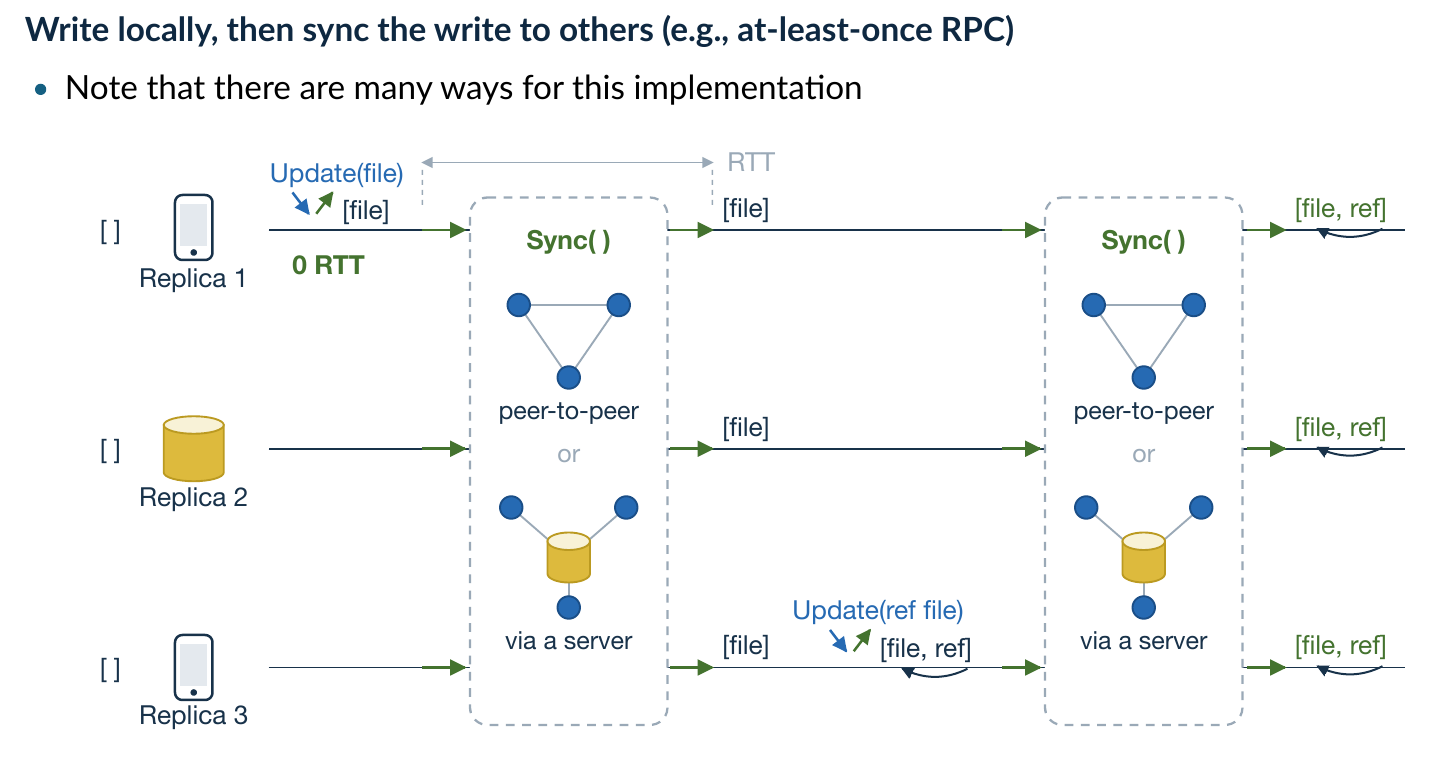
图中本地 Update(file) 标为 0 RTT,表示这一步完成前可以省去网络往返。随后同步通过服务器转发,也可以在设备之间进行。本地持久化所需的磁盘操作仍按保存要求执行。
一种实现流程是:
- 为每条更新分配稳定标识,保存内容和排序信息。
- 写入本地记录,向用户显示处理结果。
- 后台向其他副本传播,失败后继续重试。
- 接收方按标识去重,合并收到的更新。
- 按共同规则计算列表状态。
至少一次 RPC 可能把同一条更新发送多次,稳定标识用于避免重复追加。长期断开的副本要在重新连接后补齐记录,持续同步是最终收敛的前提。网络长期中断时,单个副本可以继续提供本地操作,跨设备的新内容则等待通信恢复。
统一日志顺序是聊天列表的一种收敛方法。其他数据也可以使用共同的合并规则。例如一个计数器分别收到“加 1”和“加 2”,假设每项更新恰好应用一次,两种执行次序都得到 3;列表追加 X、Y 则会产生不同排列,需要进一步规定顺序。
最终一致性关注相应条件下的收敛,具体传播速度、数据保留与离线操作由实现确定。可交换操作和可合并状态也是实现方向,相关形式化方法见 CRDT 研究报告。
日志排序
日志按条保存发生过的操作,例如 追加X、追加Y。重放表示从一个已知初始状态开始,重新依次执行这些操作。空列表先追加 X、再追加 Y,就得到 [X,Y];相同的初始列表和相同操作序列会得到相同结果。日志还需要保存 ID,重复传输的同一操作只执行一次。
两个设备分别产生 X 和 Y,本地开始时为 [X]、[Y]。同步后,若只按到达顺序追加,就会得到 [X,Y] 和 [Y,X]。
思考题:R1 先保存 X,R2 先保存 Y,交换后分别得到 X、Y 与 Y、X。怎样用确定的日志排序和重放,让相同更新集合产生相同列表?
解答:
保存完整更新记录与稳定 ID,交换缺少的记录并去重;双方对相同集合使用同一唯一排序规则,从共同初始状态或检查点重放。例如双方都约定 X 在 Y 前,重放后都得到
[X,Y]。到达顺序可以不同,计算结果由相同日志顺序确定。
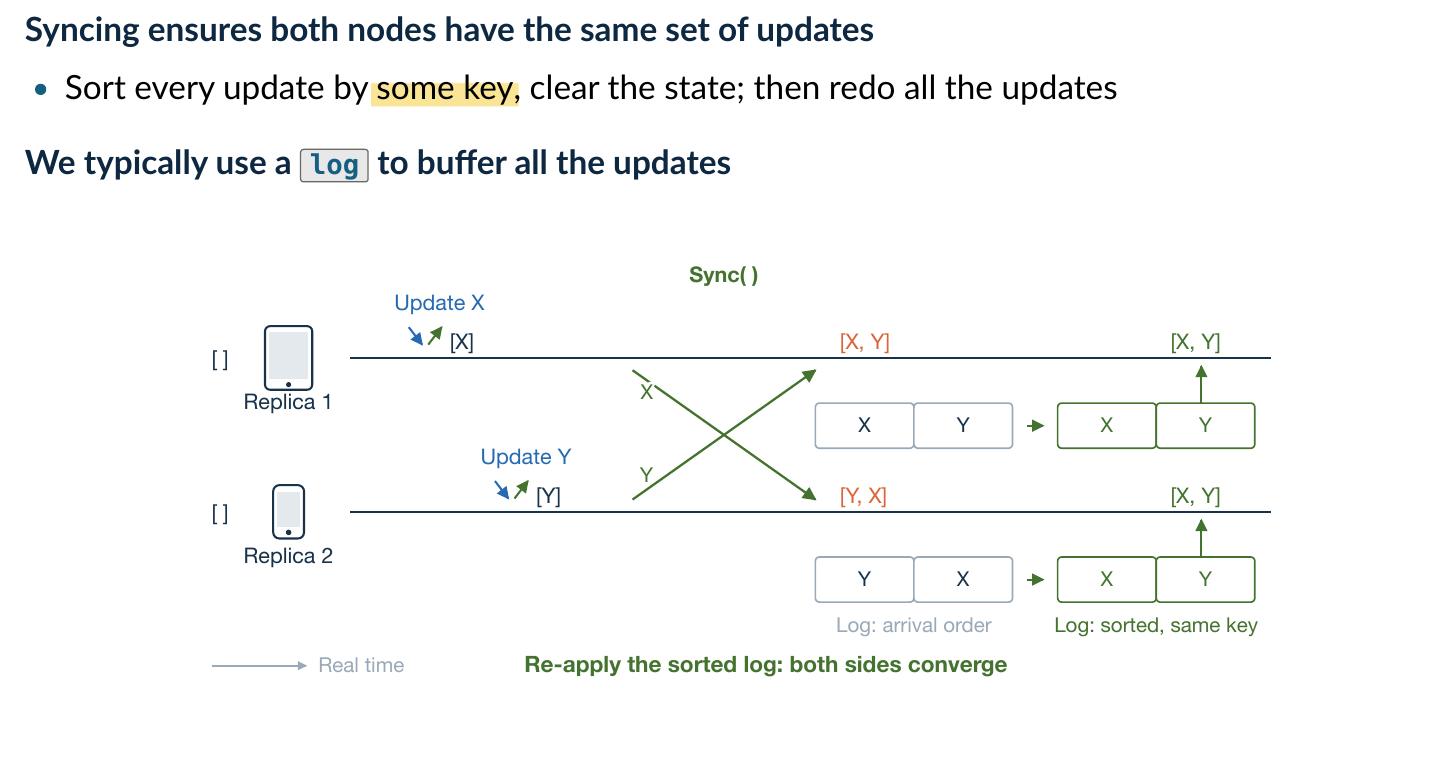
一种便于分析的实现是:保存所有更新日志,对相同更新集合使用相同的排序规则,从共同初始状态重新执行更新。两台机器把日志都排成 X、Y,重新执行后就都得到 [X,Y]。
这里需要三个条件:各副本最终取得相同更新;排序规则确定;相同初始状态和相同操作顺序产生相同结果。实际系统可以用检查点和增量计算减少重放工作,同时保留这些条件。
操作标识还用于去重。同步与重放期间,更新保留创建时的标识和时间戳,接收方单独维护自己的当前时钟。
迟到更新
假设当前日志有 〈1,X〉、〈3,Z〉,列表显示 [X,Z],后来收到 〈2,Y〉。共同规则规定键 2 在键 3 前,完整列表就要变成 [X,Y,Z];直接在末尾追加 Y 会得到另一种顺序。
因此,可以重新排序并从已知状态重放,也可以采用能正确处理插入的增量结构。建立检查点后,还要明确它覆盖哪些更新;迟到更新若属于更早位置,需要保留足够的信息处理,才能继续满足合并规则。
重放使用已经记录的内容和决策。例如消息带着创建时的 ID、正文和排序标签,所有副本按同样规则处理它们。重放期间若重新生成随机标识、当前时间或其他不同值,也可能让结果变化。
时间排序
时间戳是附在事件上的一个数值,用于记录事件的时间信息。排序键是程序拿来比较先后的字段组合。字典序按各项依次比较:〈10,R2〉 排在 〈11,R1〉 前面,因为第一项 10 更小;〈10,R1〉 与 〈10,R2〉 第一项相同,再比较节点编号。
最直接的排序键是本机时间,例如 getTimeOfDay()。但不同更新可能取得相同读数。
思考题:两个更新的
getTimeOfDay()都是 1755419200.123,仅用 T 排序能确定二者先后吗?怎样增加字段,避免两边继续保留不同的并列顺序?解答:
两个相同的 T 留下并列,仅按 T 排序时,双方可能保留各自原有的 X、Y 或 Y、X。可以按
〈T,node ID,sequence〉依次比较:时间相同后比节点编号,再用节点内序号区分同节点的更新。若 R1 编号小于 R2,两条给定记录都排为 X、Y。
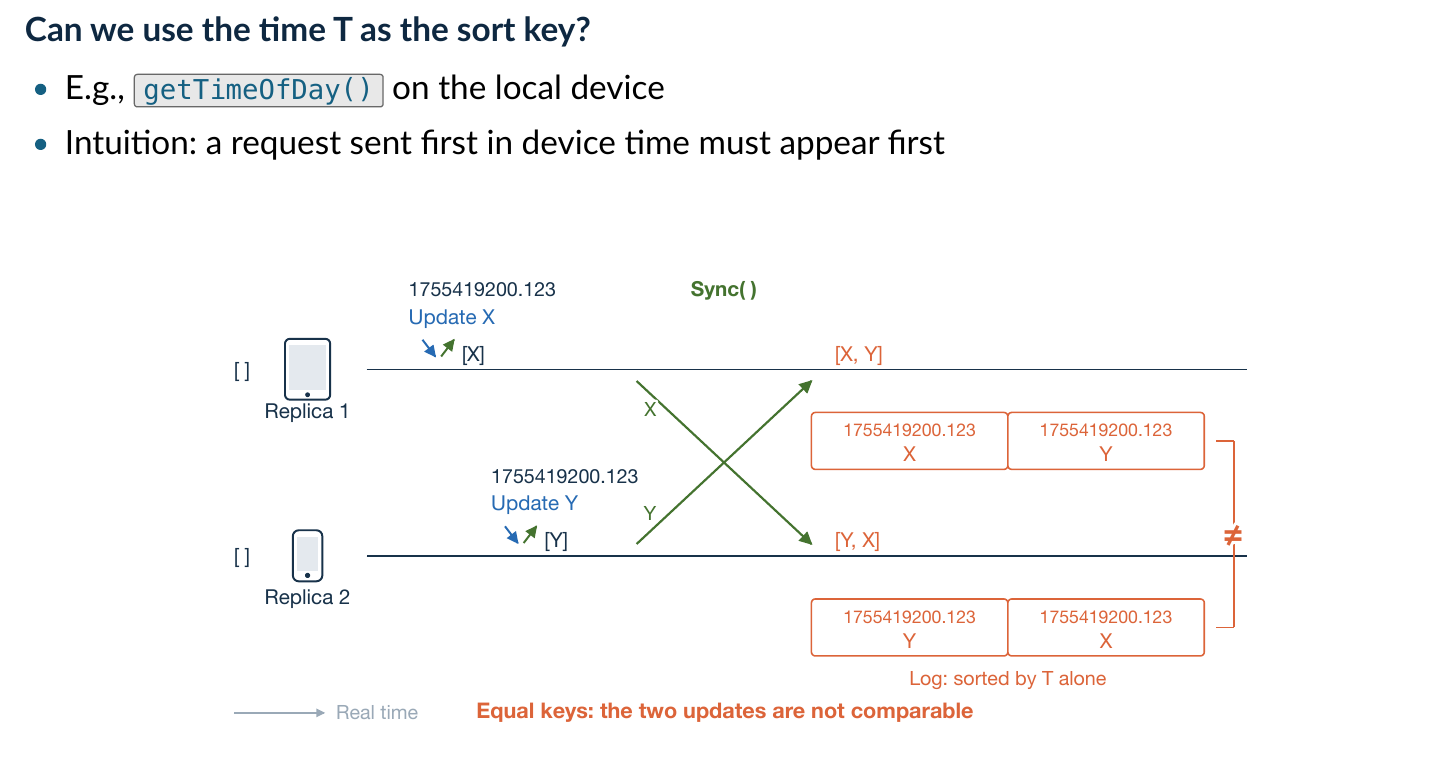
图中 X、Y 都带 1755419200.123。副本 1 原先按 X、Y 保存,副本 2 原先按 Y、X 保存。仅按这个时间值排序时,两个相等键可以继续保留不同的原始顺序。
全序要求任意两个不同更新都能确定谁排在前面。可以用复合键,并按字典序比较:
先比较时间,再比较节点编号,仍相同时比较节点内序号。节点内序号用于区分同一设备在同一时刻产生的多个更新。
本地物理时钟的分辨率有限,连续两次读取可以得到同一数值,校时也可能改变读数。递增序号帮助识别不同更新;重启后的运行代次与已有记录还需要按身份规则管理,避免把新更新与旧更新混在一起。
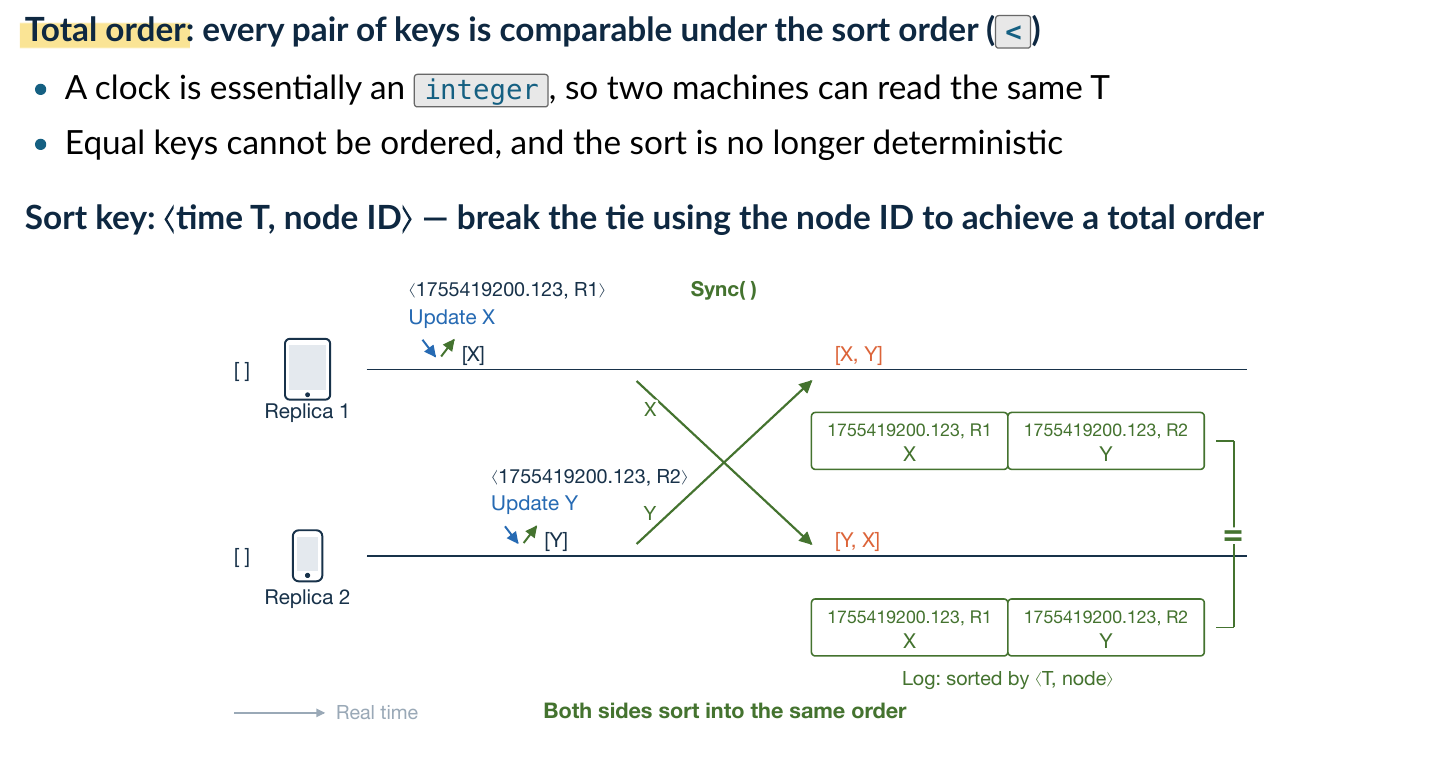
图中的两个更新分别来自 R1、R2,用 〈T,node ID〉 已能区分。假设 R1 的编号较小,X 就排在 Y 前面,两台设备都得到 X、Y。
也可以采用 〈node ID,T,sequence〉,先按节点编号排序。这同样能给出确定顺序,但会把同一节点的更新排在一起。排序规则还需要符合消息之间的依赖关系。
时钟偏差
各设备的时钟独立运行。硬件通过振荡器的周期计数估计时间,频率和温度等因素会带来偏差;校时也可能调整读数。
操作系统把选定计时源的计数按换算参数转换为时间单位,并可以通过 NTP 等协议校准。不同机器仍有残余偏差,排序时需要考虑这些误差及消息依赖。Linux 的计时源与换算机制见内核时间文档。
思考题:按
〈T,node ID〉排序后,各副本能否仍得到[ref(file_a),file_a]?给节点加唯一编号能解决哪些问题,文件与引用的依赖又需要怎样保留?解答:
仍可能出现该结果。图中 file_a 的时间为 1755419200.123,引用在另一节点上取得更小的 1755419199.987,按时间优先就把引用排在前面。节点编号解决时间并列,依赖需要逻辑时钟等关系记录;传播途中还要在目标消息未到齐时暂存引用,待依赖可见后显示。
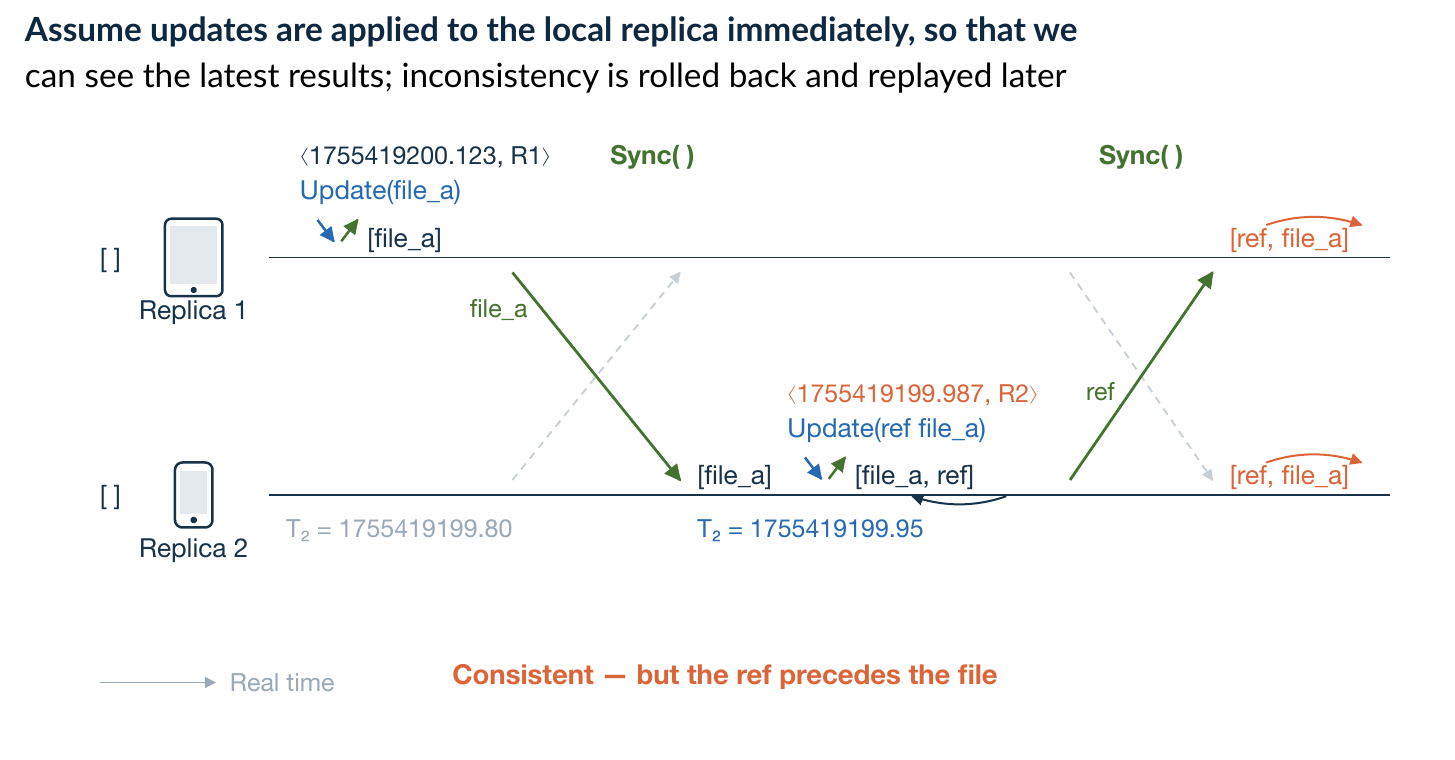
图中 R1 创建 file_a,时间为 1755419200.123。文件同步到 R2 后,R2 已经看到了它,再创建引用,自己的时间却为 1755419199.987。
按 〈T,node ID〉 排序时,引用的时间数值更小,结果成了 [ref,file_a]。两台机器可以得到完全相同的列表,但这个顺序把引用放到了目标文件前面。
文件创建、收到文件、创建引用之间存在依赖。排序键需要记录这种关系,设备的独立时钟读数只提供本机的时间信息。
因果关系
事件是系统中一次需要记录的动作,例如创建文件、接收消息、创建引用。某个动作读取了先前收到的信息,后续动作就可能依赖这份信息。沿进程执行顺序和消息箭头连出一条向前的路径,就能确定一组这样的先后关系。
思考题:一个节点收到文件后再创建引用,消息传递怎样建立文件到引用的先后关系?能否利用这些依赖来调整各节点的事件时间戳?
解答:
创建文件先于发送它,发送先于对方接收,接收又先于创建引用,所以形成文件到引用的因果路径。接收带 T′ 的消息时,用
T=max(T,T′)+1推进本地时钟,创建引用再递增。文件为 10、接收后为 11、引用为 12,就保留了这条先后关系。
用 表示 X 先发生,并且 Y 可以受到 X 的影响。这种关系称为 happens-before,由三条规则定义:
- 同一进程中,按程序顺序先执行 X、再执行 Y,则 。
- 一条消息的发送先于该消息的接收。
- 若 且 ,则 。
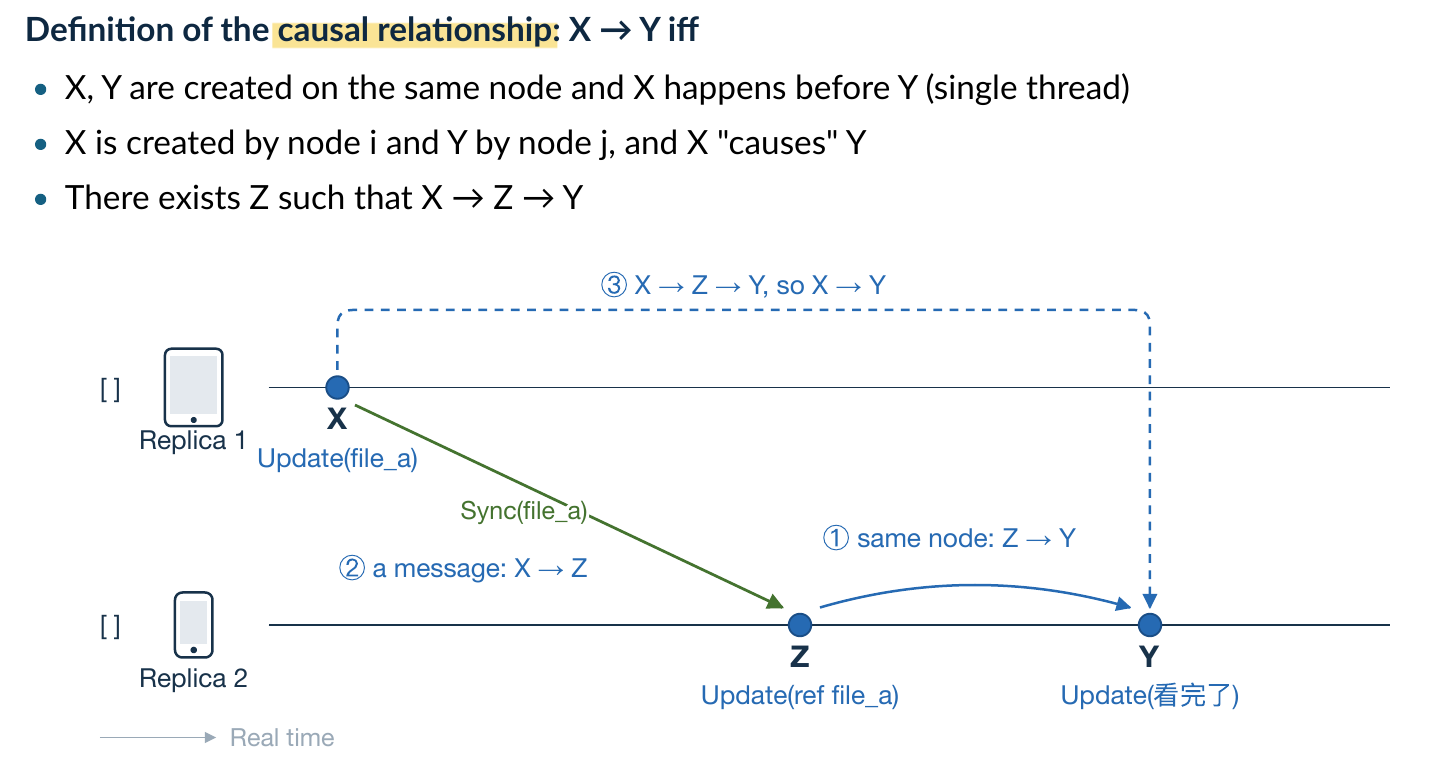
图中 X 是 R1 创建文件。文件消息到达 R2 后,R2 创建引用 Z,随后发出“看完了”Y。消息传递给出 ,R2 的本地顺序给出 ,合起来得到 。
因此,展示引用前应先有文件,展示“看完了”前应先有引用。若两个事件之间找不到这样的程序顺序或消息依赖,它们在这个关系中称为并发事件。并发描述的是缺少因果先后关系,两事件在物理时间上也可能隔着一段时间。
逻辑时钟
逻辑时钟保存一个整数计数器。每产生一个需要记录的事件,计数就向前推进。max(a,b) 表示取 a、b 中较大的数。接收消息时先比较两边计数,再加一,能让当前事件的编号同时大于本地已有编号和消息携带的编号。公式里的 ⇒ 读作“推出”,表示箭头左边条件成立时,右边条件也成立。
Lamport 时钟为事件分配递增的整数时间戳。它的目标是:
每个进程保存计数器 T。创建一个事件并将它发出可以合为一次逻辑事件;后续重传继续携带原事件的时间戳。按事件递增的常见写法如下:
| 事件 | 时钟更新 |
|---|---|
| 本地事件 | T = T + 1,把新 T 作为事件时间戳 |
| 创建并发送事件 | 推进 T,把新时间戳附在事件消息中 |
| 接收带 的消息 | T = max(T,T') + 1 |
同一进程的每次事件获得更大的时间戳。收到消息后,当前时钟也大于发送方的时间戳,所以后续事件保留消息带来的先后关系。
取最大值保留了两边已经知道的进度。例如当前 T 为 20,收到时间戳 10,接收事件取得 21;收到时间戳 30,则取得 31。这样本地后续事件继续前进,同时也排在收到消息的发送事件之后。
计数器需要满足两项要求:一个进程的后续事件取得更大的计数;接收消息的事件取得比发送事件更大的计数。上表的取最大值、再加一同时满足这两项要求。
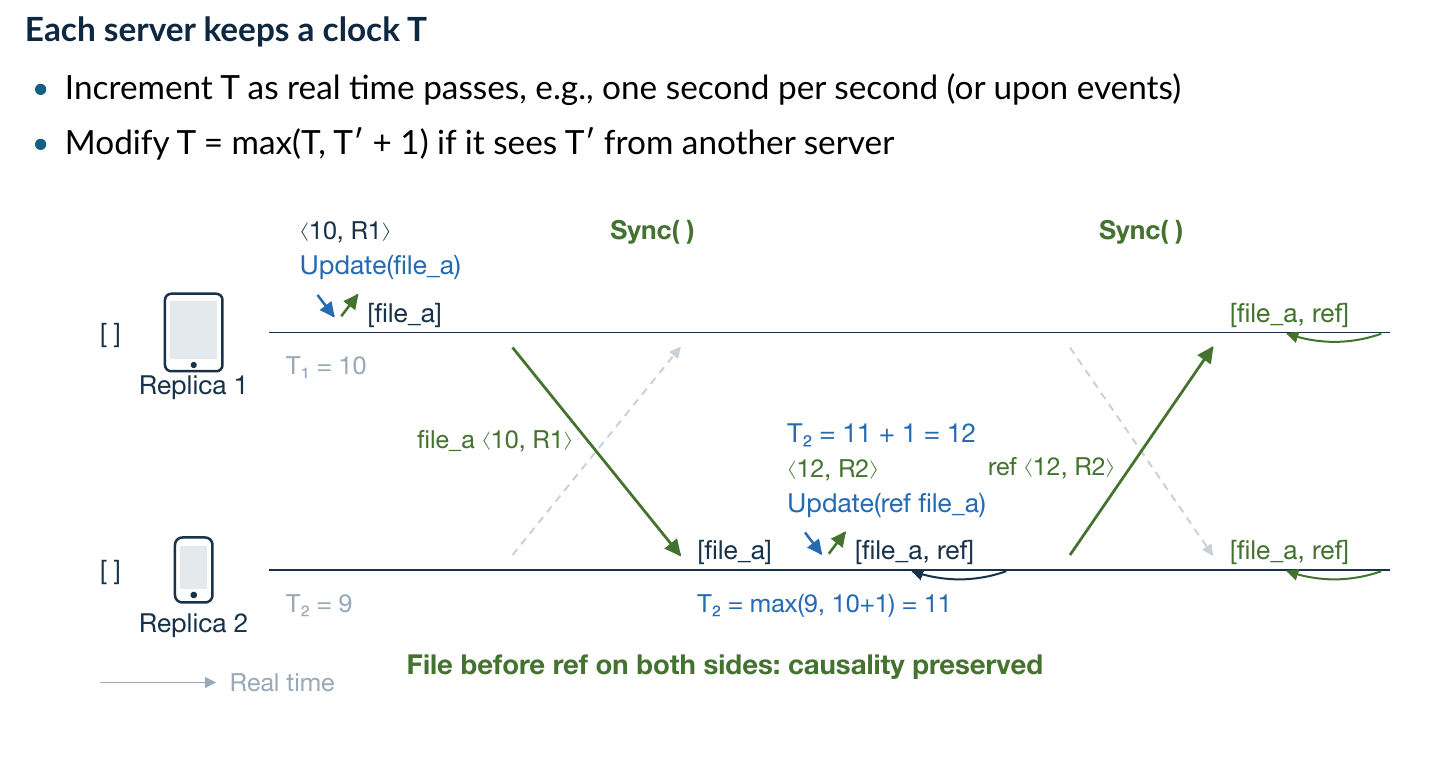
沿图中的消息传递过程计算:
- R1 创建文件,时间戳为
〈10,R1〉。 - R2 的当前计数为 9,收到文件后推进为
max(9,10)+1=11。 - R2 创建引用,再推进为 12,引用时间戳为
〈12,R2〉。 - 两台设备按时间戳排序,文件 10 排在引用 12 前面。
逻辑计数器按事件推进,也可以在本地计时推进的基础上做消息调整;需要保持上述时钟条件。节点编号和节点内序号可以补齐排序键,区分并发事件产生的相同计数。
排序记录用于重建列表。要在传播途中也满足因果可见性,接收方还需要检查依赖:引用先到、文件未到时,先暂存引用,等文件内容到齐后再展示。
文件更新原来的标签为 〈10,R1〉,收到它的事件令 R2 当前时钟变为 11;保存文件更新时仍沿用原标签。R2 创建引用取得 12,这条新更新才使用 〈12,R2〉。同一更新在各副本中的身份与标签因此保持一致。
思考题:引用消息带有时间戳 12,依赖的文件带有时间戳 10,但引用先到达。仅知道 10 比 12 小,能否立即显示完整引用?还缺什么?
解答:
时间戳帮助规定顺序,文件内容仍需要实际到达。接收方可以按目标消息 ID 检查依赖,缺少文件时暂存引用或显示待获取状态,再请求或等待文件。
若要持续交付一个确定的全序,还需要判断是否有更早更新尚在路上。日志排序与完整更新集合可以用于最终重建,传播中的交付时机则由额外同步、确认与依赖规则决定。
时钟判断
逻辑时间 3、7 是按事件推进的编号。一个节点已经处理较多事件,可能较早取得编号 7;另一个节点后来才处理到编号 3。判断实际发生时间还需要发送和接收记录,例如明确知道一个节点先收到某条消息,再创建下一事件,就建立了实际的先后路径。
判断题:节点 1 的事件时间戳为 3,节点 2 的事件时间戳为 7。图中的 TS 表示事件时间戳,记为 。判断下面三项,并说明理由。
- 仅凭 ,可以确定事件 1 在实际时间上更早。
- 仅凭这两个时间戳,可以确定两个节点一定交换过消息。
- 节点 2 在事件 2 之前,已经收到事件 1 的同步消息,因此事件 1 在实际时间上更早。
解答:
- 错。逻辑计数大小不足以证明实际发生时间;节点 2 可以先发生编号 7 的事件,节点 1 后来才发生编号 3 的事件。
- 错。两个节点也可以独立执行各自事件,分别取得 3 和 7,时间戳本身没有提供通信记录。
- 对。题目补充了事件 1 的消息在事件 2 前已到达,发送、接收、后续事件形成因果路径,所以事件 1 实际更早。
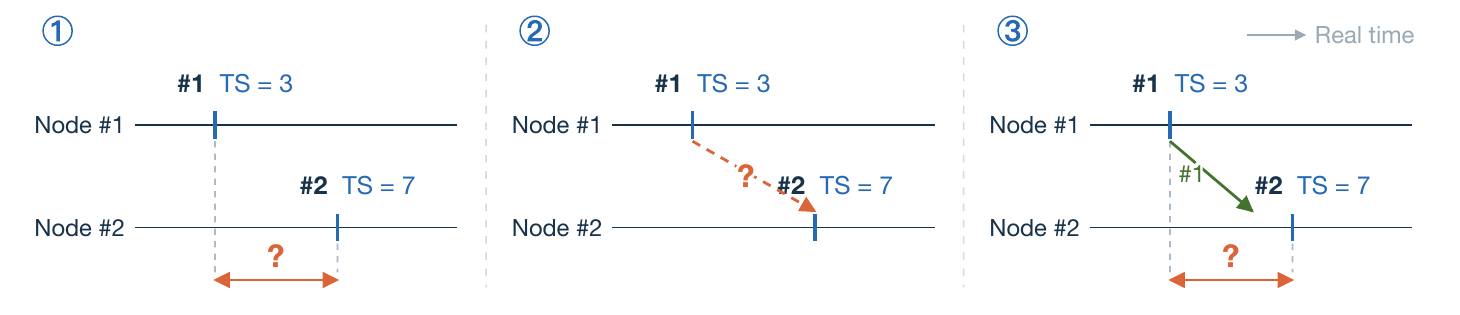
时,可能有 ,也可能是两个并发事件恰好获得了大小不同的计数。要判断哪种情况,需要知道消息依赖,或使用记录更多信息的时钟。
练习:两个互不通信的节点分别产生事件 e1、e2,逻辑时间为 3、7。e1 在实际时间上更早、更晚或与 e2 同时发生,三种情况能否出现?
解答:
三种都可以出现。两个节点各自推进计数,较小的计数既可以较早产生,也可以较晚产生,还可以恰好在同一个参考时刻产生。数值 3、7 只说明这两个事件的逻辑标签。
如果另外知道
e2 → e1,时钟条件就要求L(e2)<L(e1),与题中数值不符;如果知道e1 → e2,则符合 3 小于 7。通信记录提供的关系与标签大小要分别检查。
接龙名次
名次是列表中的位置。每个副本都有 17 项时,本地追加自然取得第 18 位;其他设备也可以基于自己的 17 项做同样计算。应用可以先保存报名请求,待系统确定序号后再公布名次,也可以把并发情况交给用户处理。
聊天列表最终重新排列,用户通常还能继续阅读。接龙若规定“第一个报名的人获得奖金”,名次变化就会影响实际结果。
思考题:两份接龙到第 17 位相同,两个人都在本地追加自己,会不会同时显示为第 18 位?若按名次发奖,应选择临时排序、报告冲突还是等待确认?
解答:
会,各自的本地追加都先占第 18 位,合并后才能确定 18、19 的共同顺序。临时名次应标为待确认;按名次发奖时,需等待确认或明确处理并发冲突。
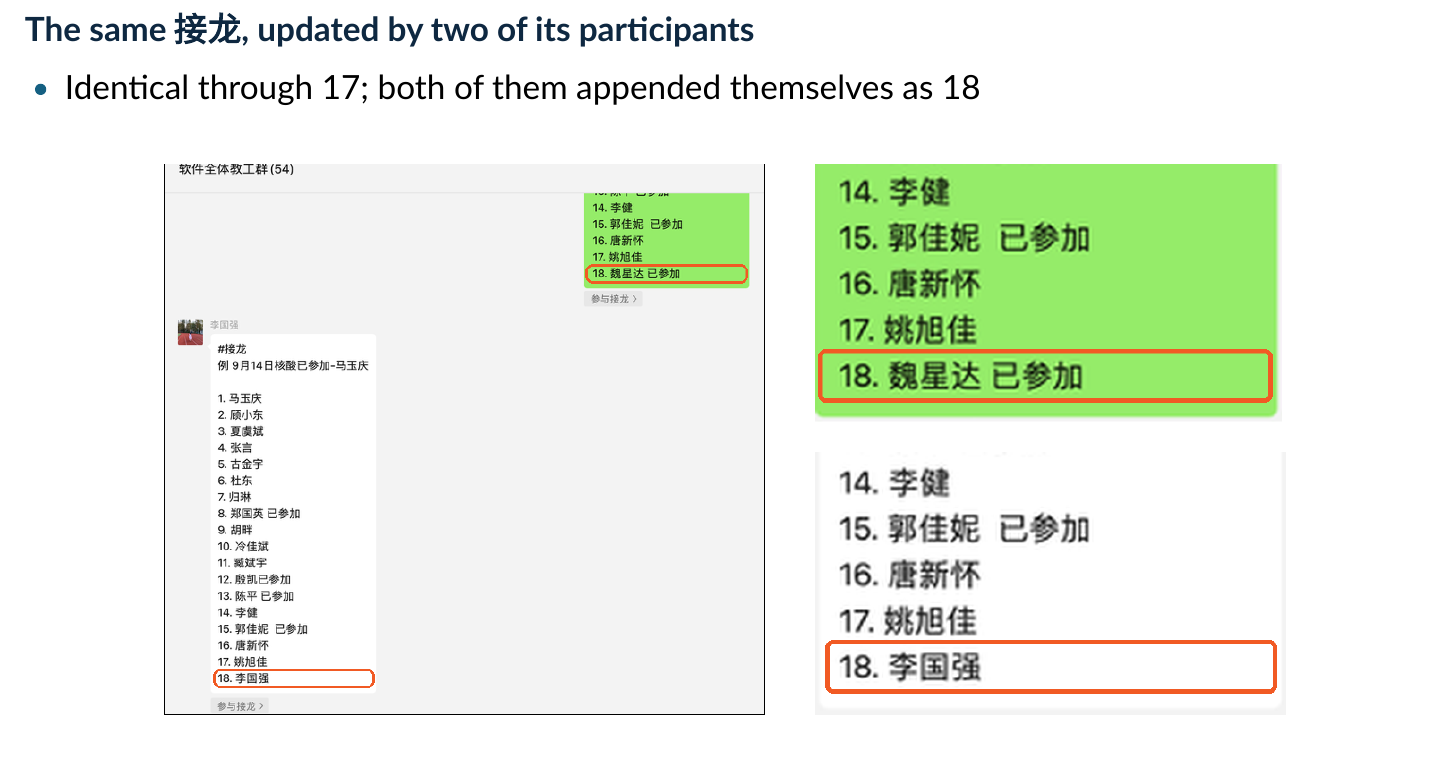
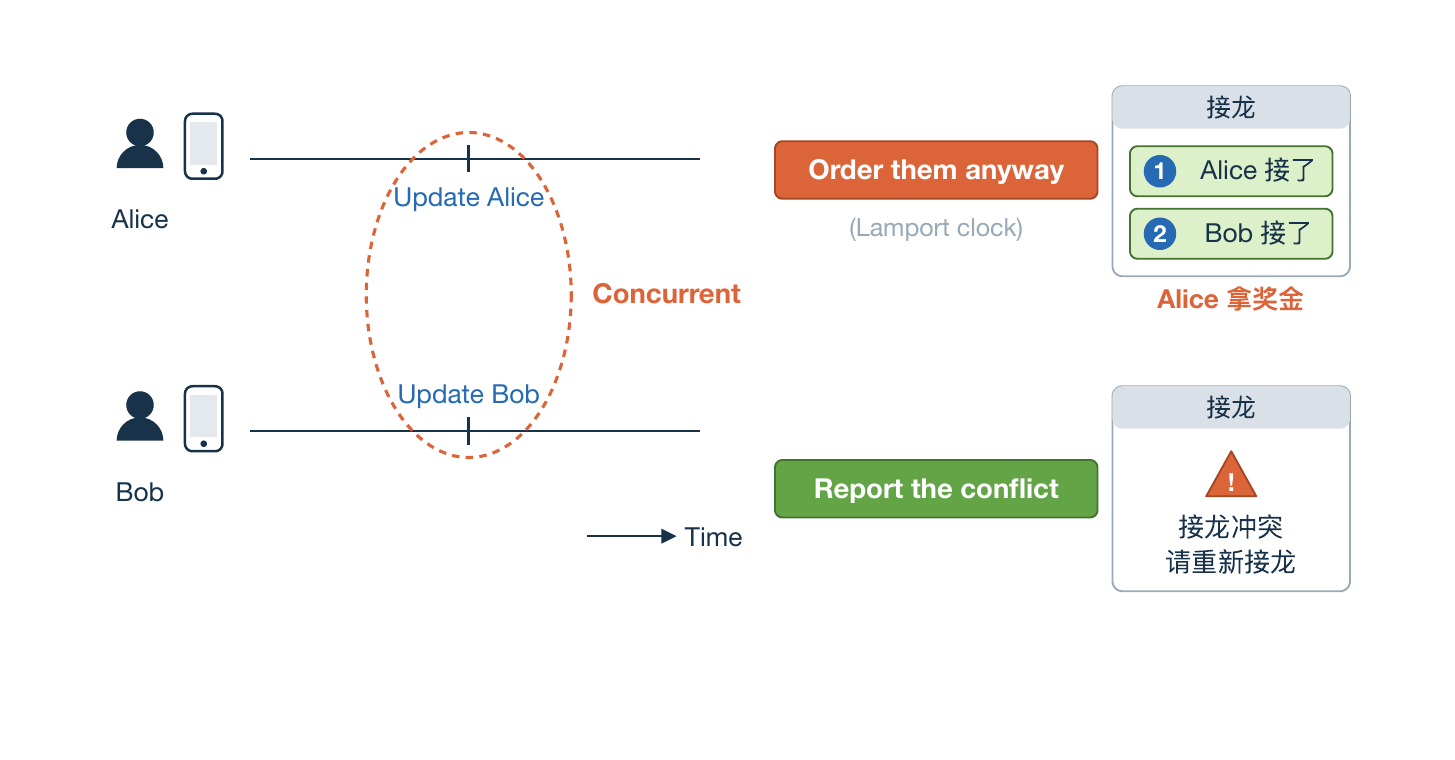
给并发事件加上 〈Lamport 时间,node ID〉 能决定展示顺序。奖金规则若按这个顺序执行,结果可能由节点编号等排序规则决定。若需要识别“这两次报名缺少因果先后”,时间戳就需要保留不可比较的情况。
全序和偏序
例如三个更新 A、B、C,确定 A在B前,B在C前 后,就得到 A、B、C 的全序。若只知道 A 在 C 前、B 在 C 前,A 和 B 的关系仍可保留为不可比较。这组关系构成偏序;应用可以共同确认两者都应在 C 前,再单独处理 A、B 之间的顺序。
思考题:两个报名缺少因果先后关系时,强行规定一个全序与保留不可比较的关系,分别向应用提供什么信息?
解答:
全序给所有不同事件一个确定位置,能直接决定列表排列,但独立报名的顺序可能由节点编号等规则决定。偏序保留已经知道的因果先后,并将缺少关系的事件标为不可比较。应用于是知道这里存在并发,可按业务规则合并、重试或仲裁。
全序可以对任意两个不同元素确定先后。〈逻辑时间,node ID,sequence〉 就能让所有更新排成一条确定序列。
因果关系是偏序。对两个事件,允许三种结果:
- :X 先于 Y。
- :Y 先于 X。
- :二者并发,缺少因果先后关系。
应用可以利用第三种结果报告冲突。先完整记录偏序,再由业务决定怎样处理并发更新,能保留更多信息。
向量时钟
向量在这里是一排整数,长度等于参与计数的节点数量。每个事件保留创建时的向量,表示当时已经知道的各节点事件进度。例如 [3,1] 记录已知 R1 到第 3 个事件、R2 到第 1 个事件。比较两个向量时,需要逐项检查它们记录的进度。同一更新在不同副本上的拷贝沿用相同 ID 和创建向量,下面的先后比较针对不同事件。
向量时钟为每个节点保留一个分量。两个节点时,第一项记录已知的 R1 事件计数,第二项记录已知的 R2 事件计数。R1、R2 都从 [0,0] 开始;R1 的事件推进第一项,R2 的事件推进第二项。收到其他节点的消息后,也会更新相应分量。
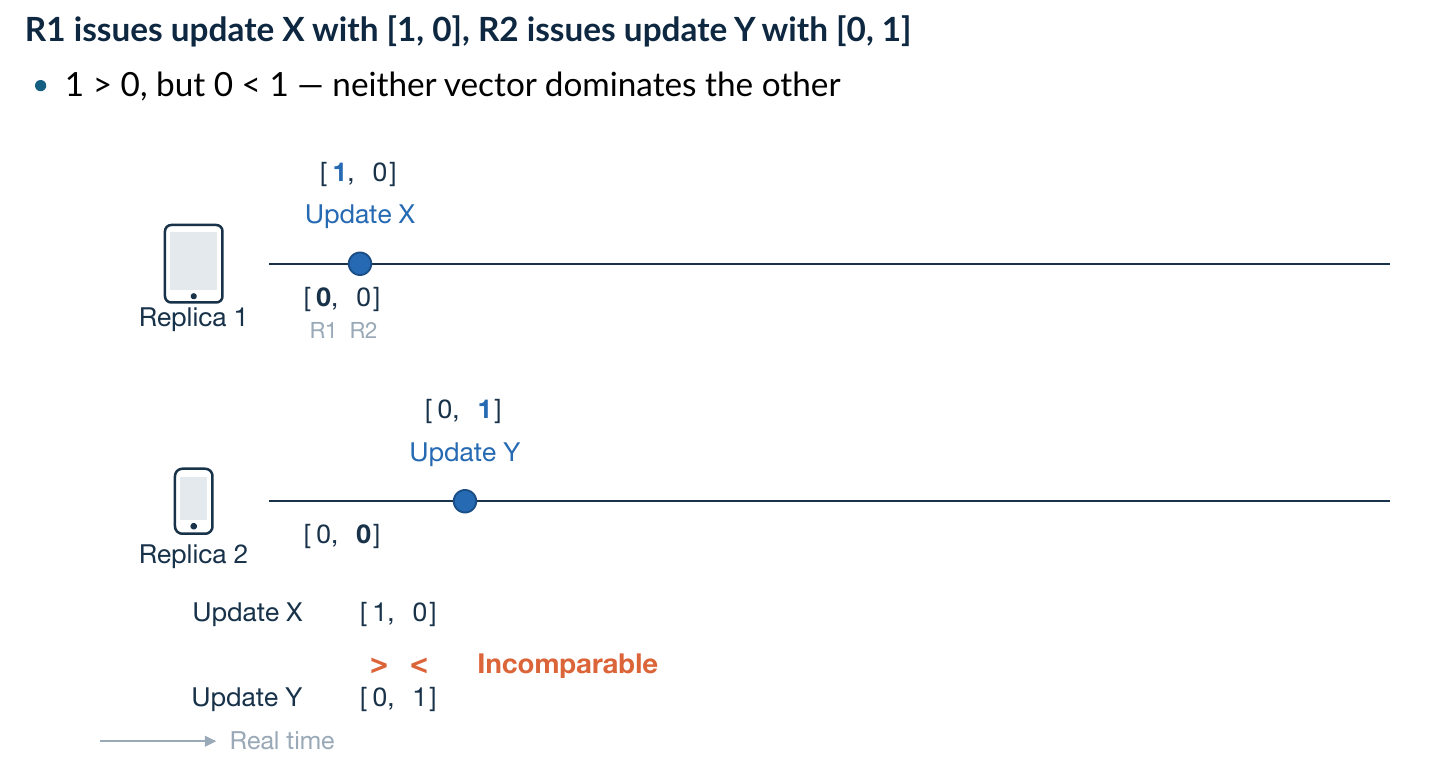
R1 创建 X,得到 [1,0];R2 独立创建 Y,得到 [0,1]。第一项中 X 较大,第二项中 Y 较大,所以两向量不可比较。它们分别记录了自己看到的事件,没有记录对方的新事件。
公式中的 表示事件 X 的向量在第 k 项的数值; 表示每一项都满足条件; 表示至少存在一项; 表示两个条件同时成立。向量先后关系写为:
也就是 X 的每个分量都小于等于 Y,且至少一项更小。若两个方向都无法满足这个条件,两个事件并发。
| 向量 | 判断 |
|---|---|
[1,0] 与 [0,1] |
两者各有一项较大,并发 |
[0,1] 与 [3,1] |
前者每项小于等于后者,且第一项更小,前者先于后者 |
[2,1] 与 [3,1] |
前者先于后者 |
向量更新
下面按“创建更新”“接收更新”计数。创建更新时,推进自己的分量,将新向量保存在更新记录里;同步发送这条记录时,沿用它的向量。接收方逐项合并这条记录带来的进度,再为自己的接收事件推进一项。记录创建时的向量与当前节点继续推进的向量分别保存。
接收方在自己的第 i 个分量上计数,逐项合并和推进可以写为:
逐项最大值把收到消息所包含的历史合进来;增加自己的分量记录本次接收事件。
例题:R1、R2 从
[0,0]开始,R1 创建 X 得到[1,0],R2 创建 Y 得到[0,1]。R1 随后收到 Y,再创建ref(Y)。
- X 与 Y 是否有因果先后?
- R1 收到 Y 后,逐项最大值和计入接收事件后的向量各是多少?
ref(Y)的向量是多少,怎样判断 ?解答:
- X 的
[1,0]和 Y 的[0,1]各有一项较大,互不覆盖,因此 X、Y 并发。- R1 合并时逐项取最大值,得到
[1,1];再把自己的第一项加一,计入接收事件,得到[2,1]。- 创建 ref(Y) 再推进第一项,得到
[3,1]。Y 的[0,1]每项都小于等于[3,1],且第一项严格更小,因此 。
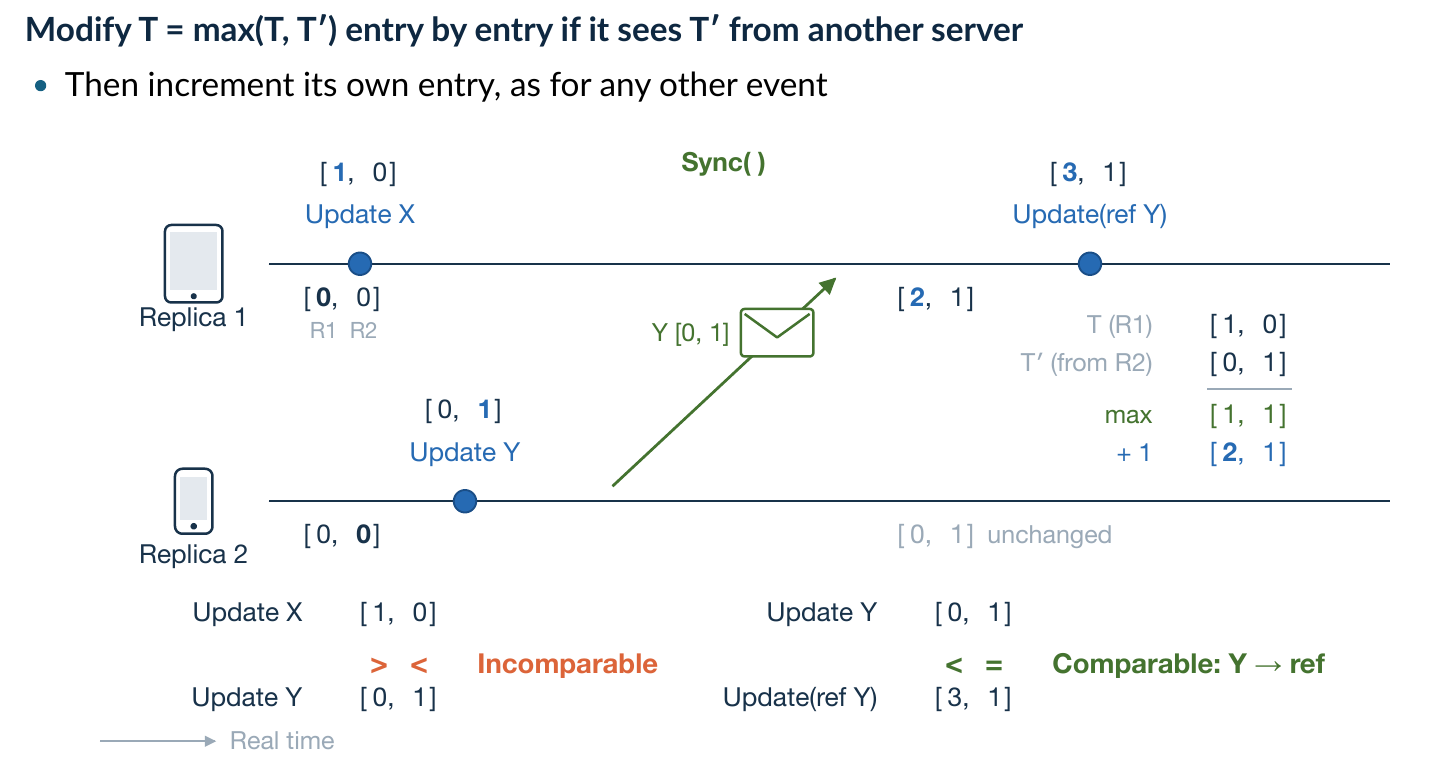
向量长度随节点数增加,系统需要保存和传递更多信息。它适合识别更新之间的依赖和冲突,冲突发生后仍由应用选择合并、重试或其他处理规则。
这里的“并发”表示两次事件缺少已记录的因果先后。两次报名可以在实际时间上相隔一秒,但两边互相没有收到消息,向量仍可能不可比较。向量时钟能够识别这种关系,奖项如何分配则由报名规则决定。
版本冲突
Dynamo 为同一个键的数据版本保存向量时钟。读取发现两个版本互不覆盖时,会把这些分支及版本信息交给应用处理;应用提交合并结果时,带上已经读取的版本上下文。Dynamo 原论文,第 4.4 节
例如购物车最初为空,两个节点都读到这个版本。R1 加入苹果,版本为 [1,0];R2 独立加入牛奶,版本为 [0,1]。两向量不可比较,表明两个版本各包含对方尚未看到的修改。应用可以保留两项商品,再提交一个同时包含两个分支历史的新版本。删除商品等操作还要规定具体的合并规则。
练习:购物车的两个并发版本分别为“苹果”和“牛奶”,向量是
[1,0]、[0,1]。只保留第一个版本会丢失什么?向量时钟能直接决定合并后的商品吗?解答:
只保留第一个版本会丢失加入牛奶的更新。两个向量互不覆盖,系统可以识别存在分支并保留两份结果。合并后的商品由应用规则决定;在本例中可以同时保留苹果和牛奶,再提交包含两个分支历史的新版本。
向量中的节点通常是参与记录版本的节点。按本节的完整向量模型,每项使用 8 字节时,1000 个节点就需要约 8000 字节,还没计算节点标识与协议开销。实际系统可以采用稀疏记录等方式,但删去历史分量会影响依赖判断的准确性。选择时钟时,需要一起考虑冲突识别需求和保存历史的成本。
串行观察
逻辑对象指对外提供的一份数据及其操作规则。例如三个节点各保存一个聊天列表,但所有读取都能解释为对同一份列表进行操作,应用就可以按这份列表的规则判断结果。判断时要把已经返回的操作和结果列出来,寻找一个共同顺序来解释它们。
接龙还有另一种处理办法:先由系统确认操作顺序,用户读取确认后的名次。
思考题:多个物理副本对外表现为一个逻辑对象,需要让哪些操作和结果对应到共同的串行执行?仅有共同顺序时,还要说明哪些时间约束?
解答:
需要找到一个共同的合法串行顺序,解释所有调用与返回结果。例如列表追加把项放到末尾,读取返回该位置之前加入的内容。还要声明保留哪些时间关系:顺序一致性保留每个进程的程序顺序,线性一致性还保留完成到后续发起的实时关系,严格顺序则要求全局实际发起顺序。
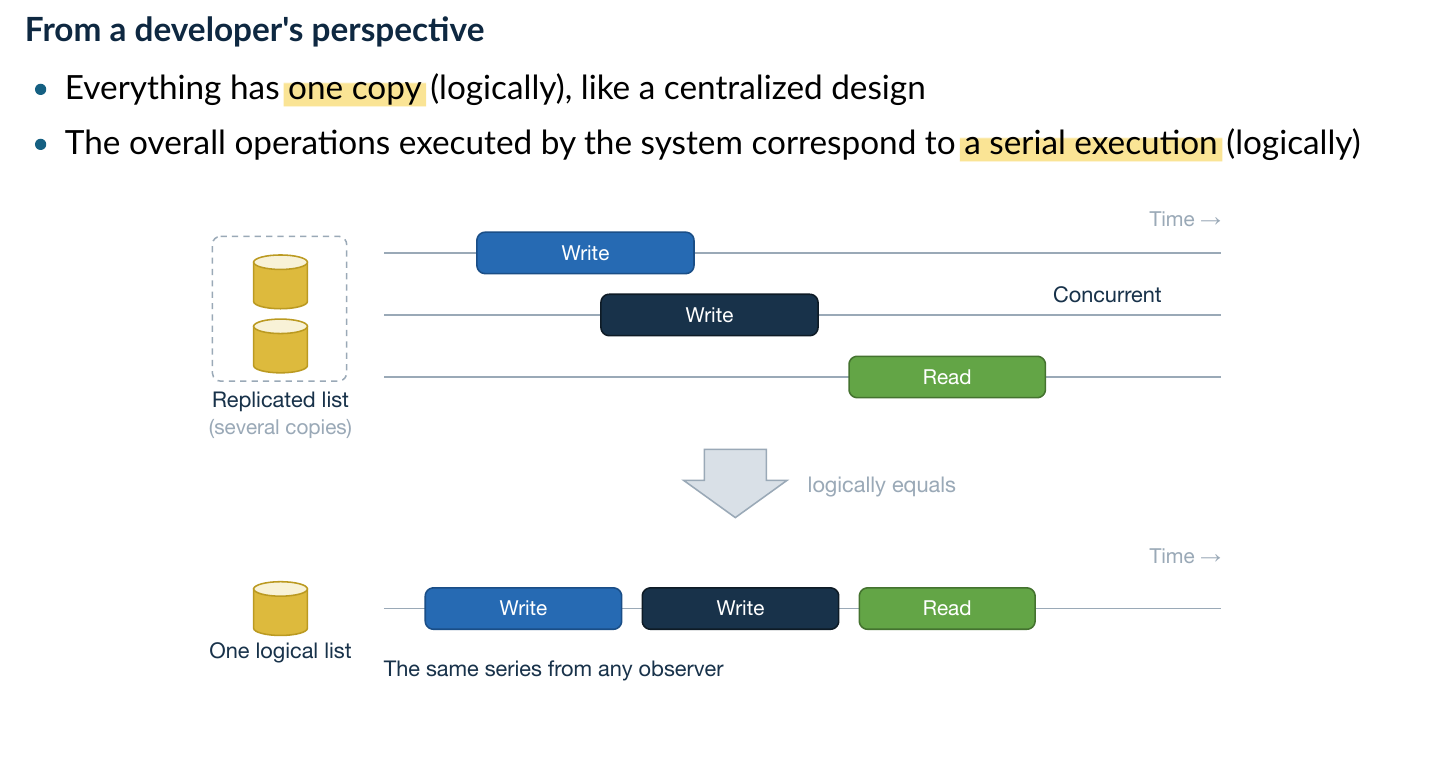
底层仍可以有多个物理副本。对外提供的结果可以解释为对一个逻辑对象依次执行操作:先写一次,再写一次,最后读取。
每种数据结构都有自己的操作规则。列表追加应把新项放在末尾,寄存器读取应返回对应顺序中最近一次写入的值。判断一致性时,需要找出一个符合这些规则的共同顺序,再检查这个顺序满足哪些时间约束。
严格顺序
一次调用有几个不同的时刻:客户端发起请求,服务器收到请求,服务器执行,客户端收到回复。发起时间位于客户端,请求到达时间位于服务器。网络传输耗时不同,会让这些时刻之间隔着不同长度的等待。
严格一致性要求按全局实际发起时间安排操作。接龙中,发起时间可以理解为用户按下按钮的时刻。若 Alice 更早按下,理想顺序就把 Alice 放在 Bob 前面。
即使使用单台服务器,请求到达顺序也可能变化:Alice 先发 A,网络延迟较大;Bob 后发 B,B 却先到服务器。
思考题:Alice 发起 A 的实际时间更早,Bob 的 B 却先到服务器。怎样知道应先处理 A?即使携带精确时间戳,B 的时间为 7、A 为 5,服务器应等待多久、等待多少条更早请求?
解答:
客户端各自的时间存在偏差时,时间戳不足以可靠恢复全局发起顺序。即使时钟精确,B=7 先到后仍可能有 A=5 在路上。在消息延迟无已知上界、消息可能丢失的模型中,服务器无法确定等待上限或更早请求数量;额外的同步与延迟条件需要另行规定。
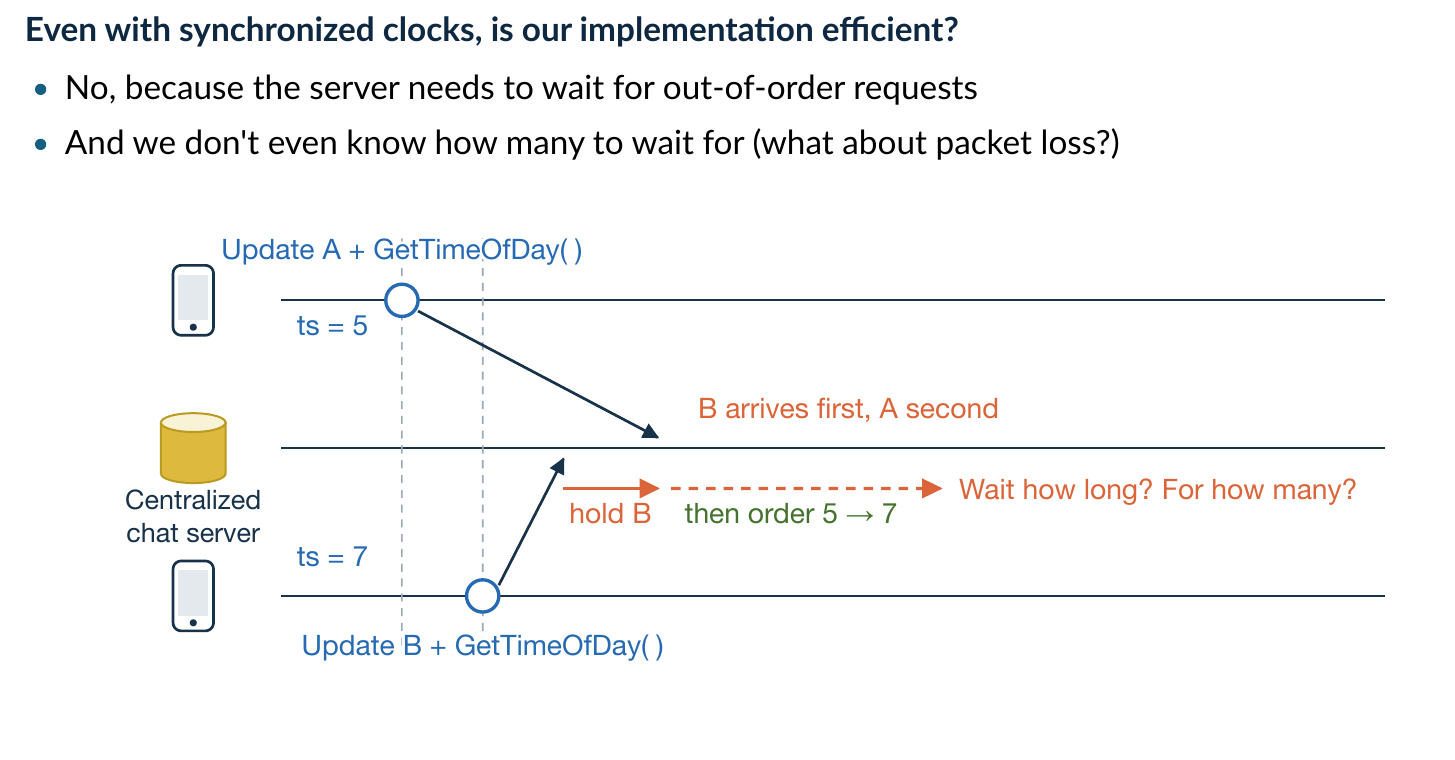
给请求附上本机时间会遇到时钟偏差。假设时钟已精确同步,服务器收到时间戳 7 的 B 后,还要确认是否有更早的请求正在路上。图中 A 的时间戳为 5,服务器等待它才能按 5、7 执行。
在消息延迟没有已知上界、消息还可能丢失的环境中,服务器难以确定要等待多久,以及是否还有更早请求。实际系统通常通过请求完成和后续发起的关系来规定顺序。
线性一致性
操作的调用区间从发起开始,到返回结束。例如 Write(x,2) 在 10:00:00 发起,10:00:01 返回,这一秒是它的区间。Read(x) 在 10:00:02 发起时,写入已经返回;若其间没有其他写入,读取需要得到 2。两次调用的区间重叠时,系统则依据对象规则确定它们的生效顺序。
线性一致性,英文为 linearizability,要求所有操作可解释为一个合法串行顺序,并保留实时的先后关系:
invoke 是发起调用,return 是返回结果。如果 A 已返回,随后才发起 B,B 的结果就需要符合 A 已生效后的对象状态。
另一种等价理解是:每次操作在发起和返回之间存在一个生效时刻,称为线性化点。把操作按这些点排列,可以解释所有读取结果。
思考题:集中服务器实际按什么顺序处理重叠请求?B 已完成后才发起的读取必须包含什么?为什么完成到后续发起的关系可以作为线性一致性的判断条件?
解答:
图中 B 先到服务器,示例处理顺序为 B、A,列表变为
[B,A]。B 已完成后才发起的读必须保留 B 的加入;图中 A 也已完成,所以返回[B,A]。完成说明操作已经生效,后来发起的调用区间在它之后,合法线性化顺序就必须保留这项实时关系。
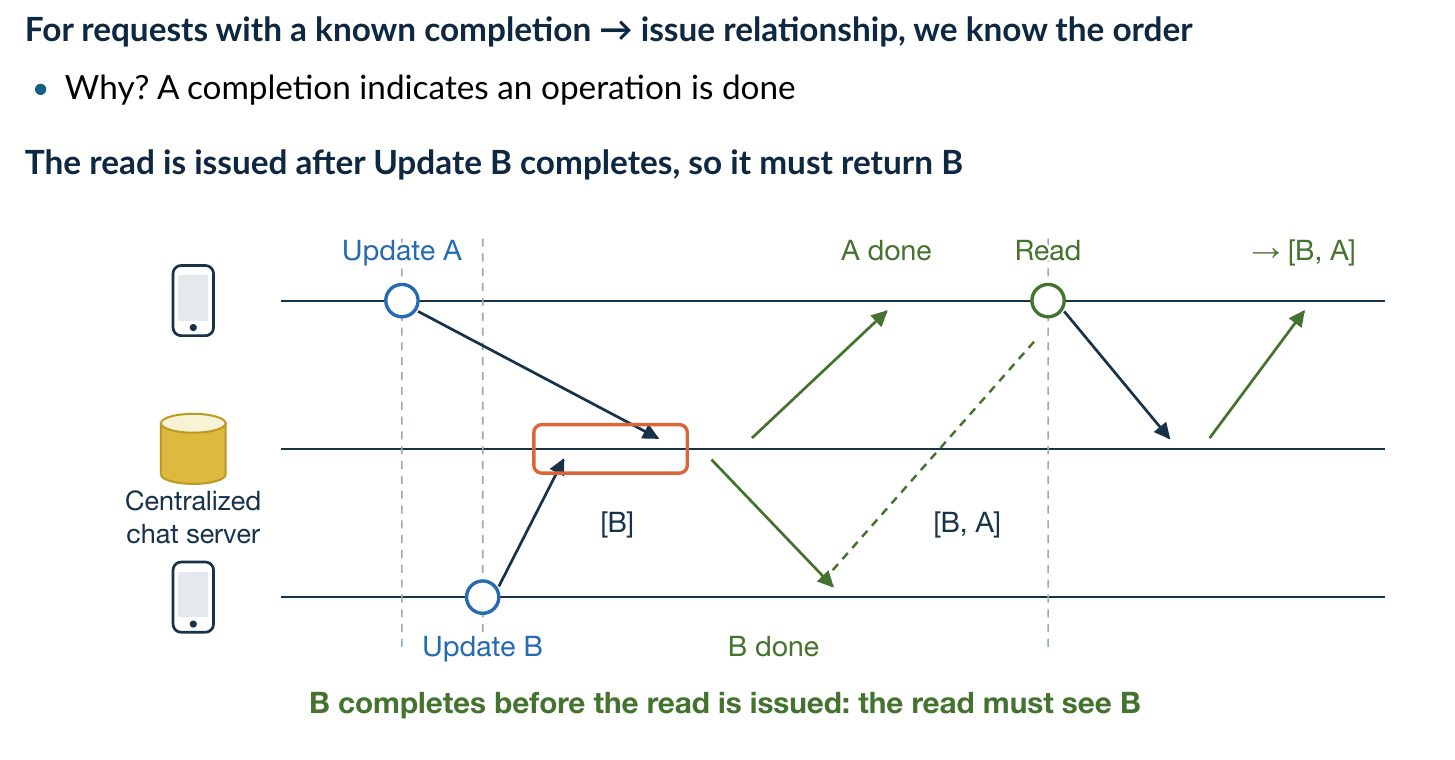
图中 A、B 的调用区间重叠,服务器先收到 B,依次处理 B、A,得到 [B,A]。读取在 B 完成后发起,需要看到 B;图中读取也发生在 A 完成后,因此返回 [B,A]。
两次调用重叠时,线性一致性允许按对象规则选择其中一个先执行。两次调用分开时,已经完成的操作排在后来发起的操作之前。报名应用可以按系统确认的序号发奖,并在确认前显示“处理中”。线性一致性原论文
判断“完成”时,图上的客户端返回事件很重要。服务器可能已经修改数据,回复仍在网络中传输,客户端此时还无法凭返回结果确认执行进度。线性化点可以早于返回;客户端收到成功回复后,才取得这次调用已经完成的直接证据。
实时约束也适用于不同设备。A 收到写入成功的回复后,B 才发起读取,线性一致性就要求这次读取位于该写入之后。协议需要提供这个保证,应用可以通过消息通知来确认两次调用确实具有这样的先后。
练习:初始 x=1。A 写入 x=2,服务器执行后,回复在网络中停留了一秒。B 在这一秒内发起读取。另一次读取则在 A 收到成功回复后才发起,两次读取分别允许返回什么?
解答:
第一次读取与写入的调用区间重叠。若没有其他写入,合法线性化可以把它排在写入之前或之后,分别返回 1 或 2;具体实现可以给出更强的保证。
第二次读取在写入完成后发起,必须排在写入之后并返回 2。这一条件跨客户端成立。判断时使用调用和返回的历史,服务器内部执行时刻可以帮助理解实现。
主副本
primary 保存本对象的排序职责,backup 保存相应副本。调用方可以向不同入口发请求,入口将请求送到 primary,由它分配位置并等待复制完成。已确认的写入记录用于恢复;更换 primary 时,新节点需要取得这些记录,并确保之后的更新继续按共同顺序安排。
一种实现线性一致性的方法,是对每个对象指定一个 primary,统一安排读写顺序,其他副本按这个顺序执行。
思考题:各副本先本地写入并立即返回,再于同步时重新排列,能否让所有已完成操作保留线性一致性的顺序?primary-backup 方法怎样安排读写与确认?
解答:
这种做法一般无法保证线性一致性:一个节点已确认的写入,另一节点还可能读旧值,事后重排也改变不了已返回的结果。primary-backup 对每个对象统一安排操作,给写入排序,备份按序应用并确认,满足条件后才返回完成;读取按相应顺序取得已确认状态。
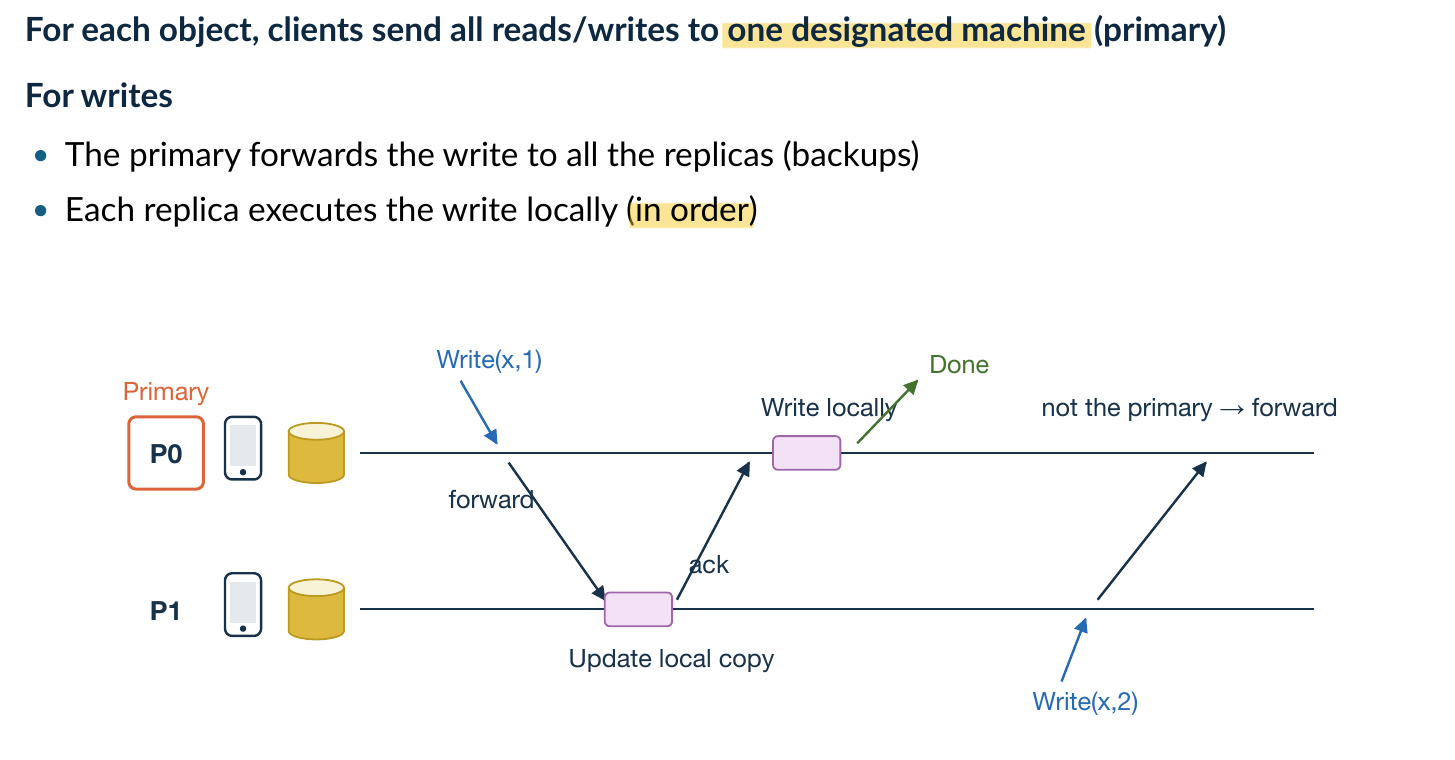
图中 P0 是 primary,P1 是 backup。初始 x 为旧值,写入 x=1 时:
- 请求到达 P0,由 P0 安排位置。
- P0 把更新转发给 P1。
- P1 写入本地副本并返回 ACK。
- P0 按协议完成自己的写入,确认这次操作完成。
- P0 向调用方返回 Done。
发到 P1 的 Write(x,2) 也被转交 P0。读取同样经过统一安排。在这个逐次处理请求的实现中,后续读取在相应写入确认后返回,从而看到正确的已完成状态。
统一排序可以按对象分工,不同对象由不同 primary 负责。任期标识一段主节点授权,选出新主后需要更新相应任期。故障恢复要取得已确认的操作记录,再安排后续读写;旧任期的节点恢复连接后也按授权规则处理请求。
“一个负责排序的节点”是本例中每个对象的职责安排。三个聊天列表 A、B、C 可以都保存三份副本,分别由 P0、P1、P2 负责排序。访问 A 的请求交给 P0,访问 B 的请求交给 P1,这样不同列表的请求能够分散处理。线性一致性具有可组合性:每个独立对象都满足线性一致性,组合后的单对象操作历史也满足线性一致性。原论文,第 3.1 节
若所有访问集中在列表 A,P0 仍会成为热点。增加其他列表的负责节点,对这个热点的帮助有限。跨列表一起修改的业务还需要定义事务,例如同时删掉旧群记录并加入新群;每个列表各自正确的读写接口,并没有定义这组修改的共同提交过程。
故障切换也要处理“旧主只是暂时失联”的情况。P1 被选为新主后,P0 可能恢复连接;协议需要让旧授权失效,并确定哪些操作已经确认,才能继续同一份对象历史。Raft、Paxos 等协议用于协调这类决定。单凭超时和一个递增序号,还不足以完成安全切换。
写入序号
序号表示第几条更新,数据值表示写了什么。例如 〈seq=1,value=1〉 和 〈seq=2,value=2〉 分别是第一、第二次写入。接收方维护 next_seq:期待 1 时先执行 1,再把期待值改为 2。即使值恰好等于序号,这两个字段也各自承担不同职责。
primary 发出两次更新,也要让所有副本按它规定的顺序应用。
思考题:primary 安排先写 1、再写 2,backup 却先收到写 2。仅按到达顺序执行会得到什么结果?附上 seq=1、seq=2 后,backup 应怎样等待与应用?
解答:
只按到达顺序,primary 最终为 2,backup 可能为 1。序号把原顺序带给接收方:先到的 seq=2 暂存,seq=1 执行完再应用 2;缺失与重复消息按协议补传和去重。
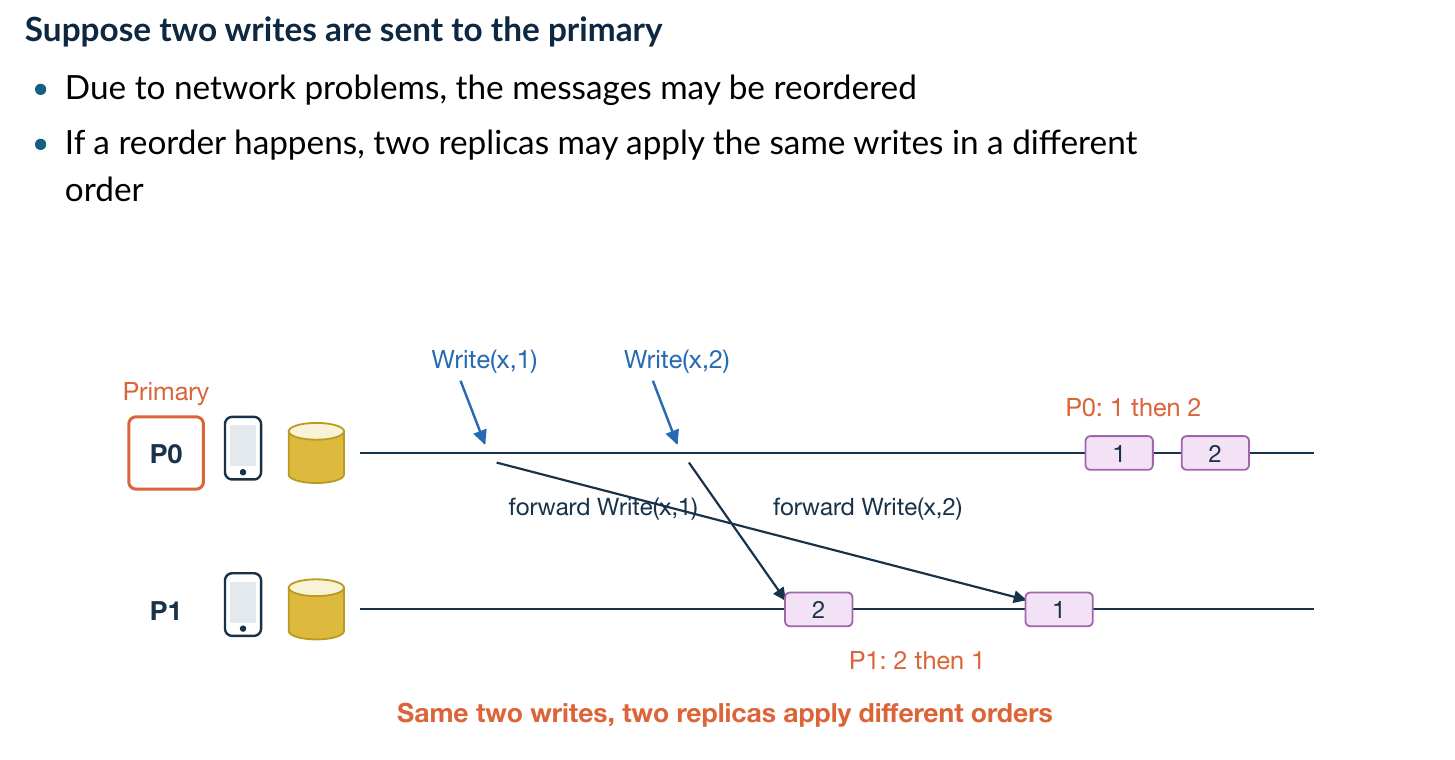
P0 先安排 Write(x,1),再安排 Write(x,2)。P1 若先收到第二条消息,并直接执行,就会先写 2、再写 1。最终 P0 为 2,P1 为 1。
为每个更新分配递增序号,可以明确记录 primary 的顺序。
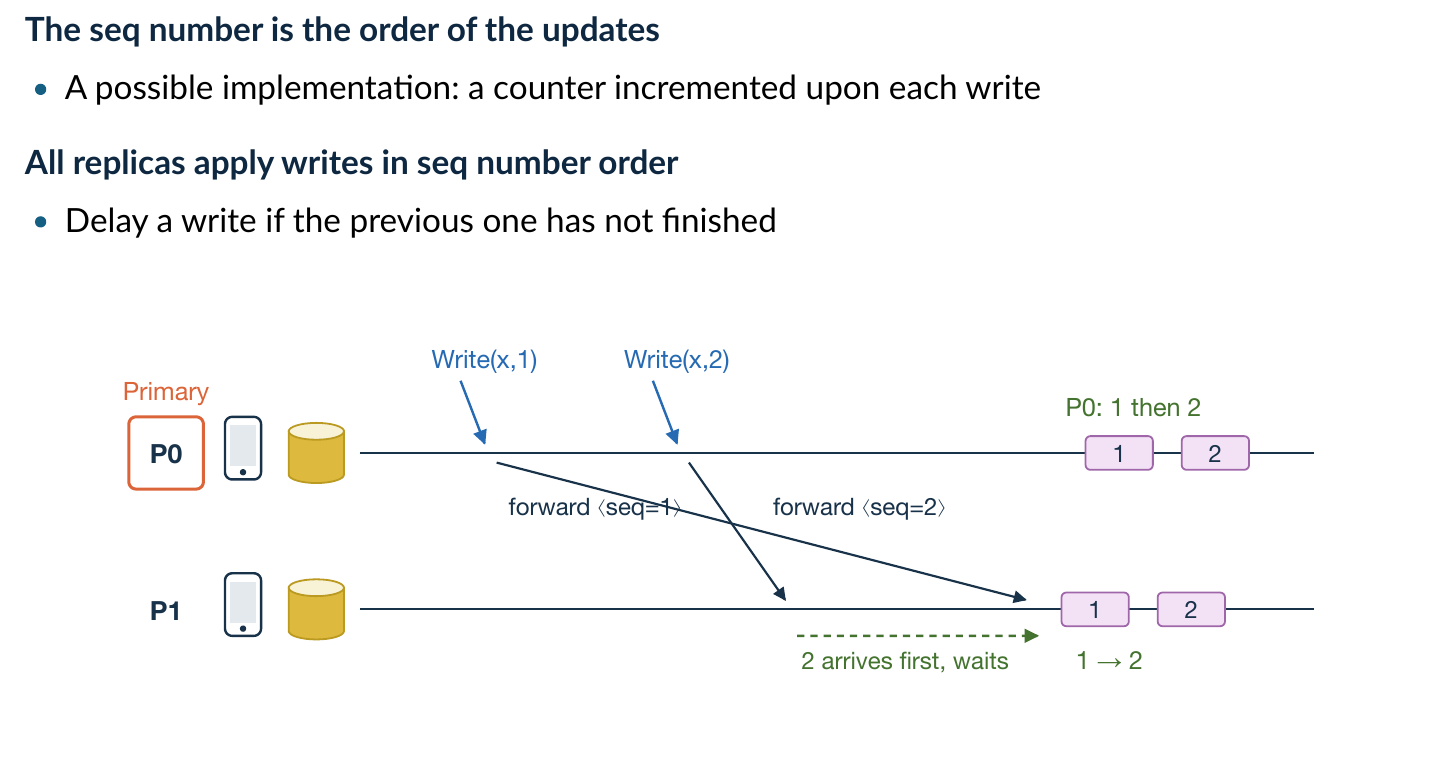
P0 为两条更新分配 seq=1、seq=2。P1 收到 2 时,先放进等待区;收到并执行 1 后,再执行 2,最终两边都是 2。
可以用 next_seq 记录下一条应执行的序号。序号较大时等待前面的更新,重复消息按序号和请求标识检查处理记录,缺失消息通过重传补齐。顺序由序号保存,网络到达时间只影响等待多久。
复制成本
这套 primary-backup 实现增加了转发和确认。写入需要经过 primary,并等待 backup 返回;读取也要进入统一安排,primary 的处理量和网络往返会影响性能。
思考题:要求 primary 排序、全部 backup 确认时,多出哪些等待?primary 失效或某个 backup 失联,分别会影响哪些操作?
解答:
写入多出转发与等待备份确认的时间,要求全部确认时由最慢备份影响完成时间。primary 失效会使统一读写入口暂停,需要确定新主并恢复已确认记录;backup 失联会阻塞要求全确认的写入。若读也排在这个未完成写入之后,它会被连带等待。
primary 失效后,其他节点需要确认新的负责者;若写入要求全部 backup 确认,一个 backup 失联也会阻塞写入。这套简化实现需要等待故障节点恢复,或通过额外协议重新确定参与写入的节点。
要在部分节点失效后继续工作,需要选出负责排序的节点,恢复已确认的记录,并重新确定哪些副本能够参加确认。参与节点数和确认条件决定了需要交换多少消息、等待多少回复。
顺序一致性
程序顺序是单个进程自己依次执行操作的顺序。例如进程 A 先写 2、再读,解释结果的共同串行顺序也要把它的写放在它的读前面。不同进程之间的操作,要结合模型规定的关系安排。下面的例子让两次读取由不同进程执行,以检查它们可被排列成怎样的顺序。
让读取直接使用本地副本,可以减少一次向 primary 请求数据的等待。下面检查这种读法会返回什么结果。
思考题:初始 x=1,写请求与两次读取分别由不同进程发起。P1 收到写 2 并读到 2,这次读完成后,P0 的读者才开始读取,却仍返回 1。
- 这段历史满足线性一致性吗?
- 怎样排列这三次操作,可以解释为合法串行结果?
- 解释为顺序一致性时,还要检查每个进程的什么条件?
解答:
- 违反线性一致性。先一次读取已经得到 2,随后发起的读取又得到 1,中间没有其他写入,无法保留完成到后续发起的实时关系。
- 可按
P0读1、写2、P1读2排列,解释为合法的单对象串行结果。- 顺序一致性还要求保留每个进程自己的完整程序顺序。题中三次操作由不同进程发起,给出的排列没有颠倒任何进程内部顺序;若同一进程先写后读,还要保留它的写先于读。
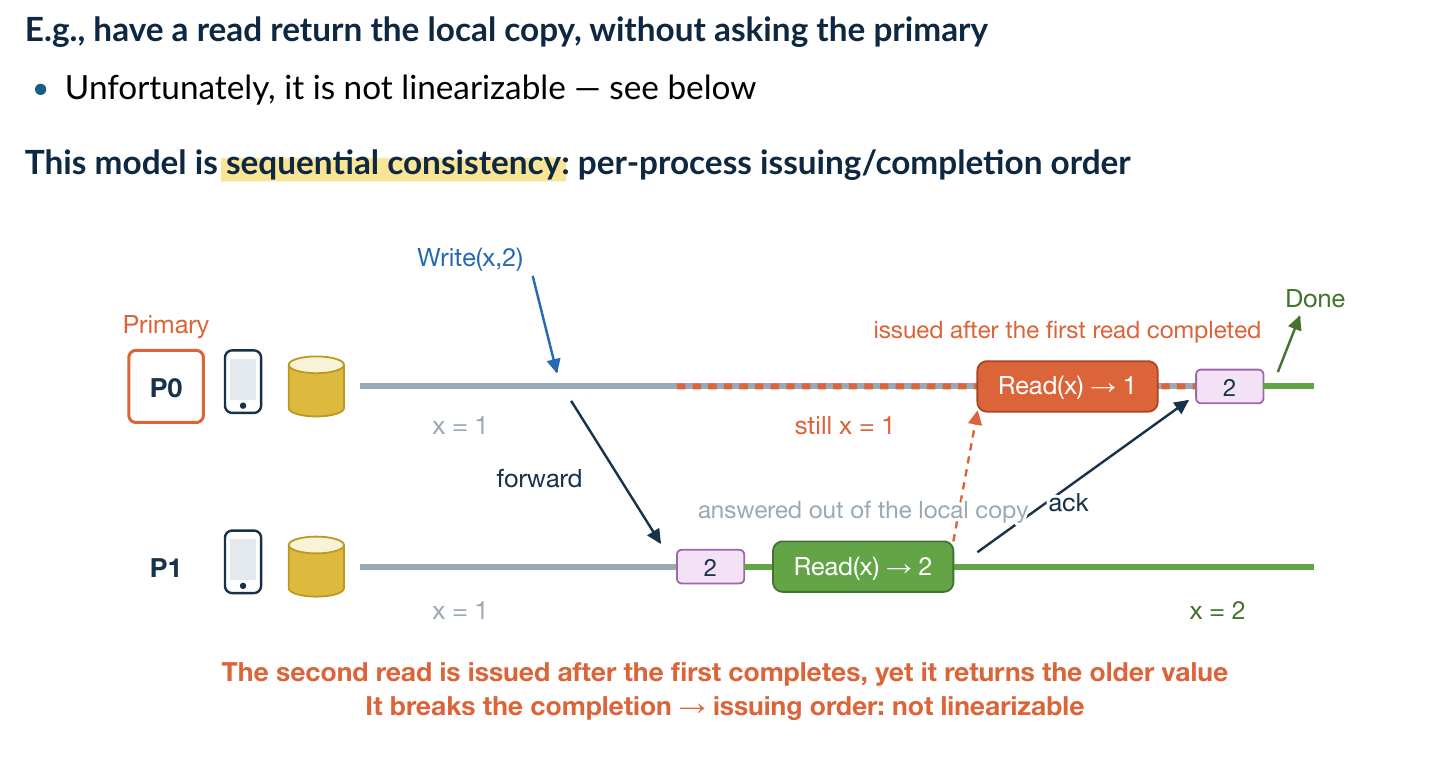
初始 x=1。P0 发出 Write(x,2),P1 先执行更新,返回给 P0 的 ACK 还在路上。P1 的读者读到 2;这个读取完成后,P0 上的另一个读者发起读取,本地仍为 1,返回 1。
图中的 P0、P1 表示所在节点,每个节点可以运行多个调用进程。下面将写请求和两次读取分别看作三个进程的操作,检查它们能否形成共同的串行顺序。
若这段历史满足线性一致性,读到 2 说明写 2 已经生效。后一次读取又发生在第一次读取完成后,中间没有其他写入,因此也应返回 2。图中的实际结果违反了这项实时顺序要求。
顺序一致性要求存在共同的合法串行顺序,并保留每个进程自己的程序顺序。两个读取属于不同进程时,可以尝试以下顺序:
| 串行位置 | 操作 |
|---|---|
| 1 | P0 的读者读取,返回 1 |
| 2 | 写入 x=2 |
| 3 | P1 的读者读取,返回 2 |
这个顺序能解释两次读取的数值。它把两个不同进程的读取排列为旧值在前、新值在后。线性一致性还要保留实际的“第一次读取完成、第二次读取发起”关系,所以对同一段历史提出了更多要求。
实现顺序一致性时,还需要检查每个进程的完整调用序列。例如,一个进程先写入、再读取,或连续执行两次读取,都要在共同串行顺序中保留它们的程序顺序。系统应按这个条件安排会话与副本读取。
仅允许从任意本地副本读,并不能保证上述条件。例如同一进程先在 P1 读到 2,随后改去尚未更新的 P0 读到 1,中间没有其他写入。程序顺序要求先保留读 2、再保留读 1;单对象历史又要求写 2 排在读 2 前面,读 1 排在写 2 前面,两项要求形成循环。实现可以让读取等待相应更新进度,或使用满足进程顺序的会话规则。
练习:只有一次把 x 从 1 改为 2 的写入。同一个进程连续两次读取,先得到 2、后得到 1。能否用“读 1、写 2、读 2”解释为顺序一致性?
解答:
这个排列颠倒了该进程的两次读取,违反程序顺序。保留读 2 在读 1 前面时,又找不到符合这两次数值的合法寄存器顺序。因此这段历史违反顺序一致性。前面图中的两次读取属于不同进程,才能使用给出的排列。
备用副本也可以在额外协调后提供线性一致性读取,例如先确定读取需要达到的已提交进度,再等本地应用到该位置,协议还要确认负责者的授权。上述反例针对直接返回本地状态的读法。实际服务应按其读取接口承诺的保证使用;etcd 的 API 保证也区分需要协调的线性读取和可能返回旧值的本地读取。
内存顺序
多核程序也需要考虑读写的可见顺序。一个核把值写入自己的写缓冲区后,另一个核可能尚未看到它;编译器和处理器也会在允许范围内调整独立访问的顺序。内存屏障(memory barrier,或 fence)为屏障两侧的指定访问建立顺序约束,程序通常结合原子操作、锁和配对的同步操作使用它。Linux 内存屏障文档
例如一个线程先准备消息内容,再发布“消息已准备好”的标志。读取线程需要按配套规则读取标志与内容,使“看到标志后使用内容”具有相应保证。不同屏障提供不同范围的约束,需要依据语言与硬件模型选择。
顺序一致性和 TSO(Total Store Order)有不同规则。TSO 允许某些较早写入仍留在缓冲区时,执行后面的读取。因此,硬件提供的模型、编程语言的原子操作规则和应用需要的顺序,要分别核对。Linux 内存模型说明
模型选择
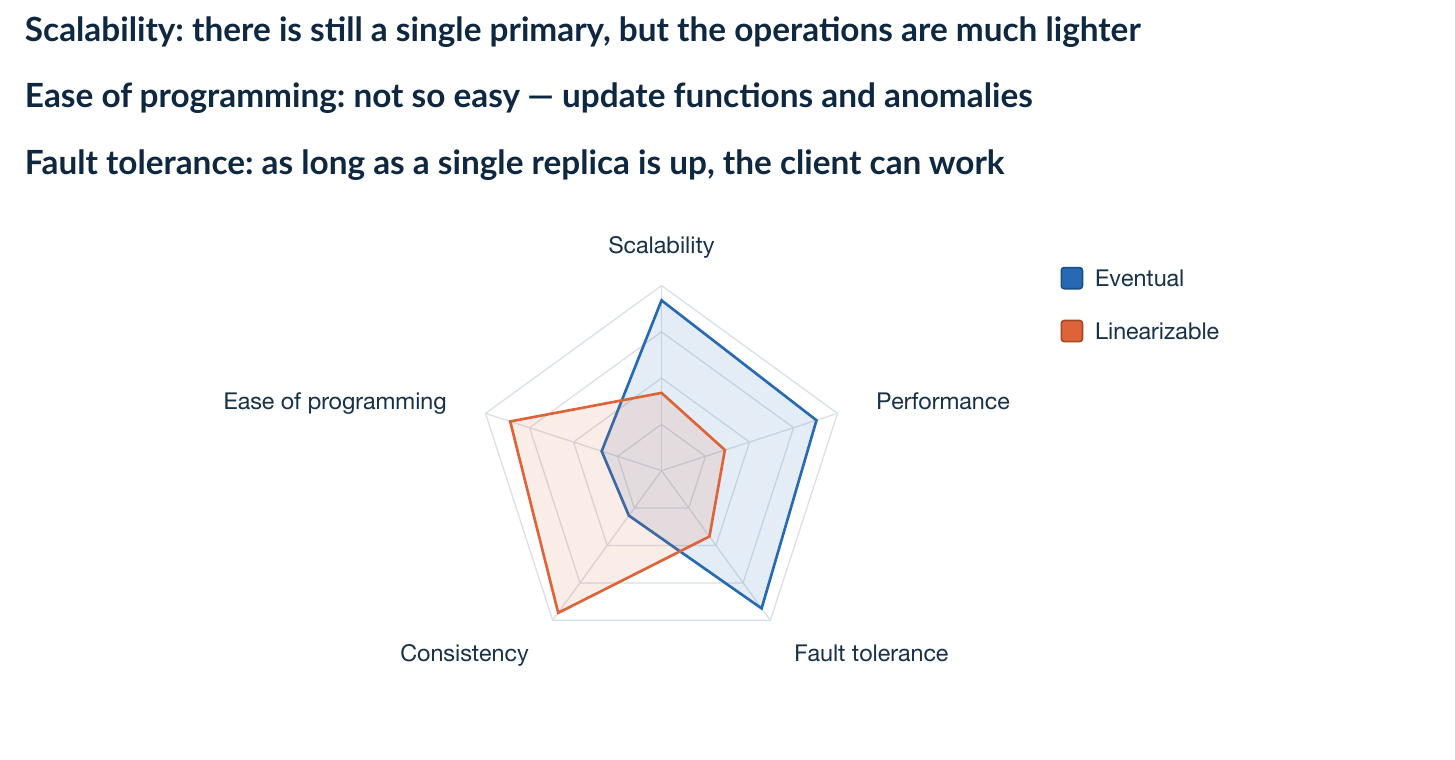
思考题:最终一致性适合每一种应用吗?普通聊天与按名次发奖的接龙,需要怎样规定临时结果、冲突和最终确认?
解答:
最终一致性适合可以接受临时缺少消息、之后同步合并的用法。聊天可以先显示本地记录并标记发送状态,引用还需等待目标消息可见。按名次发奖的接龙应先确认名次,或检测并处理并发报名,再按奖项规则结算;直接把未确认的本地位置作为最终结果,会使名次在同步后变化。
图中的雷达图用于概括设计倾向,轴上没有测量单位和实验数值。最终一致性的本地操作减少了协调等待,应用要处理延迟可见、顺序调整和冲突。线性一致性让程序按对象的串行规则判断结果,实现则需要安排确认、排序和故障恢复。
聊天记录可以先显示本地消息,后台持续同步,并保留引用依赖。按名次发奖的接龙需要明确确认顺序,或在并发时报告冲突。存储文件、修改目录、递增计数等操作,也要结合各自的业务规则选择保证。
分析一个并发系统时,可以依次检查四件事:数据状态是什么,操作怎样修改或读取状态,事件之间有哪些依赖,以及读取结果要保留哪种先后关系。时钟帮助记录事件关系,读写和同步协议负责实现一致性要求。
参考资料
- Fire-Flyer File System(3FS),DeepSeek,2025。
- Fire-Flyer AI-HPC,An 等,2024。
- 3FS design notes,DeepSeek,2025。
- The Google File System,Ghemawat、Gobioff、Leung,2003。
- MapReduce,Dean、Ghemawat,2004。
- GFS: Evolution on Fast-forward,McKusick、Quinlan,2009。
- Eventually Consistent,Werner Vogels,2009。
- Time, Clocks, and the Ordering of Events in a Distributed System,Leslie Lamport,1978。
- Linearizability: A Correctness Condition for Concurrent Objects,Herlihy、Wing,1990。
- A comprehensive study of Convergent and Commutative Replicated Data Types,Shapiro 等,2011。
- Linux 时间与计时源、NTPv4。
- Dynamo: Amazon’s Highly Available Key-value Store,DeCandia 等,2007。
- Linux 内存屏障、内存模型说明。
- etcd API 保证。