应用系统体系架构-06:Agent 架构
Agent根据目标、当前状态和环境反馈选择下一步行动。模型提供分类、规划和候选决策,工具取得事实或改变系统,编排层管理状态、分支、预算与恢复。
与固定流程相比,Agent 可以根据观察调整路线,但自主程度需要明确限制。任务是否完成,应由业务结果和验证条件判断,而不能只依据模型说“已经完成”。
系统组成
可以把 Agent 分成推理与执行两部分:推理层理解目标、拆解任务和选择能力,执行层通过 MCP、RAG 和工具与外部环境交互。这是一种职责划分,不表示模型直接拥有这些系统的访问权。
| 要素 | 工作内容 | 需要保留的信息 |
|---|---|---|
| Perception | 读取问题、日志、文档和业务状态 | 来源、时间、权限和版本 |
| Reasoning | 分类、规划和选择候选动作 | 目标、依赖与决策结果 |
| Action | 调用工具并取得真实结果 | 调用 ID、状态和副作用 |
| Observation | 检查执行反馈与目标进展 | 错误、证据及下一步条件 |
一次诊断 API 504 的任务,可以先读日志和架构资料,再检查数据库与连接池,必要时提出 SQL 修改。每一步都是待验证假设,不能把一个常见原因直接当成当前故障原因。
一次用户 Query 可能包含多次模型调用:先判断需要哪个 Skill,再读取其规则,生成工具参数,接收执行结果,最后组织回答。编排器需要保存这些中间信息,并在每轮检查权限、参数类型、执行次数和 Token 预算;用户只发送一次请求,并不意味着后台只调用一次模型。
Host承担连接与执行职责。通用 IDE 或桌面应用已经提供会话、MCP 和工具执行能力;专用 Agent 可以将这些能力放进自己的后端服务。n8n、Dify 等平台提供可视化编排,LangGraph 和 Spring AI 提供代码层面的构建能力。专用程序减少了不需要的界面与功能,但实际速度仍取决于模型、输入长度、工具和网络。
模型可以通过适配器替换,执行工具的接口尽量保持稳定。替换前仍需检查模型是否支持 Tool Calling、结构化输出、所需上下文长度和数据处理方式。协议兼容也不保证两个模型会选择相同工具或给出同等质量的判断。
推理范式
ReAct交替进行判断、行动与观察。它适合逐步取得证据的任务,如网络诊断、代码修复和多数据源查询。动作应针对当前假设获取信息,重复查询没有新结果时需要调整或停止。
Plan-and-Execute把规划与执行分开:Planner 生成子目标和依赖,Executor 完成具体步骤,Replanner 根据结果调整计划。复杂重构可以先建立测试基线,再读取模块、修改实现、运行测试和检查兼容性。
Reflexion将反馈形成语言化经验,存入情境记忆用于后续尝试。失败记录需要说明任务、原因、修正与适用范围,不能把一次经验推广到所有情形。
| 范式 | 适合情况 | 必须控制的边界 |
|---|---|---|
| ReAct | 每步需要外部观察 | 步数、工具权限、观察可信度 |
| Plan-and-Execute | 复杂依赖与长任务 | 计划验收、执行失败、重新规划 |
| Reflexion | 多次尝试可利用经验 | 经验质量、重试预算、适用范围 |
Plan-and-Solve 更强调问题分解与求解提示,Plan-and-Execute 更强调执行子任务的架构;可以借鉴共同分层思路,但不应认为所有方法具有相同实现。
三种范式的差别可以通过执行记录理解。
| 场景 | 初始处理 | 新反馈 | 后续处理 |
|---|---|---|---|
| ReAct 排查 504 | 对网关进行连通性检查 | Ping 丢包或被阻断 | 检查服务日志、连接池与实际请求路径,验证其他假设 |
| Plan-and-Execute 重构 Java 模块 | 建立测试基线,分析依赖,再修改实现 | 某一步发现不熟悉的框架接口 | 向计划插入文档检索,再执行修改与回归测试 |
| Reflexion 修复解析程序 | 生成实现并运行 pytest | 对 None 使用下标,引发 TypeError |
保存“该输入可能为空,需要先验证”的经验,修改后重新测试 |
Ping 失败不能直接证明数据库连接池耗尽,也可能只是 ICMP 被禁用;测试全部通过说明程序满足当前测试覆盖的条件。Reflexion 的 Actor 负责尝试,Evaluator 给出测试或环境反馈,Self-Reflection 将反馈整理为下一次可使用的经验。它改变后续输入上下文,通常不涉及更新模型权重。
在 504 的示例中,后续工具若报告连接数为 200/200,可以进一步验证连接池耗尽是否影响当前请求;扩大容量前还应确认数据库能够承受新增连接。生成扩容 Patch 与成功应用并验证 Patch 也需要分别记录。
重构示例的计划可以包含扫描 OrderService.java 的 AST、SQL 与依赖,检查 javax.* 到 jakarta.* 的映射,按项目目标调整持久层,再在 Docker 环境中运行测试。映射缺失时插入 Jakarta 迁移文档检索,然后恢复原步骤。MyBatis 转为 Spring Data JPA 是示例中的独立重构目标,并非所有 Spring Boot 3 升级都必须进行。
Reflexion 在特定 HumanEval 实验中报告最终候选通过率从比较基线的 80% 到 91%,相差 11 个百分点,不能写成所有场景都固定提升某个百分比。这里的 pass@1 描述最终提交候选的通过情况,Agent 生成该候选前可以经历反馈与修订;比较效率时还需要考虑模型、测试反馈、尝试次数和 Token 成本。
反馈闭环
Agent 的一次循环可表达为“感知状态—形成决策—执行动作—验证结果—更新状态”。控制器应同时维护成功条件、失败出口、最大步数、总时间和成本预算。
外部测试失败可以触发修订,资料不足可以触发补充检索,权限不足则需要拒绝或等待规定审批。没有新证据的反复自我修改,不一定提高正确率。
代码修复就是一个常见闭环:生成或修改代码,运行程序与测试,将异常、退出码和失败测试返回给模型,再执行新的修改。图可以回到较早节点,因此允许有向环;如果只用固定 DAG 表达,就需要把重复步骤展开,或由外层控制器管理重试。
有向环必须有终止条件。达到验收条件时结束,超过调用次数、Token、总时间或无进展阈值时失败退出。把“没有报错”作为成功条件仍可能遗漏功能错误,业务验收和测试断言也应纳入判断。
计划、动作请求、工具完成、业务成功需要分别记录。状态图和日志应让这些阶段能够被区分。
记忆设计
短期记忆保存会话和当前任务状态,长期记忆保存可复用事实或经历。短期信息包括当前目标、已完成步骤、最新证据和待办;长期信息可能包括已确认偏好、项目约束和历史失败经验。
长期存储需要来源、权限、版本、过期和删除规则。向量库可以用于检索,但不能保证记忆正确;模型自己生成的内容不应未经验证就成为其他任务的可信知识。
短期上下文受 Token 预算限制,可以保留结构化摘要并让原始记录可检索。错误假设和过时方案应明确标记或移除,避免恢复时把它们当成有效事实。
任务状态、聊天历史和缓存具有不同目的。任务状态记录图运行到哪里,聊天历史帮助理解“刚才推荐的第二本书”,缓存则避免重复读取相同资料。三者可能使用同一存储系统,但需要各自的键、有效期和更新规则。短期记忆按任务或会话划分,并不要求一定只保存在内存;持久化聊天记录仍然可能属于当前会话的短期记忆。
历史故障曾通过把连接池容量调整到 300 解决,只能成为新的排查线索。即使检索相似度为 0.94,也不能据此直接修改当前配置。当前容量、数据库负载和故障原因可能已经变化,应重新取得证据,再决定是否采用同一方案。
基础设施
MCP、RAG 与 Skill 提供互补能力。
- MCP统一发现与访问外部系统的方式。
- RAG提供当前任务所需的文档证据。
- Tool / Skill提供实际操作或可复用工作规范。
三者由 Host 与编排器协调。MCP 不替代检索算法,RAG 不授予写入权限,Skill 文件也不自动执行事务。接口应统一任务 ID、租户、Trace、结果和错误语义。
这些能力可以沿一条任务链配合:Prompt 明确目标与约束,RAG 检索接口规范和运维 SOP,MCP 查询 GitHub、Jira、CRM 或数据库的当前情况,Skill 规定可复用的处理步骤,Agent 组织执行与反馈。修补仓库前可以先检查 Circuit Breaker、Dry-Run 差分和基线快照,执行后再验证与记录结果。可回滚性取决于真实操作及补偿机制,通知、邮件等动作未必能撤销。
RAG 常用于相对稳定的文档,但知识库也可以更新;代价包括文档解析、重新分块、Embedding 计算、索引更新及旧版本失效。把文本切成独立块可能丢失跨段关联,可以通过父子块、相邻块或 GraphRAG 补充关系。实时信息通常由业务 API 或 MCP 取得,随后也可以与文档证据一起进入模型上下文。
Skill 可以把常用 Prompt、步骤、工具要求和参考文件组织成可复用资源。详细规则按需加载,避免一次把全部文本放入上下文。当 Skill 数量很大时,可以先按元数据或语义检索缩小候选,再由模型选择。例如从 1000 个 Skill 中筛出 10 个候选,是一种控制检索和上下文成本的方法,具体数量需要依据召回率与预算调整。
并非每个 Agent 都必须同时使用这三类设施。算术 Agent 可以只使用本地工具,图书查询可以只接 MCP,文档问答可以主要使用 RAG;需要的能力由任务决定。
状态图
固定线性链适合步骤稳定的任务;当任务需要条件分支、循环、审批和恢复时,**状态图(State Graph)**更容易表达控制过程。
节点完成有限职责,状态传递业务数据,边规定下一步。常见节点包括分类、检索、业务查询、起草、验证、审批和发送。节点过大不易独立测试,过细则增加编排开销,应按业务变化和验证边界划分。
LangGraph 用 StateGraph 定义图,节点接收状态并返回局部更新。状态应优先保存原始输入与结构化结果,Prompt 在节点内按需要装配,避免把可变化的提示文本当成业务事实持久化。
设计时先画出业务步骤,再确定每一步的输入、结果和失败方式,最后设计节点之间共享的数据。节点可分为 LLM、Data、Action 和 User Input 四类,分别负责推理生成、资料读取、外部写操作与人工输入。检索和起草分开以后,可以独立设置重试、缓存和观测;节点粒度也会影响失败恢复时需要重做多少工作。
这个过程与已有软件设计经验相通。Servlet Filter 可以通过 request attributes 向后续处理传递数据;Spring MVC 的 HandlerInterceptor 在处理器调用附近工作,与 Servlet Filter 属于不同扩展层。React 中多个组件需要共享状态时,通常把状态放在共同父组件,通过 props 传递给子组件。Agent 的共享状态同样需要清楚的归属与更新规则,但 HTTP 请求属性不会自动跨请求持久化,React props 也不是可随意修改的共享字典。
LangGraph 是负责状态、调度和恢复的编排库,能够配合 LangChain 的模型和工具接口,也可使用其他调用方式。图中的节点与 MCP Server 是不同概念:节点代表一段控制逻辑,工具节点可以调用本地函数或远程 MCP Server。编译图得到可调用的执行对象,绘制图形只是帮助检查连接关系,Agent 本身可以在无界面的后端运行。
共享状态
邮件 Agent 的流程比算术复杂,设计方法相同:先列出阅读、分类、检索、Bug 跟踪、起草、审核与发送步骤,再确定共享状态。状态记录任务所需数据,避免每个节点定义一套互不兼容的参数。
| 字段 | 用途 | 产生位置 |
|---|---|---|
email_content、sender_email、email_id |
原始邮件、发件人和业务标识 | 邮件入口 |
classification |
意图、紧急程度、主题和摘要 | 分类节点 |
documents |
知识库原始资料块 | 检索节点 |
customer_history、ticket_history |
客户资料和历史工单 | CRM / MCP 查询 |
draft_response |
可供审核的回复文本 | 起草或人工编辑 |
approved、status、error |
审核结果、执行状态和错误 | 控制节点 |
分类对象是全局任务状态中的一部分。Literal 把意图限制为 question、bug、billing、feature、complex,把紧急程度限制为 low、medium、high、critical。主题和摘要无法预先列举,仍使用普通字符串。这样的类型约束减少未约定的取值,但不能代替运行时校验,也不能保证模型把业务含义分对。
1 | from typing import Literal, TypedDict |
TypedDict 用于静态类型检查,Pydantic 用于验证实际输入或模型输出。上面的 classification: dict 表示存储已经由 EmailClassification 验证并转换出的普通字典;若希望加强静态检查,还可以为它单独定义 TypedDict。
应保留原始邮件、检索块和结构化分类,节点需要时再拼装 Prompt。这样同一资料可以用于不同任务,修改 Prompt 模板也不必迁移任务状态。消息式 Agent 必须保存消息历史以维持模型协议,这与避免在业务状态中重复保存整段临时 Prompt 并不冲突。
共享状态不意味着任何并发写入都能自动合并。多个并行节点更新同一字段时,需要 reducer 或按 ID 聚合;更新不同字段则仍应保证数据属于同一任务版本。图执行器可复用,节点闭包中的客户端、全局缓存和业务对象是否支持并发,需要分别确认。
条件路由
条件边根据状态选择下一节点,返回值必须属于已注册节点或结束标识。可按意图、紧急度、证据充分性与审批结果路由。
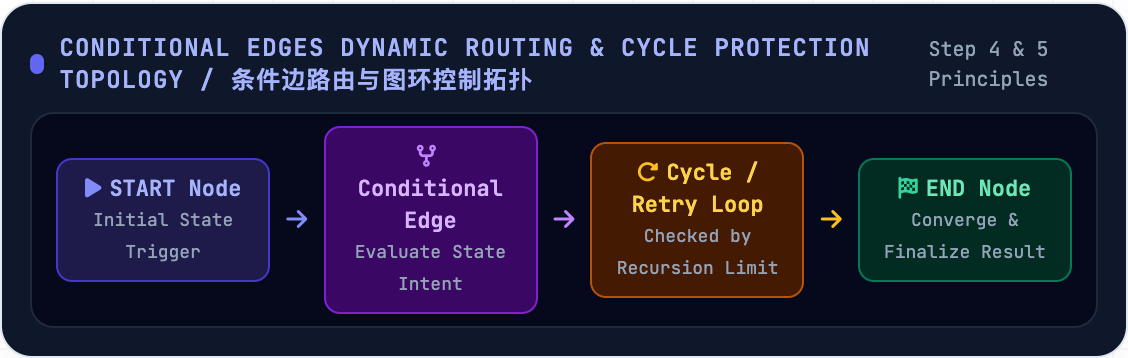
邮件流程可以采用以下分支。规则按从上到下的优先级判断,避免普通 Bug 分支绕过紧急事件处理。
| 条件 | 后续节点 | 原因 |
|---|---|---|
billing 或 critical |
人工处理 | 账单和极紧急事项需要专门核查 |
question 或 feature |
文档检索 | 查找产品规则、功能说明或既有答复 |
bug |
Bug 跟踪 | 查询或登记问题,取得工单资料 |
complex |
人工处理 | 超过既定自动处理范围 |
起草后为 high / critical,或质量不足 |
人工复核 | 避免未经检查就发出高风险答复 |
条件路由可以通过 add_conditional_edges 配合 path_map 完成;也可以让节点返回 Command(update=..., goto=...),同时更新状态和指定目标。两种方法需要保持一致,不能给同一节点叠加互相冲突的无条件后续边。
循环需要最大尝试次数、进展检测和失败出口。recursion_limit 限制图运行的 super-step 数,是图调度层的保护;它不限制一个节点运行多久,也不等于模型调用次数或工具调用次数。模型给出的候选分类仍需校验,关键权限和业务转移由确定性程序检查。
工具循环
用自然语言输入“三加四等于几”,可以清楚地观察 Agent 的内部过程。模型理解问题并提出 add(a=3, b=4) 请求,执行器运行加法函数得到 7,再把 7 交回模型生成回答。模型调用和工具调用是两个步骤,工具结果进入上下文以后,模型也可能继续请求其他工具。
图的连接关系如下:
1 | START → llm_call → should_continue |
llm_call 和 tool_node 是执行节点,should_continue 是条件边的路由函数。路由函数通常由程序调用,不必注册成独立业务节点,也不会因为写了 docstring 就自动交给模型判断。
Tool Calling需要三个约定:工具名称用于查找能力,参数 Schema 用于验证输入,调用 ID 用于把结果关联到对应请求。bind_tools 向模型提供这些元数据,真正执行仍由 Host 完成。这里的本地函数可以承担工具角色,但没有实现 MCP 的初始化、传输和协议接口,因此不能直接称为 MCP Server。
下面的算术工具在加法中接受负数,因而 add(7, -2) 可以表达减法。除法使用 /,得到的是浮点结果;若业务要求整除,需要明确采用 // 以及向下取整规则。为了让除法结果能够继续参与计算,这里统一采用有限浮点数。金额或必须精确表示的数值应另行设计 Decimal 或有理数接口。
1 | import math |
@tool 将函数包装为工具,其 docstring 会成为工具描述的一部分。描述应说明用途、参数及限制,便于模型选择。普通图节点的 docstring 主要用于代码维护;只有显式把它加入 Prompt 或工具元数据,模型才能读取。
消息状态
算术 Agent 至少需要 messages 和 llm_calls:前者保存用户输入、模型工具请求、工具结果和最终回答,后者记录模型调用次数。这里再加入工具次数、Token 用量和运行状态,用来区分完成与预算终止。
1 | from typing import Annotated, Literal, TypedDict |
节点通常只返回局部更新,例如 {"messages": [reply]}。Reducer决定如何把新值合入旧状态。列表没有 reducer 时,更新会替换原列表;operator.add 可以简单追加,add_messages 还可以按消息 ID 更新已有消息。计数字段在本例中返回新的累计值,因此使用默认覆盖行为。
消息历史按角色组织:HumanMessage 表示用户输入,AIMessage 表示模型输出,ToolMessage 表示执行结果。模型请求工具时,正文可能为空,调用信息保存在 tool_calls,不能只检查 content 判断是否得到回答。每项工具结果需要携带原请求的 tool_call_id,否则后续模型无法可靠对应多个结果。
1 | import json |
执行端从 tools_by_name 取得实际工具对象,然后将模型给出的参数传给 invoke。调用 ID 只是请求与结果的关联标识。调试器显示的函数对象、内存地址或对象表示属于本地运行细节,不是模型拿着机器指针执行函数。
本例把参数错误作为 Observation 反馈给模型,允许它在预算内修正;未知工具和系统错误向调用方抛出。计数记录已返回的模型调用与执行到的工具请求,生产计费还要在调用网关记录失败、超时和重试的实际用量。Token 检查发生在轮次之间,不能防止某一次输出越过余额;严格预算需要执行前预留额度、限制单次输出,再依据真实用量结算。usage_unknown 为真时也不能把累计值视作完整消耗。
算术执行
模型、工具和图连接好以后,初始状态中放入自然语言问题即可运行。把代码写进 Notebook 便于分块演示,也可以作为普通 Python 后端模块运行。
1 | from langchain_ollama import ChatOllama |
一种可能的消息记录如下,具体措辞和调用 ID 可以不同:
| 顺序 | 消息角色 | 主要内容 |
|---|---|---|
| 用户输入 | Human | 三加四等于几? |
| 第一次模型输出 | AI | add,参数 a=3, b=4,调用 ID 为 call_1 |
| 工具观察 | Tool | {"ok": true, "value": 7.0},关联 call_1 |
| 第二次模型输出 | AI | 三加四等于七,tool_calls 为空 |
因此这一条执行路径包含两次模型调用、一次工具调用。若问题变为“先算三加四,再乘五”,可以先得到 7,再调用乘法得到 35;两个运算有依赖,不能把依赖尚未产生的值作为已知参数。一次模型输出也可能请求多个相互独立的工具,执行器需要逐一返回对应结果。
temperature=0 用于减小采样随机性。通常温度通过缩放 logits 改变候选 Token 的概率分布,温度趋近零时更偏向最高概率候选;它不表示模型只计算一个固定词,也不保证跨硬件、服务版本和并发条件完全一致。更不能由低温度推导出结果正确,正确性仍依赖工具计算、输入验证与业务验收。
对温度 ,一种常见采样分布为
其中 是候选 Token 的 logit。较小的温度使分布更集中,较大的温度使分布更平缓;零温度通常由服务实现为贪心选择或相应极限规则,不能直接把零代入分母。
图能到达 END 是必要条件,但如果模型一直请求工具,仍可能不断绕环。显式预算和 recursion_limit 提供不同层面的停止条件。预算终止时应返回失败或未完成状态,调用方不能把最后一个工具请求当成最终答案。
本地推理
Ollama 提供本地模型接口,ChatOllama 将其接入节点。模型可以通过 with_structured_output 返回限定的分类对象。紧急程度的业务定义应写清楚,例如 critical 对应当前服务大范围不可用,不能只依赖模型理解这个英文单词。
1 | from langchain_ollama import ChatOllama |
Schema 校验会拒绝未知意图或缺少字段的结果;分错但格式正确的分类还需要测试样例和业务规则发现。模型与适配器必须支持相应结构化输出方式,实际项目应固定兼容版本。
LLM 节点涉及 I/O 和非确定性,不能因其接收状态并返回字典就称为严格纯函数。本地运行模型也不表示整套应用完全离线:若 MCP、搜索或遥测访问外部服务,仍需按完整链路确认数据流向。
检索与业务
检索节点通过分类中的主题生成 Query,查询知识库后保存原始资料;MCP 节点取得客户和工单的当前情况。业务接口可以通过依赖注入传入,方便测试时替换为固定数据实现。
1 | from typing import Protocol |
Protocol 中的省略号表达接口约定,真实实现仍需完成 MCP 初始化、认证、超时、结果校验和工具错误处理。知识检索可使用 Retriever 的异步接口;CRM 查询应以受信的客户标识和权限范围查询,不能依据邮件正文自报的身份授权。
演示时用固定字符串充当检索结果、用模拟记录充当工单,能验证路由和状态传递,但不能证明真实 RAG、MCP 或 Bug 登记已经运行。若需要创建或更新工单,应增加独立受控动作和幂等键,不能把只读查询函数误认为已完成写入。
真实资料应保留来源标识、时间、版本和错误。起草时还要区分历史工单与当前事实;没有检索结果或查询失败时,应保留“无法确认”的状态。
邮件起草
起草节点读取原始邮件、分类、资料块与客户历史,在节点内部组织 Prompt,把模型正文存为 draft_response。这些字段分别承担内容、处理优先级和证据约束,不能只把原始邮件重新发给模型就认为完成了资料增强。
1 | import json |
如果状态需要保存消息轨迹,可以再加入带 reducer 的消息列表。原始邮件、证据和草稿属于不同阶段,应分别保存,便于审核者看到答复依据,也便于修改 Prompt 后重新起草。
图的组装
图构造函数注册节点,再添加入口、条件边与终点。下面实现分类、按需查询、起草与审核。输出是完成或审核过的草稿,邮件发送留给独立业务动作。
1 | from langgraph.graph import END, START, StateGraph |
普通产品问题走文档查询,Bug 走工单查询,不要求每封邮件都查询所有系统。两类查询结果都可以进入起草;账单、极紧急或复杂问题则直接交给人工处理,此时还可能没有草稿。人工节点因此需要接收原邮件和分类,而不能假定 draft_response 一定存在。
业务需要自动发送时,应增加 Send Reply 节点,并让审核后路由检查批准、最终文本、收件人和业务状态。邮件发送适配器需要超时、幂等和发送凭证;拒绝分支结束或转人工,修订分支重新起草并在预算内复核。生成草稿、批准草稿和发送成功是三个不同结果。
中断与恢复
HITL将需要外部决定的任务保存下来,稍后恢复。动态 interrupt() 给调用方返回待处理载荷;批准或拒绝值通过 Command(resume=...) 提交。没有草稿的账单任务可以由人工直接补充最终答复,已有草稿也可以编辑后批准。
1 | from pydantic import BaseModel, ConfigDict, Field |
应用完成上述函数定义后,才实例化依赖并调用 build_email_graph 和编译函数。异步检索与工具节点通过 ainvoke 执行;恢复只应发生在对应任务已经挂起时。拒绝、过期或参数变化还需要各自业务处理。
中断节点在恢复时会从开头重新执行。 中断之前的外部副作用应避免或具备幂等保护。interrupt() 通过特殊控制异常暂停图,不能用笼统的 except Exception 把它当普通错误吞掉。审批应绑定具体草稿、金额和版本,例如把 150 的补偿方案改为 100 后,需要记录新方案及其批准依据。
静态断点 interrupt_before=["send_reply"] 与动态 interrupt() 不同:前者在已知节点边界停下,可在核对状态后用 invoke(None, config) 继续;后者需要 Command(resume=...) 提供中断表达式的返回值。不能把“传入 None”当成所有人工审批恢复的通用方法。
持久化
Checkpointer保存按 thread_id 组织的状态历史和执行位置。相同 ID 表示同一任务历史,新的 ID 表示另一条任务;它是定位状态的键,访问权限仍由应用确认。
InMemorySaver 用于进程内演示,重启后状态丢失。SQLite 适合本地持久化,Redis、PostgreSQL 等后端可按部署需求选择,还要安装对应保存器并完成连接和初始化。异步图应使用支持异步接口的保存器。
安装 langgraph-checkpoint-sqlite 后,可以用以下方式在一次应用调用期间打开保存器。重新建立图对象并连接同一数据库,仍可按原 thread_id 找回任务;长期 HTTP 服务通常在应用生命周期内维护该连接。
1 | from langgraph.checkpoint.sqlite.aio import AsyncSqliteSaver |
这个内部函数假定调用方已经核验任务和审批权限,数据库路径来自部署配置。保存器离开上下文后连接关闭,所以不能把内部 graph 返回给其他请求继续使用。服务重启后的恢复还需保持兼容的节点名称和状态 Schema。
检查点通常在 super-step 边界保存,保存器还可能记录已完成节点的中间写入。一个 super-step 可以包含多个并行节点,不能简单理解为每执行一行代码就立即安全落盘。暂停让本次执行返回,不需要长期占用正在运行的任务;运行服务、连接池和保存器仍然存在,不能理解成整个进程内存被释放。
记录需要 Schema 版本、租户归属、访问控制、保留期限及过期清理。持久化后,任务可能在几分钟或几天以后恢复,前提是记录、授权和相关依赖仍有效。检查点不能自动撤销已发送邮件或已提交退款,恢复前还要核对外部动作是否完成。
服务接口
FastAPI 将图包装为 HTTP 服务。Pydantic 检查请求字段,服务为新任务生成独立 ID,通过 ainvoke 运行,并区分草稿完成与等待人工处理。
1 | from uuid import uuid4 |
sender_email 的长度约束不是邮箱格式验证,真实接口还要验证地址并从认证或邮件系统确认来源。恢复入口须校验任务归属、审批身份和当前等待状态,再调用恢复函数;知道 thread_id 不能获得访问许可。
在应用入口创建模型、知识库与工单适配器,构造和编译图,再赋值 app = create_http_app(compiled_graph)。模型和保存器可在服务生命周期内复用,长期连接在关闭时释放。同步阻塞操作不会因为写在 async def 中就自动变成异步,应使用异步客户端或合适的线程执行方式。
1 | ollama pull qwen2.5 |
若 Ollama 应用已经运行,通常不需要再次启动同一端口的服务。以下请求用于检查本地任务接口;实际运行前需把依赖适配器接好。
1 | curl -X POST 'http://127.0.0.1:8000/query' \ |
返回 HTTP 200 只说明接口完成响应,还应检查分类、证据、草稿和任务状态。至少覆盖模型不可用、空检索、MCP 超时、未知分类、两封邮件独立运行,以及批准、拒绝与重启恢复等情况。
异常策略
图执行错误可以按处理方式分为四类:
| 类型 | 示例 | 处理 |
|---|---|---|
| 瞬态错误 | 限流、短暂网络故障 | 限次退避,检查幂等 |
| 可修正错误 | 参数或结构错误 | 反馈字段,有限修订 |
| 缺少输入 | 目标或业务信息不足 | 等待补充或澄清 |
| 未预期或不可恢复错误 | 程序缺陷、权限拒绝、系统配置缺失 | 停止,向调用方或维护人员报告 |
错误要进入任务状态与观测记录,不能变成普通成功字符串。节点超时、图步数与总成本分别限制,不能只设置一个递归上限。
四类错误分别对应系统重试、模型修订、人工补充与向上抛出。网络故障可以采用限次指数退避,但参数错误反复发送同一请求通常无效;未知程序异常需要保留堆栈和 Trace,由维护者排查。工具错误仅在可以合法修正时交回模型,权限拒绝不能靠变换参数绕过。
重试还需识别动作是否已经发生。查询通常较容易重试,创建工单或发送邮件需要幂等键和结果核查。缓存适合带有效期的读取结果,不适合把“已经发信”当成下一封邮件的缓存结果。
低代码编排
n8n把事件触发、数据转换、模型调用和工具连接组织成可视化 Workflow。业务人员或开发者在画布上连接节点,配置端点、表达式、模型和凭证,再由运行平台执行流程。画布省去了部分编排代码,数据契约、权限和失败处理仍需设计。
Workflow 描述可复用流程,Execution表示一次具体运行。Schedule、Webhook 或 Chat Trigger 可以发起执行;Manual Execute 用于测试。节点之间传递 item 列表,常见形态为 [{json: {...}}],表达式 {{ $json.field }} 读取当前 item 的字段。
| 部件 | 作用 | 连接方式 |
|---|---|---|
| Schedule / Webhook / Chat Trigger | 定时或接收外部输入 | 主工作流入口 |
| Edit Fields(Set) | 提取和重命名字段 | 主数据流 |
| AI Agent | 选择工具、读取结果并继续处理 | 主工作流节点 |
| Chat Model | 提供模型推理与生成 | Agent 的 Model 子连接 |
| Memory | 按会话键管理聊天历史 | Agent 的 Memory 子连接 |
| MCP / HTTP / Vector Store Tool | 提供工具能力 | Agent 的 Tool 子连接 |
| Respond to Webhook | 完成本次 HTTP 响应 | 主数据流的响应位置 |
Model、Memory 和 Tool 子节点通常不表示依次执行的三个业务步骤。Agent 运行期间按需调用它们,工作流画布上的一个 Agent 节点内部可以包含多个模型与工具回合。普通数据流上的 HTTP Request 则按编排关系执行,与模型自主选择的工具调用不同。
Workflow 可以导出与导入 JSON,记录节点、连接和配置。导入后还要重新确认凭证引用、节点版本、依赖和网络地址。JSON 可能包含凭证名称、ID 或手写 Header,分享前应检查其中的实际字段。
部署与网络
n8n 可以通过 npm/npx 本地运行,或使用 Docker 镜像部署。常见本地端口为 5678;工作流、凭证和实例配置需要持久化,不能只保存容器镜像。
1 | npx n8n |
长期部署可以挂载 n8n 数据目录并使用 PostgreSQL 等数据库,还需保留加密密钥、配置账户和备份策略。数据库与凭证密钥是不同资产:只有数据库备份而没有对应密钥,可能无法解密原凭证。桌面封装和早期 Basic Auth 环境变量属于特定版本方案,应依据已安装版本确认,不作为通用部署步骤。
以下 Compose 片段用于本地运行,挂载 /home/node/.n8n 保存实例数据。通过 .env 设置 N8N_IMAGE 为选定并固定的镜像标签,设置 N8N_ENCRYPTION_KEY 为稳定的实例密钥。它未配置外部 PostgreSQL、队列或公网反向代理,这些部署能力应分别补齐。
1 | services: |
容器内部的 localhost 与 127.0.0.1 指向容器自身。n8n 在 Docker 中运行,而 Ollama 或 MCP Server 在宿主机运行时,应使用可达的宿主地址。
| n8n 所在位置 | 目标位置 | 示例地址 |
|---|---|---|
| 宿主机进程 | 同一宿主机的 Ollama | http://127.0.0.1:11434 |
| Docker Desktop 容器 | 宿主机的 Ollama | http://host.docker.internal:11434 |
| Docker Desktop 容器 | 宿主机的 MCP 服务 | http://host.docker.internal:8000,再补充实际 MCP 路径 |
| 同一 Compose 网络 | 名为 agent-api 的服务 |
http://agent-api:8000/query |
| 容器或宿主机 | 另一台服务器 | 可解析域名或服务器地址与服务端口 |
host.docker.internal 是宿主地址的名称,不是容器自身的 IP。Docker Desktop 通常提供该名称;Linux Docker Engine 可能需要通过 host-gateway 显式添加映射。Compose 服务之间使用容器内的服务端口,宿主发布端口则用于宿主或外部访问。
地址正确还需要服务实际监听可达接口、端口允许连接,并使用相应协议。Ollama 默认端口为 11434,必要时按运行方式调整 OLLAMA_HOST;FastAPI 位于另一容器时也要监听可达接口。改为更宽的监听地址后,应把访问限制在所需网络或受控代理内。检查连接时要从 n8n 所在网络环境发起,宿主浏览器能连接不代表容器能连接。
Webhook 提供 Test URL 与 Production URL。Test URL 在测试监听期间用于观察数据;Production URL 对应发布后的工作流,部分版本使用 Active 开关。编辑配置后应确认生产运行使用的是已发布版本。WEBHOOK_URL 用于修正反向代理后的公开回调地址,不会自动建立 DNS、TLS 或网络隧道。
部署在本地只能确定某些组件的位置,外部模型、搜索、MCP 和通知仍可能访问公网。是否离线以及数据处理范围需要沿工作流逐项确认。
图书查询
电子书店的小助手需要回答“当前有哪些书”“有哪些编程类书籍”。这类问题应读取书店数据,再由模型解释或推荐。模型训练中知道的书名不能替代当前库存。
基本链路为:
1 | 浏览器 POST |
Webhook 设置为 POST,路径例如 book-search,响应方式选择 Using 'Respond to Webhook' Node。客户端的方法与路径必须匹配;测试时使用节点显示的 Test URL,发布后使用 Production URL。
为了明确数据流,可以约定以下请求正文。session_id 是应用定义的会话字段,实际系统应由受信会话层生成或核验。
1 | { |
Webhook 输出通常把请求正文放在 body 中。Edit Fields 将外部接口格式转换为 Agent 的内部格式,只保留后续需要的字段。
| 节点配置 | 表达式或值 | 作用 |
|---|---|---|
Edit Fields 的 message |
{{ $json.body.question }} |
提取问题 |
Edit Fields 的 session_id |
{{ $json.body.session_id }} |
传递已核验的会话键 |
| AI Agent 的用户消息 | {{ $json.message }} |
提交规范化输入 |
| Memory 的 Session Key | {{ $json.session_id }} |
找到对应历史 |
Respond 的 JSON answer |
{{ $json.output }} |
将 Agent 结果映射为对外字段 |
若 Chat Trigger 自动提供 sessionId,可以直接沿用该字段。自定义 Webhook 不会凭空产生聊天会话 ID,需要明确把 ID 带入并一致传递。字段名是契约的一部分,sessionId、session_id 和 message 不能随意混用。
图书 MCP Tool 提供查询能力,Ollama Chat Model 提供模型,Memory 保存必要聊天上下文。Agent 第一次模型调用可以得到图书查询请求,执行器调用 MCP,再把书目返回给模型生成最终回答。推荐任务可能还需要筛选或再次查询,模型调用次数不固定。
图书服务可以分别使用数据库和 JSON 测试数据。演示的数据库版本在 8000 端口,JSON 版本在 8001 端口,二者还包含不同数量的书目。切换服务后,应核对地址、工具 Schema、数据集和已发布工作流。返回数量改变首先要检查数据来源,不能直接判断为模型漏答。
JSON 测试数据在一次演示中可能更快,整体耗时仍由模型、网络、数据库连接、查询和返回数据共同决定。不同数据量与工具回合数也会影响时间,比较时需要分开记录各段耗时。
前端按 JSON 契约解析响应,不把整个响应字符串或未经检查的 HTML 直接放入页面。
1 | async function sendBookQuestion(question, conversationId, outputElement) { |
这个相对地址假定站点或代理将 /webhook/book-search 转到 n8n;若前端与 n8n 位于不同源,需要使用实际地址,并配置认证与 CORS。前端示例实现调用接口,模型和工具的内部回合由 Agent 执行器管理。
会话隔离
Memory 应按会话组织,避免把不同用户的历史混在一起。类似购物车按用户或会话区分,聊天记忆也必须有稳定的归属:用户 A 问历史类书籍,用户 B 问音乐类书籍,后续“推荐第二本”必须引用各自的上下文。
用户 ID、会话 ID、Execution ID 和任务 ID具有不同用途。用户可以拥有多个会话,同一会话包含多次请求与 Execution;长期任务的 thread_id 还可能跨多次恢复。两个浏览器是否属于不同会话取决于应用的 ID 和认证设计,不能仅由窗口数量判断。
同一会话每次发送新消息时应复用原 Session Key,创建新聊天时再分配新键。固定共享键会混入其他人的历史,每条消息重新生成键则会丢失多轮联系。多租户系统可以使用租户、用户和会话的组合键,并由服务检查归属。
Simple Memory 的上下文窗口限制保留的近期交互,不能替代任务状态持久化。队列模式下请求可能进入不同 Worker,进程内记忆不适合用来维持可靠会话,应选择能够共享访问的存储。AI 子节点处理多 item 时,表达式还可能只读取第一项;批量会话应分离执行或明确逐项处理,避免复用第一个会话键。
定时分析
定时工作流可以主动获取数据并推送结果,不需要用户每次提交问题。以 Bitcoin 市场信息分析演示为例,Schedule Trigger 每五分钟发起一次运行,任务要求直接写在节点配置中;手动执行一次则用于调试,不需要等待下一次定时。
这个示例包含三个职责:技术数据分析读取价格与成交数据,市场情绪分析检索相关新闻,策略汇总综合两份报告给出解释。策略输出的 BUY、SELL、HOLD 是演示中的信号类别,流程并未因此完成交易。
1 | Schedule Trigger |
定时器只有时间和运行信息,没有自然语言问题,因此 Prompt 应明确数据来源、任务范围、输出字段和失败方式。技术分支可以调用封装市场数据的 HTTP 或 MCP 工具,情绪分支可以使用搜索服务。HTTP 工具、搜索节点和 MCP Client 都可能提供查询能力,但只有通过 MCP 协议接入的服务才属于 MCP。定时任务还要配置实例或工作流时区;修改定时规则后确认已发布版本,并处理上一轮尚未结束时下一轮又到达的重叠执行。
技术分支例如从 Binance 的公开市场数据接口取得价格、成交量或 K 线,新闻分支可以使用 SerpApi 这类第三方搜索结果 API 查询 Google 等搜索引擎的相关结果。工具描述需要明确数据来源与查询用途,执行层还要校验返回状态、时间和字段。工作流“每五分钟执行一次”与行情接口中“一根 K 线覆盖五分钟”是两个配置,不能把触发频率直接当成所分析的完整时间范围。
技术 Agent 的要求可以是“读取工具返回的价格与成交数据,说明时间范围和数据缺失,输出技术分析”;情绪 Agent 的要求可以是“检索相关报道,给出依据及 -5 到 5 的情绪评分”。这个评分属于自定义量表,应定义负面、中性、正面区间和证据规则,不能当成概率、客观市场指标或经过校准的预测。
技术和情绪两条分支分别配置模型和工具,输出重命名为 tech_result 与 sentiment_report。不同模型可以承担不同职责,也可以全部使用本地 Qwen2.5。System Prompt 可以明确任务,但不会把模型物理切换到只计算某个领域的子网络,也不能单凭角色说明保证更快或更准确。
查询价格失败时,需要把错误和缺失状态带到汇总节点。演示即使产生了 HOLD,也只说明输出流程运行,不能证明缺失价格后仍得到有效策略。后续处理应区分“依据完整后的保持信号”和“输入不足、无法分析”。
分支汇合
两份分析必须汇合后才能进入策略节点。直接把两个分支连到同一普通节点,并不自动建立“等待全部输入并组合”的语义;可能分别执行下游,得到只有一份资料的两次分析。
Merge既处理汇合时机,也决定数据形态。Append 保留多个输入 item,Combine 按位置或字段把输入合并到同一个 item。若每条分支每次运行只有一项,可按 Position 合并;若每条分支有多项,应以 run_id、标的或其他业务键匹配。不能认为添加 Merge 后总会得到一个同时包含两份报告的 JSON 对象。
例如两个分支分别产生如下字段,合并后策略节点应看到同一 run_id 下的两份内容:
1 | { |
这是用于解释契约的数据示例。分支失败时仍可输出明确的错误 item,使汇总逻辑识别缺失;若某一路直接没有输出,Merge 的等待和匹配结果会不同。字段同名时也要规定冲突处理,避免一份 output 覆盖另一份 output。
画布上两个分支并列不代表实际并发。n8n 的执行顺序受工作流版本与设置影响,新版执行顺序通常完成一个分支后再运行另一个。Merge 建立输入汇合,不能自动保证两条外部请求同时执行。性能分析需要查看 Execution 的节点时间,并区分并行设计与实际调度。
信号输出
策略汇总节点读取合并后的技术与情绪报告,生成可解释文本。若不需要新工具,只进行一次输入到输出的转换,可以使用 Basic LLM Chain;某些旧版演示将它画成未连接工具的 Agent,实际配置时需确认节点版本要求。
演示还把报告交给额外的 LLM Chain 提取信号,返回 {"signal": "HOLD"}。它是输出转换步骤,不是完成新环境观察的 Agent。额外模型调用可能增加延迟和不一致,可以让汇总阶段同时输出报告与结构化信号,再由程序校验。
1 | from typing import Literal |
输入是否充分应由查询状态、数据时间范围和程序规则先检查,不能只让模型自己声明 ready。结构校验保证允许值和字段关系,分析依据仍需核对。输出提取阶段也不应重新改变策略;无法解析时返回格式错误或有限重试,不凭关键词随意猜测信号。
消息推送
定时分析的浏览器客户端先建立 WebSocket 连接,随后接收后台结果。n8n 中 HTTP Request 的 POST 和浏览器 WebSocket 接收属于两个通信阶段。
1 | n8n HTTP Request |
HTTP POST 的地址必须包含推送服务实际配置的路径,不能只知道端口就认为能发送。该服务接收后再广播或按会话定向发送;n8n 的普通 HTTP Request 节点不会直接把 POST 变成浏览器的 WebSocket 消息。
客户端不必为每个结果轮询,仍需完成初始连接、身份验证、断线重连和历史补取。文本报告与结构化信号分两路发送时,到达顺序可能不同,可以使用事件类型、run_id 与时间戳关联。
1 | { |
HTTP 接受事件、WebSocket 发送成功、客户端收到和页面显示,是不同确认阶段。实际系统需要按客户端归属分发,记录事件 ID 以处理重复消息;一个运行失败也应能在前端展示明确状态。
职责划分
同一任务可以由三个、两个或一个 Agent 完成。三个 Agent 分别负责技术、情绪和策略;两个 Agent 可以把数据与新闻分析合在一起,再由另一个汇总;一个 Agent 可以拥有两个工具,自行取得信息并完成分析。
| 组织方式 | 优点 | 需要承担的代价 |
|---|---|---|
| 多个专门 Agent | 职责清楚,可分别配置模型、Prompt 和工具;失败容易定位 | 增加节点与结果契约,可能重复传递上下文 |
| 一个 Agent 组合工具 | 编排较少,可以结合全部反馈统一决策 | Prompt 和工具选择更复杂,单处失败可能影响整个任务 |
| 固定流程与模型节点组合 | 数据获取与路由可明确控制,输出容易验证 | 动态调整路线的能力需要另外设计 |
职责单一有助于模块化和复用,但拆分数量不自动决定成本或质量。三个 Agent 的调用次数要按各自模型回合、工具轮次和重试累计;一个 Agent 查询两个工具时也可能多次回到模型。应比较真实 Token、延迟、准确率、失败恢复与维护成本。
使用多个 Agent 时,技术与情绪两份报告应带上证据、时间与状态,不能只交付难以验证的结论字符串。没有额外工具的策略汇总可以是普通模型节点,确定性字段校验可以直接由程序完成,不需要为每个步骤再增加一个 Agent。
工作流接入
n8n 可以通过 MCP Client Tool 发现外部工具,再把允许的子集挂到 Agent。它与 MCP Server Trigger 的方向不同:Client 调外部能力,Server Trigger 向外部暴露 n8n 能力。实际传输支持取决于节点和版本,不能因为 MCP 总体支持 stdio,就假定所用 n8n 节点也接受本地进程;网络服务应配置它实际支持的端点、协议与认证。
Vector Store 可以封装成 Agent 按需查询的工具,也可通过 Retriever 在模型调用前取得上下文。前一种需要检查 Agent 是否真的检索,后一种由固定流程保证执行。Document Loader、Text Splitter、Embedding 和向量数据库仍是知识入库的组成部分;索引时与查询时的 Embedding 应兼容。Vector Memory 保存经历或聊天内容,与可信业务知识库有不同更新规则。
HTTP Tool 参数可以用 $fromAI() 描述需要由模型提供的值,例如:
1 | {{ $fromAI('issue_id', '需要查询的工单编号', 'string') }} |
这个表达式把参数要求提供给模型,不是可信身份来源。租户、认证凭证、允许的服务地址和关键权限应由系统固定或验证。凭证在执行层托管,避免直接拼入 Prompt;工具返回的数据也需要检查,不能假定绝不会回传敏感内容。
n8n 还可以代理独立 LangGraph 服务,链路为 Webhook → HTTP Request → Code → Respond。HTTP 节点以约定 JSON 调用后端 /query,Code 节点将内部字段转换为外部契约,例如 draft 转为 reply,并保留 task_id 与真实 status。不能无论后端返回等待审批还是错误都统一写成 success。长任务宜先返回受理状态,再通过任务查询或回调取得结果。
以下 Code 节点片段采用 Run Once for All Items,处理本例的一项后端响应。批量任务应逐项转换,不能只取第一项。
1 | // 校验后端状态,将草稿接口转换为对外的回复契约。 |
If 根据条件进入 True / False 分支,Switch 按多个分类分派,与代码中的条件边承担类似作用。NASA DONKI 的太阳耀斑数据演示可以先拉取 FLR 记录,检查时间和 classType,再把符合示例规则的记录 POST 到 PostBin 或通知节点。实际 classType 可能是 X1.0 等值,应解析等级或判断 X 前缀;额外强度字段只有在数据确实提供或由程序明确计算时才能使用。PostBin 用于检查请求接收内容,真实告警仍需要业务阈值、去重和授权范围。
综合流程可以同时挂载 Jira MCP、Qdrant 知识检索与 LangGraph HTTP 服务:先接收 504 故障问题,取得 SOP 和实时工单,调用后端处理,再整理结果返回。每个步骤应有清楚的输入、证据与状态,覆盖认证失败、空检索、工具超时和模型不可用等分支。
Spring 编排
Spring AI 适合已有 Java 业务需要模型与工具接入的场景。Advisor 在调用前后加入检索、记忆和观测,业务状态机则管理明确状态与转移;拦截链本身不自动等同于任意状态图。
MCP Client 把远程工具适配成回调,VectorStore 与 RAG Advisor 提供知识,托管 Bean 实现业务能力。具体注册与自动装配行为需要匹配框架版本。
Advisor 可以在请求前读取记忆、检索文档和调整上下文,在返回后记录用量、验证格式或处理结果。它按明确顺序形成拦截链,和传统 AOP 有相近设计思想,但使用自己的调用接口。早期材料中的 AroundAdvisor 与新版 CallAdvisor、StreamAdvisor 接口存在版本差异,不应混用构造方法。
MessageChatMemoryAdvisor 处理按 conversation ID 组织的历史,QuestionAnswerAdvisor 从已经入库的 VectorStore 查询文档并加入上下文。PGVector、Qdrant、Milvus 或 Pinecone 可以承担存储角色,检索阈值、Top-K 和租户过滤仍需配置。检索到 SOP 只能帮助建立事实依据,不能保证消除所有幻觉。
Spring MCP Client 负责握手、发现工具与调用,ToolCallbackProvider 把远端工具转为可注册的回调。stdio、SSE 和 Streamable HTTP 要按实际依赖和服务器选择;工具通常需要通过 ChatClient 或工具管理配置显式注册,不能认为任意 Function Bean 都会自动对所有模型公开。
下面的配置片段展示记忆与 RAG Advisor 的组合,所需 ChatModel、ChatMemory 和 VectorStore 由应用提供并完成初始化。
1 |
|
请求时再传入经应用核验的会话 ID 和本次允许的工具。下面采用 Spring AI 2.x 的 .tools(...) 形式,readOnlyMcpTools 是应用限制过范围的 ToolCallbackProvider,userText 与 conversationId 来自当前请求。
1 | // 根据认证会话选择历史和工具范围,再执行模型与工具循环。 |
MCP 工具可以来自 Python、Java 或 Node 服务,协议适配不要求它们使用相同实现语言。例如先从 GitHub 读取 PR diff,确认缺陷后再提出 Jira 工单创建请求;只读检查和创建动作应分别授权。连接端点、认证信息与工具发现由客户端处理,凭证不作为模型参数传递。
Java 状态机可以表达 INIT → 查询 → 草拟 → 审批 → 执行 → DONE。转换的 Guard 检查当前身份、任务状态、审批和版本,Action 完成具体业务操作。模型可提出候选事件,状态机与业务服务仍要检查是否允许转移。Guard 不自动为每个 Action 建立事务,也不能单凭使用状态机推导出完全不存在越权风险。
1 |
|
这些业务类型由项目定义,注解需要授权和事务配置以及正确代理入口。远程 API 不自动进入同一本地事务,业务身份也应来自认证层,不能直接使用模型生成的 role 或 userId 授权。
@Transactional 的范围是受配置事务管理器控制的一次业务调用,并非 Agent 的整条推理链。默认回滚规则与异常类型有关,受检异常需要按策略配置;同类方法内部调用等绕过代理的情况也要检查。数据库事务提交以后,再发生模型异常,不会自动撤销已提交的数据。
@PreAuthorize 检查真实业务入口的权限,异步或跨服务调用需要显式传播并核验身份上下文。注解存在不意味着每条调用路径都会通过它;工具适配器应调用容器托管的服务实例。JPA / MyBatis、连接池和既有 DAO 可以复用,外部副作用则需要幂等、Outbox 或补偿策略。
例如退款工具可先读取订单与已退款记录,核验操作者和订单版本,再执行受控事务。没有权限时返回业务拒绝;事务内更新失败则按配置回滚。模型的“退款成功”文本不能代替数据库结果和退款凭证。Actuator / OpenTelemetry 可以协助记录调用链,但具体工具参数、结果和审计事件仍需应用正确配置与埋点。
异构系统
n8n、Spring AI 与 LangGraph 可以按职责组合:n8n 负责事件与接入,Spring 提供业务服务,LangGraph 负责复杂状态编排。任务简单时也可减少组件,避免维护多个互相矛盾的状态源。
跨层接口应明确任务、租户、Trace、输入版本、结果与错误。工单流程可以先分类并检索资料,再查询历史,生成待执行动作,审核后调用受控业务服务。
一条完整工单链可以这样展开:n8n 接收 Slack 或 Webhook 请求,Spring 确认身份和资源权限,LangGraph 根据任务检索 SOP、查询 Jira 或 CRM,并形成候选处理方案。Python 返回结构化动作,Java 在业务边界重新核验并执行事务,最后由 n8n 整理响应和通知。Java 的 .entity(TicketResponse.class) 等结构化转换有助于形成 DTO,字段语义与授权仍由业务校验。
以重复扣费请求为例,读取账单属于查询,生成退款建议属于规划,主管批准属于授权,调用退款服务才会产生实际写入。涉及演示中的 500 金额门槛时,应把金额、订单、规则和审批版本放入受信契约;阈值由业务策略定义,不由模型任意改写。
这套分层也可用于电子书店:前端只发送问题,Java 后端复用既有服务和鉴权,通过 Spring AI 组织模型、RAG 和工具调用。代码包方式把控制逻辑纳入应用项目,n8n 则作为独立平台保存并执行工作流。两者在运行和维护上的差异需要纳入架构选择。

异步审批回调需要验证身份、签名、有效期、参数版本和重放。中断保存到检查点,批准后恢复同一任务;执行节点用幂等标识防止重复副作用。
例如等待审批时,状态图返回待审核事件,n8n 生成交互卡片;审批按钮触发新的 Webhook,业务服务验证事件及任务归属后,才使用原 thread_id 恢复。若记录存于持久化保存器,即使等待跨越服务重启,仍可读取相应任务。批准文本或金额发生变化时,应更新方案并重新核验,拒绝时则进入拒绝或人工处理分支。
架构选择
LangGraph 适合需要显式状态、循环与恢复的 Python 流程;Spring AI 适合与 Java 业务设施整合;n8n 适合事件触发与可视化编排。选择应依据既有技术栈、控制流复杂度、运维和测试要求。
Agent 质量评估要分别观察分类、检索、计划、工具、恢复和最终业务结果。固定测试与线上 Trace 能帮助判断失败发生在哪一层,并检查模型或规则更新是否引入退化。
可以把本章的设计要求归纳为九项检查:
| 要求 | 具体落实 |
|---|---|
| 推理与执行分离 | 模型提出决策,Host 调用工具,业务服务验证写操作 |
| 节点职责明确 | 分开 LLM、Data、Action 与 User Input |
| 状态保存原始数据 | 保存输入、证据和结果,按需组织 Prompt |
| 循环能够终止 | 配置 END、次数、时间、预算与无进展出口 |
| 错误分类处理 | 分别采用重试、修订、人工输入或向上报告 |
| 状态可恢复 | 使用任务 ID 和合适的持久化检查点 |
| 接口责任清楚 | 区分 MCP 协议、RAG 检索、Skill 规则与实际 Tool |
| 组件按需组合 | 明确 n8n、Java 服务与 Python 图的职责和契约 |
| 写操作受业务约束 | 在真实权限、事务、版本和幂等边界内执行 |
这些要求有助于控制风险,并不能单独保证零故障。平台或代码都可以用于生产,选择取决于所需控制力、团队技术栈、部署条件、运行成本和可测试性。代码实现允许自定义节点与预算,也需要自己维护这些控制;可视化平台则提供较多现成连接和运行记录。
当系统进一步涉及死循环检测、历史检查点分支、Supervisor / 多 Agent 协作以及沙箱评测时,需要继续设计 Harness 与控制流治理。历史状态回放也不能自动回滚外部系统;测试必须观察真实动作或受控模拟环境中的业务结果。
自主决策需要受控能力、明确状态和持续验证。可恢复的 Agent 应知道已经做了什么、还差什么,以及为什么继续或停止。