
计算机系统工程-08:事务机制
事务范围
事务(transaction,简称 TX)把需要共同处理的一组数据操作联系起来。数据可以是数据库中的账户、键值存储中的记录,也可以是目录项、inode 或共享内存中的对象。
程序用 begin 标记开始,用 commit 请求提交。系统据此知道哪些读取需要共同解释、哪些修改需要共同生效。一次服务请求还可能包含参数解析、网络传输和响应生成,事务边界应覆盖业务依赖的数据操作。
购物程序可能先检查 item.count>0,再扣减数量并把商品加入购物车或订单。检查与扣减分开执行时,其他请求也可能读到同一份库存;扣减成功但订单没有建立时,业务也缺少完整结果。事务用于协调这些相关动作。库存仅减少 1,还要与需要建立的订单数量相符;金额、商品和用户身份等条件由业务继续检查。
图中是经过遮挡处理的公开讨论,反映用户对金融服务和账户显示的关注。单凭截图无法判断故障原因。账户系统需要依据可靠交易记录核对结果,让扣款、入账与交易身份保持对应,并处理失败、重试和恢复。
思考题:金融应用为什么经常用事务组织转账?只让每次余额写入都完整执行,足够吗?
解答:
一笔转账同时涉及扣款、入账和交易记录,需要共同生效;多笔请求还要避免读取和覆盖彼此的中间状态。单次写入完整,只保证那一次访问,整笔业务仍可能只完成一部分。事务边界把这些操作交给共同的提交、隔离与恢复规则。
ACID
ACID 概括事务需要提供或共同维护的四类性质:
| 字母 | 名称 | 对应用的含义 |
|---|---|---|
| A | Atomicity,原子性 | 整笔修改完整保留或完整撤销 |
| C | Consistency,一致性 | 正确事务把数据从符合业务约束的状态变到另一个符合约束的状态 |
| I | Isolation,隔离性 | 并发事务按接口规定的规则相互影响;可串行化要求能用某个完整事务顺序解释 |
| D | Durability,持久性 | 已确认提交的结果在规定故障后仍可恢复 |
原子性和持久性的日志、提交点与检查点见故障原子性。提交点之前要能回退,之后要有足够恢复依据完成事务;收到成功确认后,结果需要保留。
业务约束及单笔程序正确性见并发原子性中的业务正确性。数据库可以检查声明的约束,应用仍需正确表达金额、库存和权限等规则。ACID 中的 C 描述这些业务约束;并发一致性讨论的模型则规定读写顺序和可见结果。
本篇重点解释隔离性的三种实现思路:OCC 在执行后验证,HTM 用硬件跟踪内存访问,MVCC 让读取使用历史快照。下面先按无机器故障的内存读写分析,持久化再与日志协议结合。
乐观执行
乐观并发控制(Optimistic Concurrency Control,简称 OCC)让事务先在自己的工作区内计算,提交前检查这些计算依赖的数据是否仍然有效。检查失败就丢弃本次暂存结果,重新读取并计算。
“乐观”表示执行阶段先允许工作继续。提交阶段仍需同步,保证通过检查的结果按规定发布。对读多写少、冲突较少的负载,可以减少计算过程中持锁和等待的时间。Kung 与 Robinson,1981提出了经典 OCC 方法。
一次事务分成三阶段:
| 阶段 | 做什么 | 结果保存在哪里 |
|---|---|---|
| 执行 | 读取数据,运行业务计算,暂存修改 | 事务私有工作区 |
| 验证 | 检查读取版本及相关并发状态 | 验证通过才可继续 |
| 发布 | 将全部暂存修改安装到共享存储 | 形成已确认的新版本 |
这里的“发布”表示修改开始按协议对其他事务可见。需要持久性时,还要在规定时刻完成日志等可靠保存,才能向用户报告相应的成功。
读写集合
事务开始时分配自己的执行上下文,至少包含读集合(read set)和写集合(write set)。
读集合记录本次计算依赖哪些记录、读到它们的哪个版本。写集合记录准备修改哪些记录、最终要写入什么值。例如执行 B=A+B,初始 A=B=100:
| 结构 | 内容 |
|---|---|
| 读集合 | A 的值 100 与版本 vA;B 的值 100 与版本 vB |
| 写集合 | B 的暂存新值 200 |
此时共享 B 仍为 100。其他事务不能直接取走当前事务尚未提交的 200;当前事务再次读取 B,则应取得自己已经暂存的 200,这称为读到自己的写入。
1 | def tx_read(tx, key): |
read_stable_record 表示按记录协议取得相互匹配的数据与版本;ReadEntry 是私有的读取记录。写入自己的暂存值时,验证所需的原版本仍应保留,避免把“计算出的新值”误当成“共享存储原来就有的值”。
稳定读取
一个数据值和它的版本号也可能分开读取。例如先读到旧 A=100,再遇到其他事务提交 A=110,最后才读到新版本 v2。如果把 100,v2 作为同一份读取记录,后续验证就会依据错误的对应关系。
因此,记录读取需要保证内容、版本和并发状态相互匹配。常见思路是先读元信息,复制内容,再检查一次元信息;记录被其他写入者锁住或版本发生变化时,重新读取。也可以使用其他能取得稳定记录的接口。
1 | # 概念流程;元信息访问和内容复制需符合语言、硬件的同步规则。 |
这段代码表达稳定读取的条件。实际多字节对象不能靠普通变量反复读取自动取得正确同步,还需由数据库记录格式、原子元信息和内存顺序提供保证。事务输出等有外部效果的动作应在相应提交决定之后执行,验证失败时才能安全地重新计算。
思考题:为什么“读取数据,再把它记入读集合”需要取得一份稳定记录?
解答:
其他事务可能同时安装新内容。若值来自旧版本、验证标记来自新版本,就会错误地接受基于旧值的计算。读取接口应返回相互对应的值、版本和有效状态,并让原版本保留到提交验证。
提交检查
最简单的 OCC 实现让验证和发布共用一把全局提交锁。事务取得锁后,逐项检查读集合;全部通过,才安装写集合。
1 | def validate_and_commit(tx, store): |
代码使用抽象的记录接口,假定所有写入者都遵守共同提交规则,读取者遵守稳定读取规则。失败时尚未向共享存储安装任何本事务的新值,因此可以丢弃私有集合;离开代码块时释放提交锁。
业务计算仍可由多个事务并发执行。全局锁只覆盖版本验证和修改发布,不覆盖计算的全部过程;短事务的提交工作较少时,这个互斥范围通常也较短。
验证间隔
若验证与发布之间允许另一个提交者插入,两者都可能通过过期的检查。
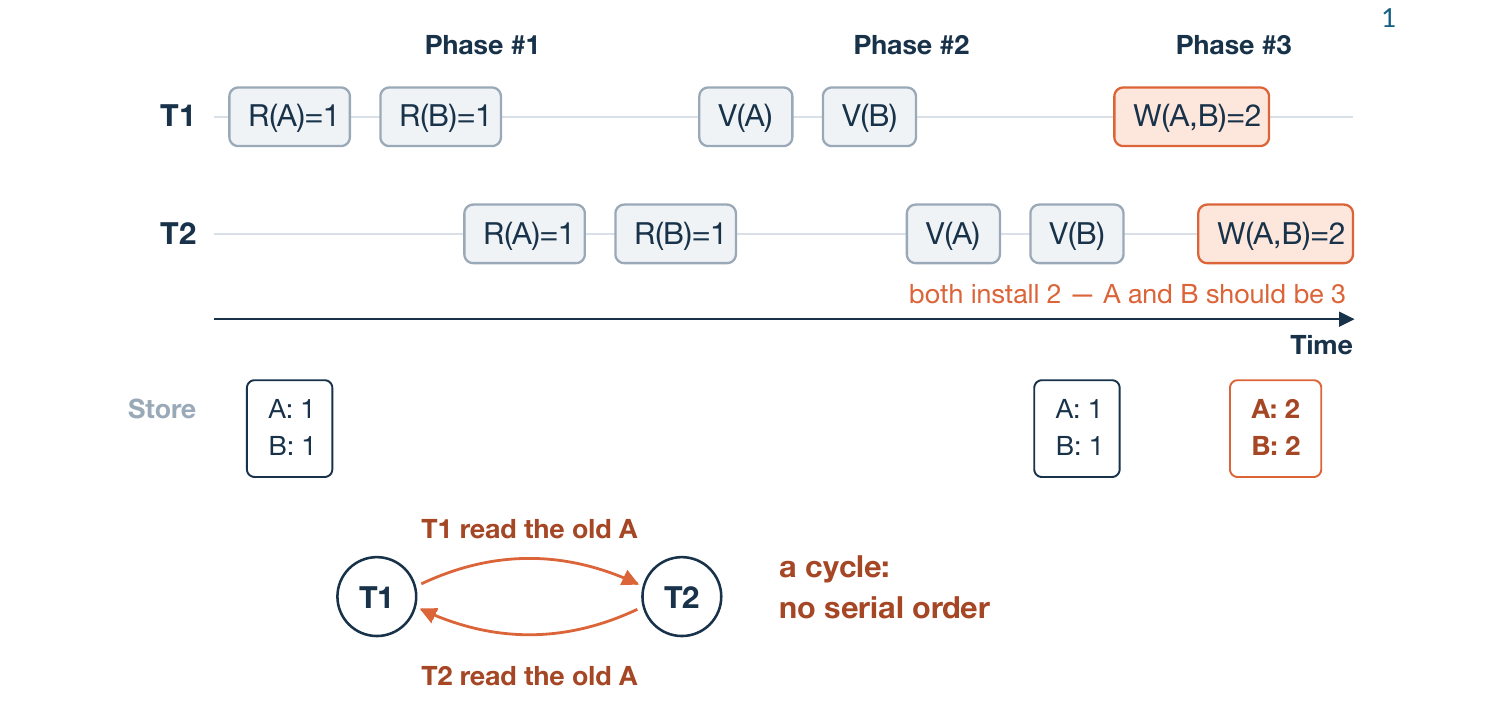
图中 R 为读,V 为验证,W 为写。初始 A=B=1,T1、T2 都要执行 A+=1;B+=1。每笔完整执行一次,两个数最终都应为 3。
例题:两笔事务都先读到 A=B=1,计算出各自的暂存结果 2;随后都在任何发布之前完成验证,再依次发布。最终是多少,问题出在哪里?
解答:
两次验证都看到旧版本,都会通过;随后两次发布都写入 2,最终 A=B=2。一笔计算依赖的旧状态在验证之后已经被另一笔提交改变,但它仍沿用原计算。
验证及其保护下的发布需要共同协调。使用全局提交锁时,一笔事务完成发布后,另一笔才验证;后者会发现版本改变并重试。
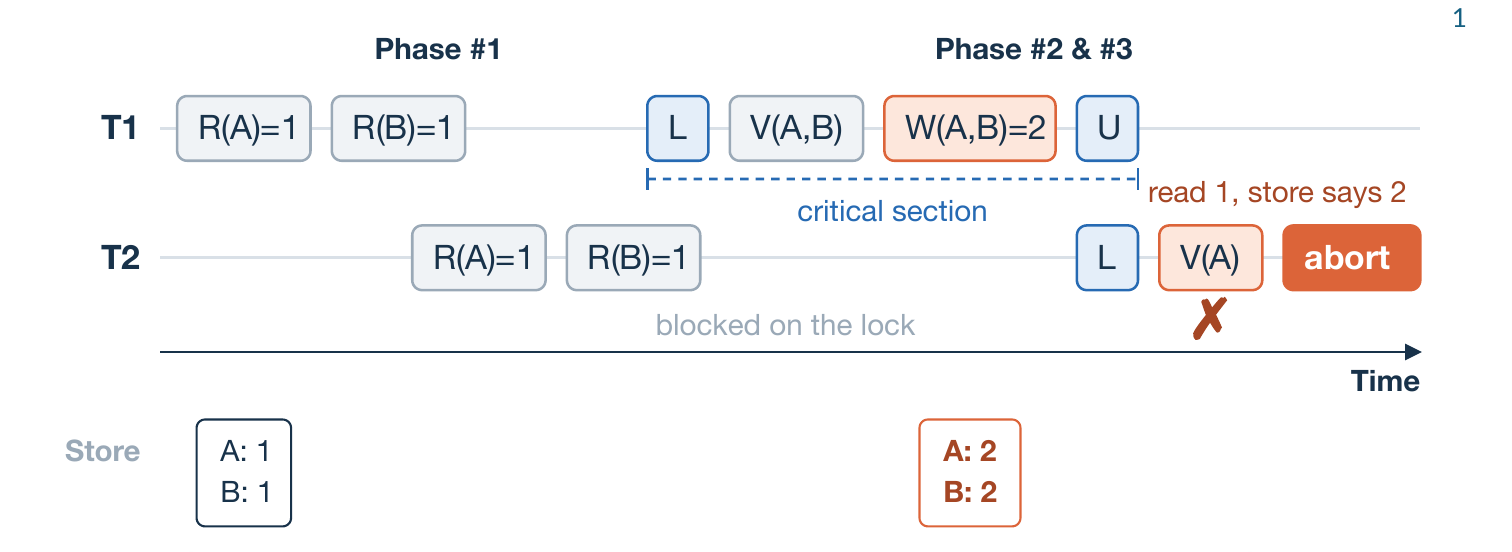
T1 发布后 A、B 为 2。T2 从头重试,重新读到 2、计算 3,再验证和发布。注意重试要重新读取、重新计算,不能只把旧写集合再次提交。
版本变化
验证可以比较“当前值是否仍相同”,也可以比较“当前版本是否仍相同”。两者检查的条件不同。
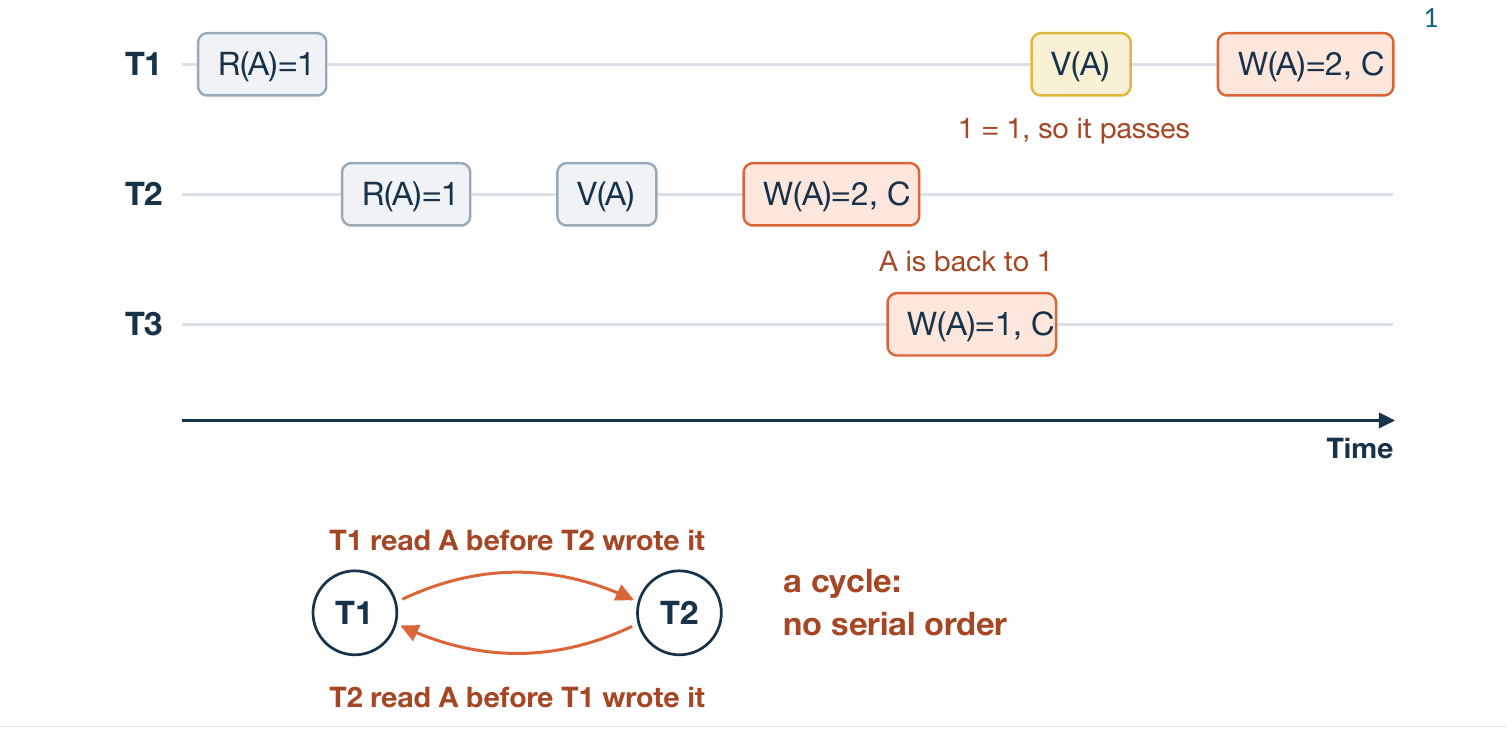
图中 T1、T2 都执行 A+=1,T3 执行 A=1。初始 A=1:
| 顺序 | 动作 | 当前 A | 示例版本 |
|---|---|---|---|
| ① | T1 读取 A | 1 | v0 |
| ② | T2 读到 1,提交新值 2 | 2 | v1 |
| ③ | T3 提交 A=1 | 1 | v2 |
| ④ | T1 进入验证 | 1 | v2 |
这个“原来是 A、变成 B、后来又回到 A”的现象称为 ABA 问题。只比较整数 1,T1 无法发现中间已提交两次修改;比较 v0 与 v2,就能发现它的原版本已过期。版本应在相应更新后推进,并处理编号复用或溢出的规则。
图中的冲突环表示,原先那些读取和写入的依赖不能全部对应同一个串行顺序。若只观察整数结果,这个特定例子仍能按 T2、T3、T1 得到相同数值;版本验证所检查的是“读取之后没有发生过相关已提交修改”这一更具体的条件。数据值相等和同一版本各有明确含义。
思考题:比较原值和比较版本会拒绝完全相同的调度吗?图中 T1 分别会看到什么?
解答:
比较原值时,T1 看到
1=1,会通过;比较版本时,看到v0≠v2,会中止。版本标记保留修改历史,适合实现本节要求原读取保持有效的验证规则。
提交粒度
全局提交锁会让互不访问同一记录的提交也排队。可以改成按记录加锁,在提交时只协调相关记录。
一个直接方案是按统一顺序取得 read_set∪write_set 中全部记录的锁,验证完读集合后,安装写集合,最后释放。集合要去重,固定顺序用来避免循环取锁;基本规则见两阶段锁与死锁。
进一步优化只锁写集合,读集合由版本验证保护。不过,验证还要检查相关记录有没有被其他事务锁住、准备发布。
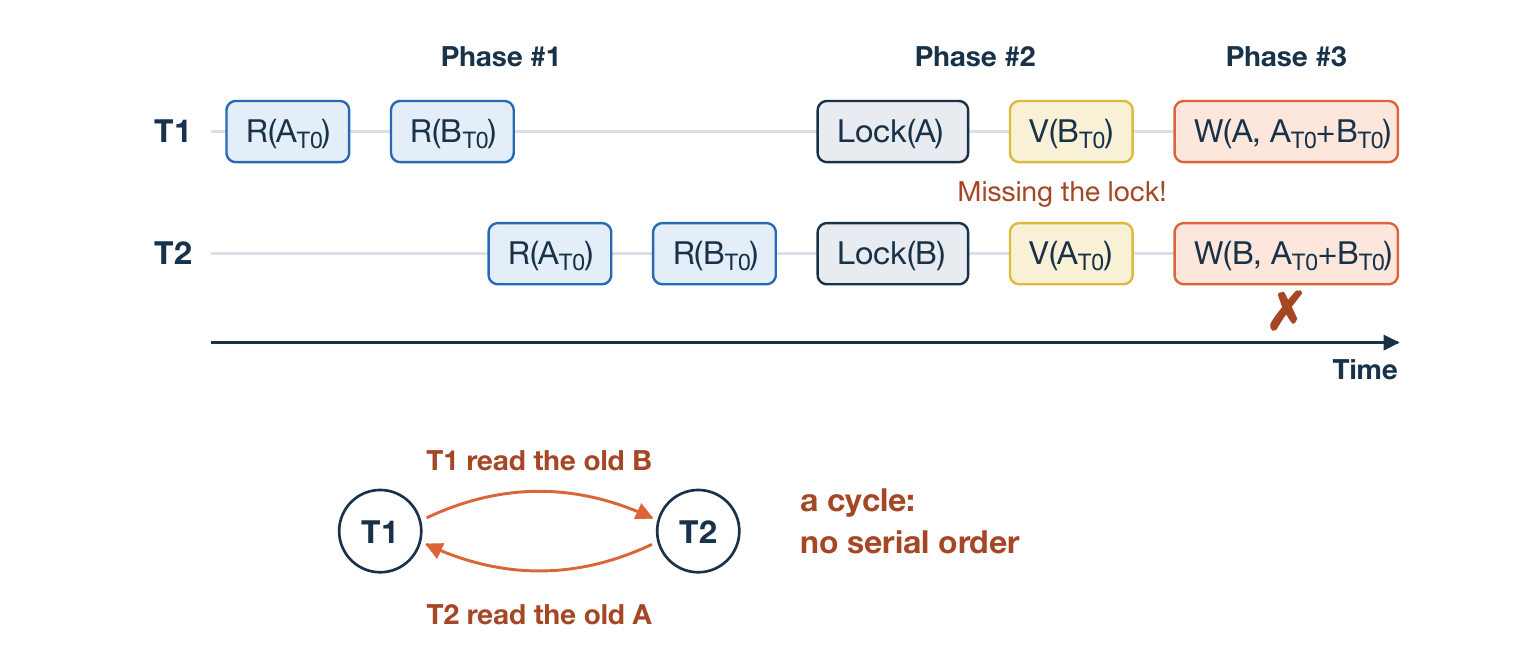
图中 T1 执行 A+=B,T2 执行 B+=A。设初始 A=B=1,两者都先读到 1、1。T1 只锁 A,T2 只锁 B,两个目标锁不同;若仅比较尚未改变的版本,两者都能通过,再分别发布 A=2、B=2。
但先 T1 后 T2 应为 A=2、B=3,先 T2 后 T1 应为 A=3、B=2。2、2 没有相应的串行解释。两个事务都读取了对方即将覆盖的旧数据,形成双向依赖。
思考题:只锁写集合以后,对读集合只检查版本够吗?应该怎样处理已经由其他提交者锁住的记录?
解答:
记录可能尚未改变版本,但另一提交者已经取得它的写锁,即将安装新值。验证应同时检查原版本仍有效,以及记录未被其他事务以冲突方式锁住;遇到冲突时中止或按协议重试。
自己已经持有的写锁需要按所有者识别。既在读集合又在写集合中的记录,由本事务自己的锁保护,验证它原来的版本,不能把自己的锁当成外部冲突。
记录验证
简化后的提交逻辑如下:
1 | # 省略持久化,只说明数据记录的并发提交条件。 |
所有写入者都要遵守记录锁、版本推进和发布规则。验证时读取锁与版本的方式、发布新内容的内存顺序,也属于协议的一部分。上面的步骤用于说明依赖条件;成熟系统还要保护索引、范围查询和新记录插入等访问。
读阶段不长期持有记录锁,因此在本节模型中避免了业务计算过程中持锁等待。不过,若提交时逐把取锁且没有共同顺序,OCC 同样可能发生死锁。成功与失败路径都需要释放已取得的锁。
只读成本
只读取记录时,2PL 通常包含取得相应锁、读取内容、释放锁;取得锁经常需要原子读改写,释放还要修改锁状态。OCC 的低冲突读路径则主要读取内容,在提交时再读取版本和锁状态。
| 路径 | 理想无重试情况下的一次只读访问 |
|---|---|
| 2PL | 取得锁、读内容、释放锁 |
| OCC | 读内容及其版本,随后验证元信息 |
记录采用读锁还是互斥锁、如何复制内容,会改变具体指令数。这张表说明的是同步方式和共享写入量的区别。理解为什么一次取锁可能更贵,需要先看硬件的原子操作。
原子交换
设锁状态 0 表示空闲、1 表示已持有。若取锁被写成“先读取,看到 0 再写 1”,两个线程可以同时读到 0,然后都认为自己成功,锁本身就出现竞态。
比较并交换(compare-and-swap,简称 CAS)把比较与条件修改作为一个原子操作。其含义可以写为:
1 | # 这是硬件操作的语义描述,整个过程须由原子原语保证。 |
用它把 flag 从 0 改为 1 时,只有一个线程能在这次状态变化上成功。其他线程取得的旧值为 1,于是继续等待。CAS 的不同语言接口可能返回布尔成功标记,或把实际值写回 expected,使用时要依据具体接口。
x86 通常用带 LOCK 前缀的内存 CMPXCHG 完成这种跨核心原子读改写;其他体系结构也有相应原语。源代码中写出相同的普通读、比较和赋值,并不会自动取得这些保证。Intel 指令手册
自旋锁
自旋锁在未取得锁时反复尝试。下面使用 C11 原子对象,明确取锁与释放的内存顺序:
1 |
|
compare_exchange_weak 可能要求重试,因此放在循环里;每轮重新设置 expected=0。取锁成功后,线程才访问受保护数据。释放使用原子 store 即可,仍需满足正确的发布顺序。
这个实现便于理解,不包含退避、让出 CPU 或其他优化。临界区很长、持有者被暂停时,忙等会消耗执行资源;选择自旋或阻塞式等待,需要结合持锁时间与调度条件。
同步开销
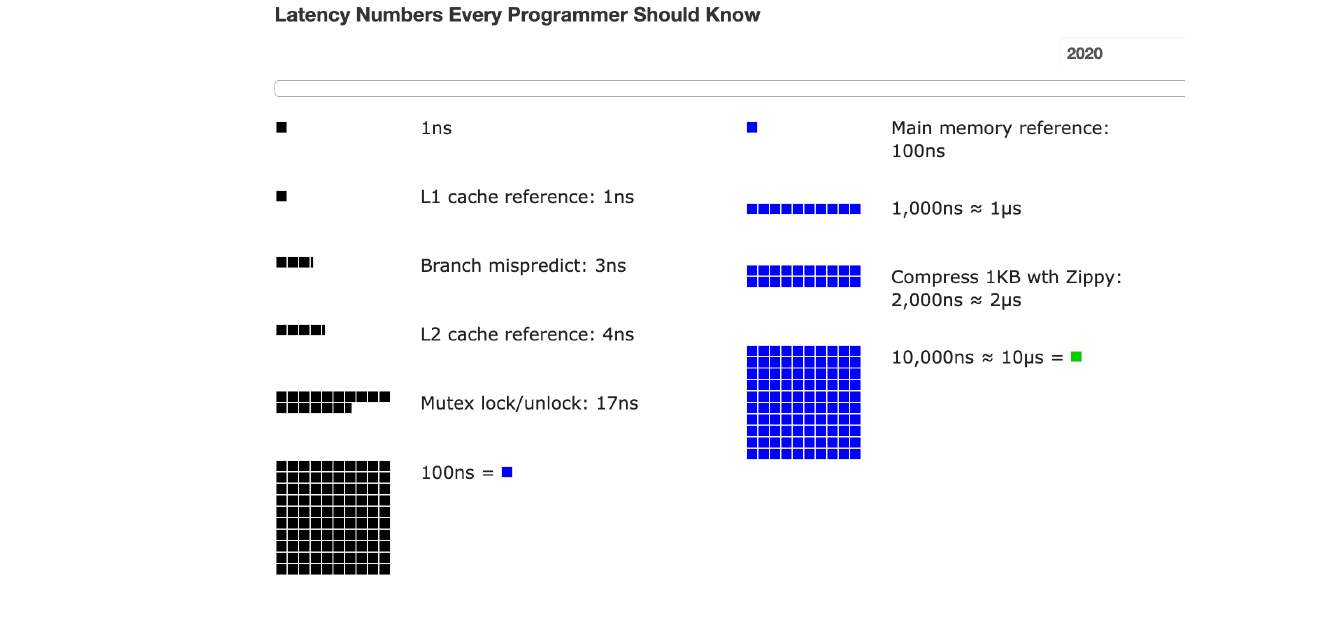
图中给出某组历史示意数值:L1 缓存读取约 1 ns,分支预测错误约 3 ns,L2 读取约 4 ns,mutex 加解锁一对约 17 ns,主存读取约 100 ns。它们用于说明数量级,实际数值随处理器、缓存状态和争用改变。
原子读改写通常还需要协调缓存行的所有权。多个核争用同一锁时,状态在核之间反复转移,成本可能进一步增加。因此,“少给只读记录做共享写入”能成为 OCC 的优化方向;最终仍要测量验证、重试和发布的完整成本。
提交次序
沿一个具体例子看验证怎样工作。初始 A=B=100:
- T1 计算
B=A+B,读集合包含 A=100、B=100,写集合准备 B=200。 - T2 计算
A=A×1.1,读集合包含 A=100,写集合准备 A=110。
这里按示例的精确十进制数计算,实际货币程序还要使用合适的金额表示。
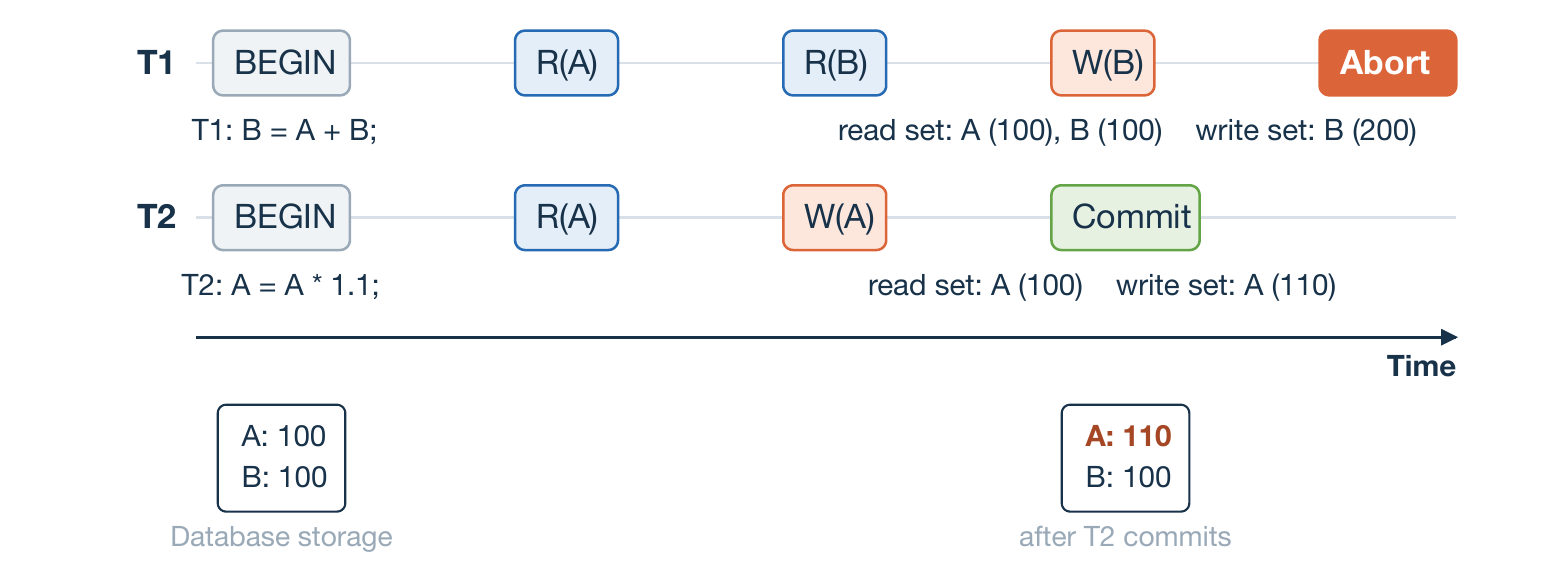
T2 先进入提交范围,A 的原版本仍匹配,可以发布 A=110。T1 随后验证时,发现它曾读取的 A 已更新,丢弃暂存的 B=200。重试 T1 会读到 A=110、B=100,重新计算 B=210。
这套验证自然地把后来成功重试的 T1 排在 T2 之后。它维护了一个具体的可串行化顺序,同时可能限制其他原本也合法的排列。
保守中止
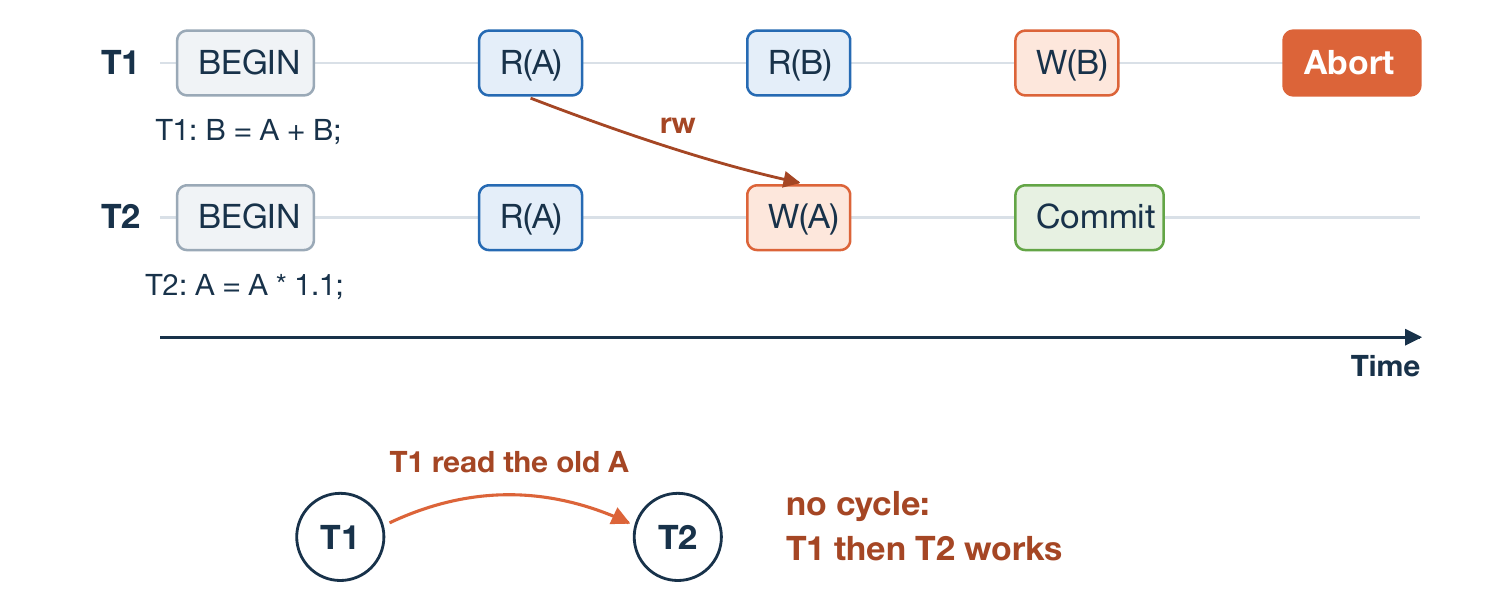
仍看上节同一组读取和暂存写入。若允许把 T1 排在 T2 前,则 T1 先根据旧值把 B 改为 200,T2 再把 A 改为 110,最终可以是 A=110、B=200。T1 读旧 A 只产生 T1→T2 的依赖,没有相反方向的冲突环。
但本节这套按提交时的当前版本检查依赖的 OCC,会因 T2 先发布 A 而拒绝原 T1。这称为保守中止或误中止(false abort):协议拒绝了一个按更灵活顺序仍可接受的执行。这个说法针对该协议选择的检查条件。
思考题:上例为什么可以中止 T1,又称它为误中止?T1 重试后得到的 B=210,与原本可接受的 B=200 各对应什么顺序?
解答:
原 T1 的 A 版本已经变化,按本算法应中止;若另选 T1→T2 的顺序,原来的 B=200 也有合法解释,因此称为保守拒绝。重试后的 B=210 对应 T2→T1;B=200 对应 T1→T2。两种结果各自依赖一个完整的串行顺序。
读取记录越多,执行时间越长,读集合中某一项被其他事务修改的机会通常越大。重试要丢掉这段已经完成的计算;冲突频繁时,同一笔事务可能反复失败。需要结合重试调度和完成机会处理活锁、饥饿,基本区别见重试活性。
冲突负载
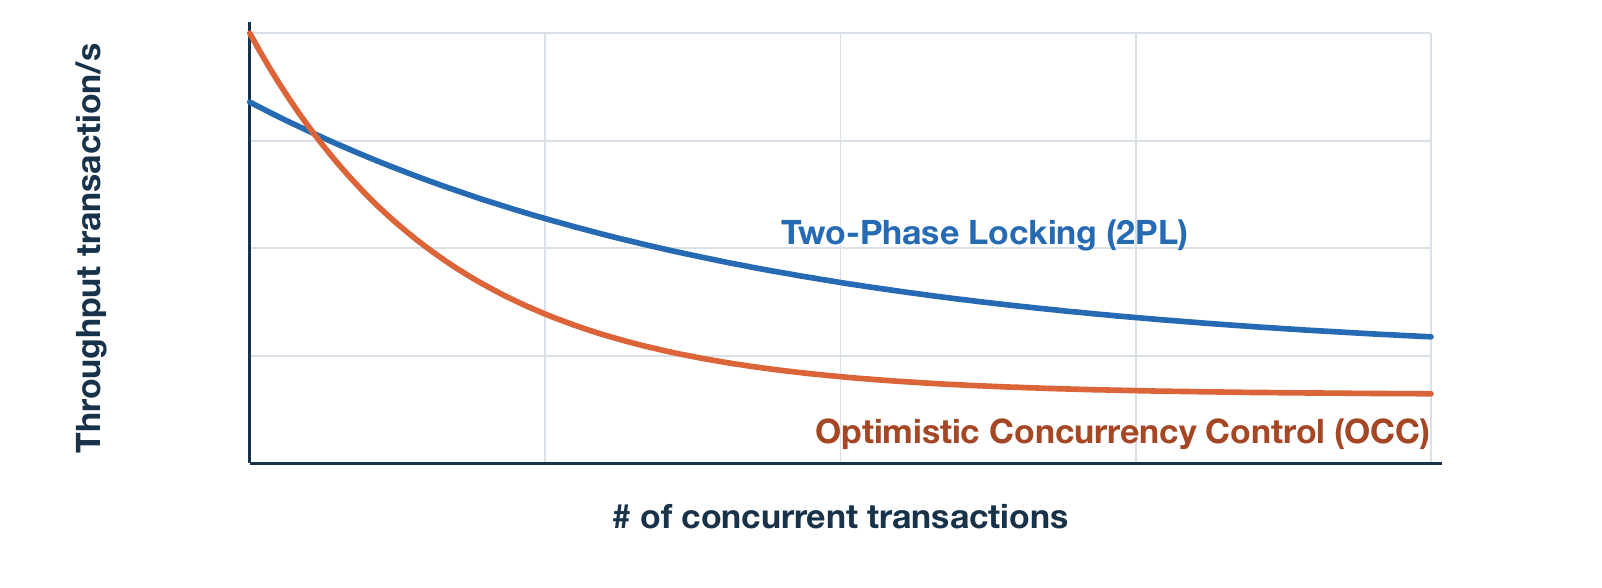
横轴为并发事务数,纵轴为事务吞吐量。图中没有给出完整数值刻度,用于概括一种负载趋势:OCC 在低冲突时减少持锁与等待;共享热点增加以后,验证失败、回滚和重复计算消耗更多资源。2PL 的等待也有成本,但可以避免先完成大量工作再因冲突丢弃。
并发数本身没有决定冲突程度。如果事务始终访问不同对象,增加并发可以继续分担工作;若都修改少数热点,等待或重试会更明显。选择方案要测量读写集合大小、执行时间、热点分布、成功提交率和完成事务的总成本。
硬件事务
硬件事务内存(Hardware Transactional Memory,HTM)由处理器跟踪一段代码的内存访问,尝试让这些访问作为一个整体提交;冲突或资源条件不满足时,中止这次尝试,撤销相应的事务性修改。
Intel 的 RTM 是 Restricted Transactional Memory,属于 Intel TSX 的接口之一,最早出现在支持该功能的 Haswell 产品中。其他体系结构也提出过相应机制,例如 Arm TME;具体处理器、系统和指令接口需要分别确认。
RTM 的基本指令为:
| 指令或接口 | 作用 |
|---|---|
XBEGIN / _xbegin |
开始一次事务尝试,指定中止后的控制流 |
XEND / _xend |
尝试提交当前事务 |
XABORT / _xabort |
程序主动中止 |
事务成功开始后,代码可以按普通内存访问的形式读取和修改受保护数据。中止时,CPU 撤销这次区域内的事务性写入和相应寄存器状态,再进入失败处理分支。_xbegin 返回的状态帮助程序判断是否进入事务、是否适合重试。
这种原子性保护内存执行中的相关访问。数据库还需要日志等持久化规则;网络发送、设备 I/O 等外部效果也不能靠这段内存回滚随意撤销。因此事务区域应选择适合这种执行方式的代码。Intel RTM 说明
硬件冲突
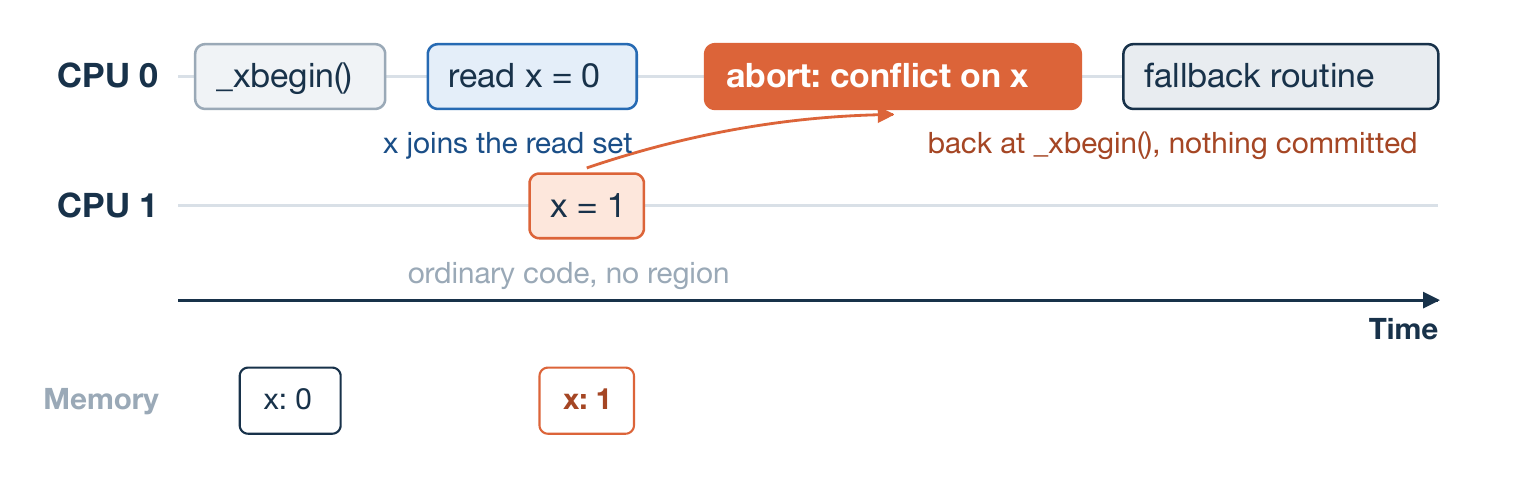
图中 x 最初为 0:
- CPU 0 执行
_xbegin,进入事务区域,读取 x=0。 - x 所在缓存行进入硬件读集合。
- CPU 1 在事务区域之外执行 x=1。
- 硬件检测到冲突,让 CPU 0 的这次事务尝试中止。
- CPU 0 进入 fallback 分支,之前尚未提交的事务性修改被撤销;CPU 1 的 x=1 保留。
图中的处理不要求普通写入者等待这段事务完成。检测后怎样选择中止者和处理争用,由具体硬件实现决定。区域外由多步组成的业务,也仍需要它自己的同步安排。
思考题:另一个线程在 RTM 区域之外写入 x,会自动被纳入同一笔事务吗?
解答:
该写入属于另一个执行过程。图中它改变了当前事务已经读取的缓存行,引起事务中止;它自己的写入仍生效。事务的失败处理随后决定重试或采用其他同步路径。
失败处理
RTM 采用尽力而为的事务执行,架构没有保证某一段代码最终一定能以硬件事务方式成功。只用无限重试,可能一直停在失败循环。
一种常见方法是有限次尝试后,回到保证能够推进的普通加锁路径。事务快速路径也要读取并检查同一把后备锁,让它与慢路径共同协调。
1 | # 逻辑流程;具体代码需使用编译器支持的 RTM 和锁接口。 |
这里的 K 是重试上限。RTM 可用性要在相应平台上确认,不支持或被禁用时直接走后备路径。快速、后备和其他相关访问路径还要共同遵守同步规则。
思考题:为什么快速路径必须读后备锁?只在多次失败后取得锁就够吗?
解答:
一台 CPU 可能正在持有后备锁修改数据,另一台却尝试硬件事务。快速路径读取锁状态,把锁所在行纳入读集合;后备路径取得锁时修改该状态,会与相关快速路径冲突。快速路径若发现锁已持有,就主动中止。
这样两条路径共享同一套互斥条件。只有后备路径使用锁、快速路径完全忽略锁时,二者的业务可能不受同一规则协调。Intel 后备路径说明
缓存跟踪
HTM 可以理解为硬件中的乐观执行:先跟踪读写和暂存结果,再检测能否提交。硬件利用缓存与缓存一致性协议承担部分工作。
缓存行是一小段由硬件共同管理的内存内容。一个核想写某行时,需要取得相应的写入权限;其他核可能收到使该行失效等一致性消息。
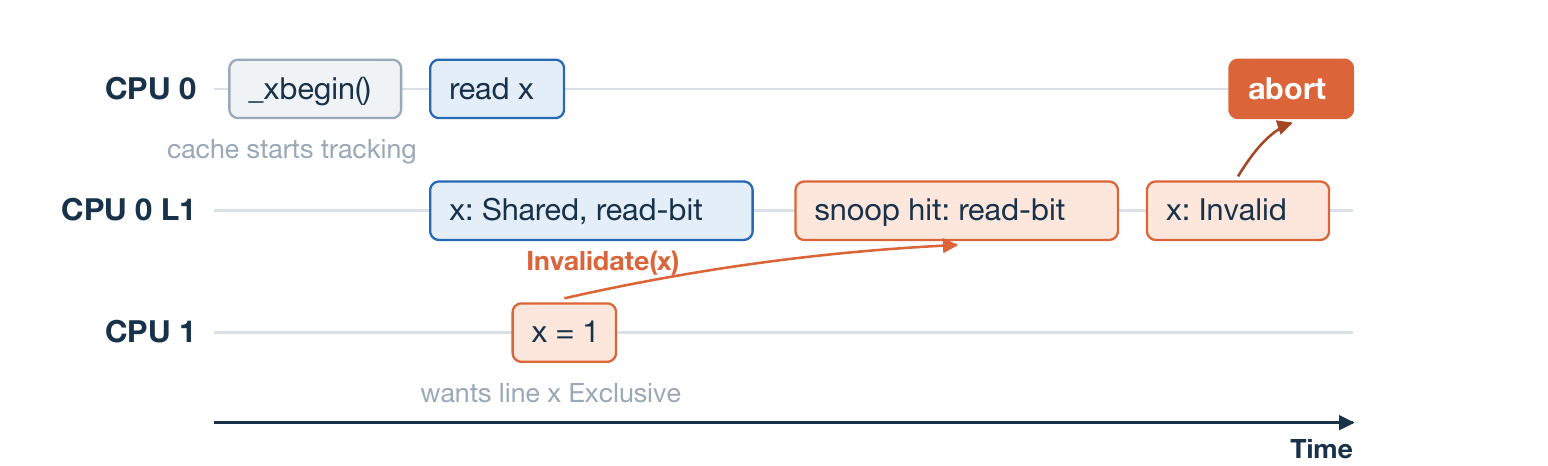
图中 CPU 0 读取 x 后,本地缓存将其标为共享状态,并记录它属于当前事务的读集合。CPU 1 想写 x,要求取得对应行的独占权限;失效消息到达 CPU 0,命中读集合标记,CPU 0 中止事务。
暂存写入同样需要硬件保存追踪状态,并在提交时按规定发布。缓存行中的 read-bit 等框表示概念上的事务跟踪信息,具体内部结构因处理器而异。追踪以缓存行为单位,还可能让访问同一行不同字段的线程发生额外冲突。
容量限制
缓存用于跟踪事务,也限制了能够同时保存多少事务状态。工作集指这次事务读取或写入所涉及的数据范围。
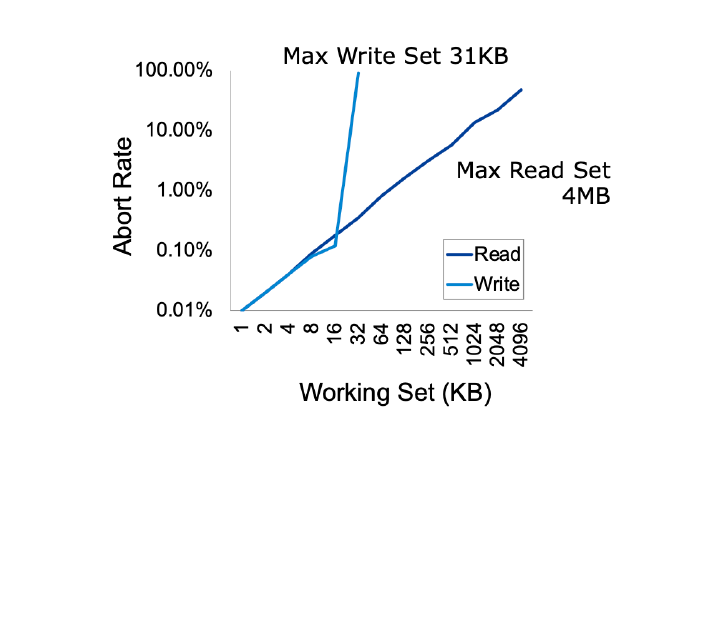
横轴是工作集大小,纵轴是中止率,两者都采用非线性的刻度。图中标出写集合约 31 KB、读集合约 4 MB 的历史测试结果。随着集合增大,中止率上升;写集合更早达到图示限制。
写集合需要暂存尚未提交的修改,读集合需要保留检测冲突的状态。图示实现把事务写入与 L1 缓存容量联系起来,读集合的跟踪还能利用其他缓存层级。缓存容量、关联度、地址分布和同时运行的工作都会影响结果,不能直接把总缓存大小当成每笔事务一定可用的空间。
这些数值来自特定 Haswell 时代实验,作用是说明硬件追踪资源有限,不构成所有处理器的统一事务容量保证。Wang 等,EuroSys 2014
执行时长
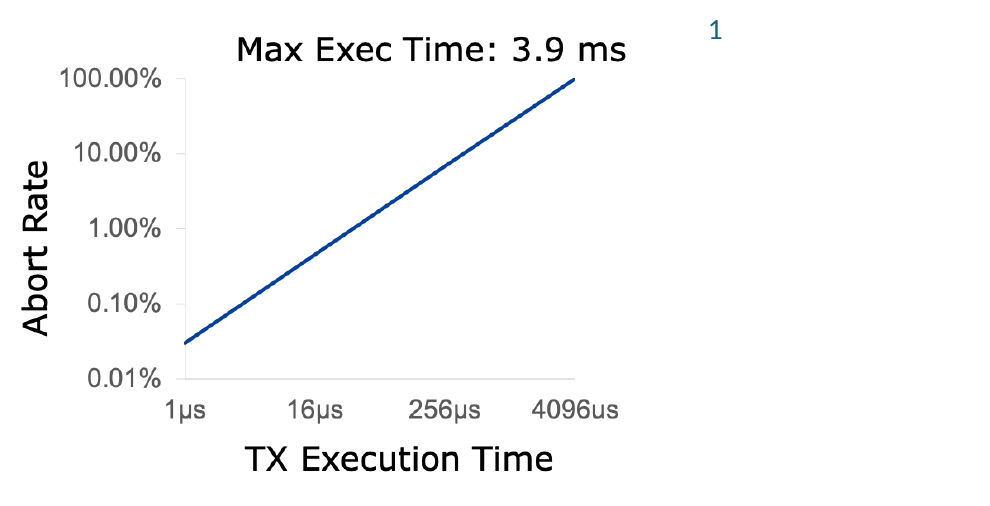
横轴是事务执行时间,从微秒增加到毫秒;纵轴为中止率。图中在长事务处接近 100%,并标出约 3.9 ms。这个结果描述相应实验中的长事务中止现象,具体时长还取决于平台、执行事件与访问方式。
事务越长,遇到中断、调度、缓存状态变化或其他冲突的机会通常越多。某些指令和事件本身也会引起中止。适合 RTM 的代码应尽量保持内存工作集和执行时间可控,避免把等待网络或设备响应的长过程直接放进区域。
失败后的后备路径仍要保持业务正确,并能够在这些条件下继续运行。成功路径较快与整体程序能够稳定完成,需要一起评估。
负载差异
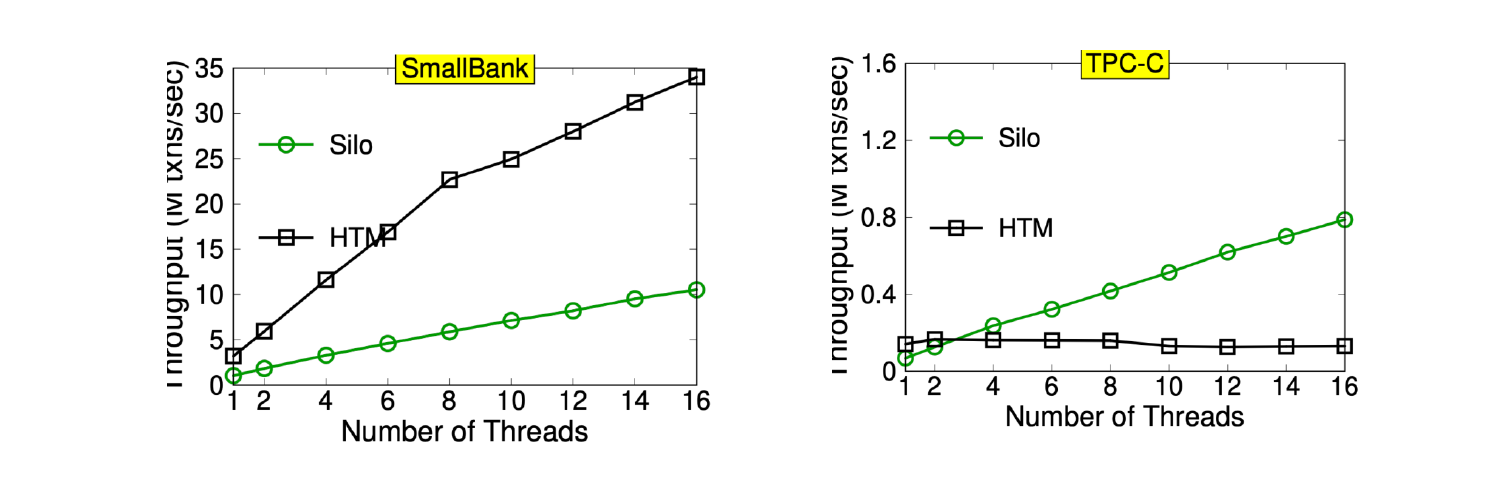
两张图横轴都是线程数,纵轴都是每秒百万事务,但纵轴范围不同。左图 SmallBank 中,HTM 曲线增长较快;右图 TPC-C 中,软件 OCC 系统 Silo 随线程增加取得更高吞吐,实验中的 HTM 方案增长有限。
SmallBank 包括较短的账户操作。TPC-C 的新订单等业务会访问多条商品、库存与订单明细,读写集合和控制流程更复杂,硬件容量及中止成本更容易产生影响。图示结果说明硬件支持仍需与负载特点配合。
Silo 是 SOSP 2013 提出的内存数据库,使用面向多核的 OCC 提交协议。这里的比较针对图中的系统版本和配置,不能据此给所有软件 OCC 与 HTM 排出固定优劣顺序。Silo 原论文
成功时,HTM 可以减少显式记录读写集合和部分软件同步的工作;失败处理、容量限制、普通代码路径的协调仍由程序设计者安排。OCC 的方法也因此有软件与硬件等多种实现形式。
长时间读取
浏览商品、生成报表和审计可能读取很多记录,真正修改数据的请求相对较少。2PL 需要安排读锁与写锁的协调,OCC 则可能因读取期间出现更新而让较长计算重新开始。
如果一笔事务只查询一个完整历史状态,读到稍早的结果也许符合业务。保留旧版本,就能给这类读取提供另一种执行方式。
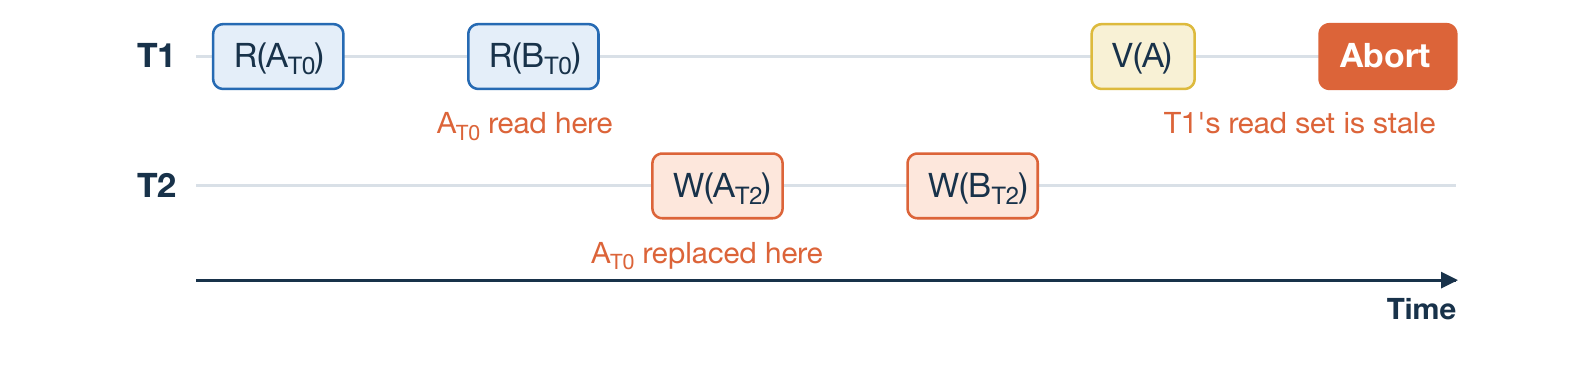
T1 计算 A+B,先读到 A0、B0。T2 随后把 A、B 改成新值并提交。T1 到提交检查时,旧版本已经过期,于是被本节前面的 OCC 算法中止。
思考题:T1 已完整读取旧 A、旧 B,只准备返回它们的和。为了取得一个可串行化的读取结果,是否必然要中止它?
解答:
若这两项来自同一个合法旧状态,可以把只读 T1 排在 T2 前。普通 OCC 的当前版本验证仍会拒绝它,但业务可以选择由多版本机制继续提供这份完整旧快照。前提是旧状态确实一致,并且满足接口所承诺的时效。
另一种交错更需要保留旧版本:T1 读完 A0,T2 更新 A、B 并提交,T1 才准备读 B。如果只剩新 B,它就会组合到旧 A、新 B。将旧 B 留下来,才能继续取得原先那份快照。
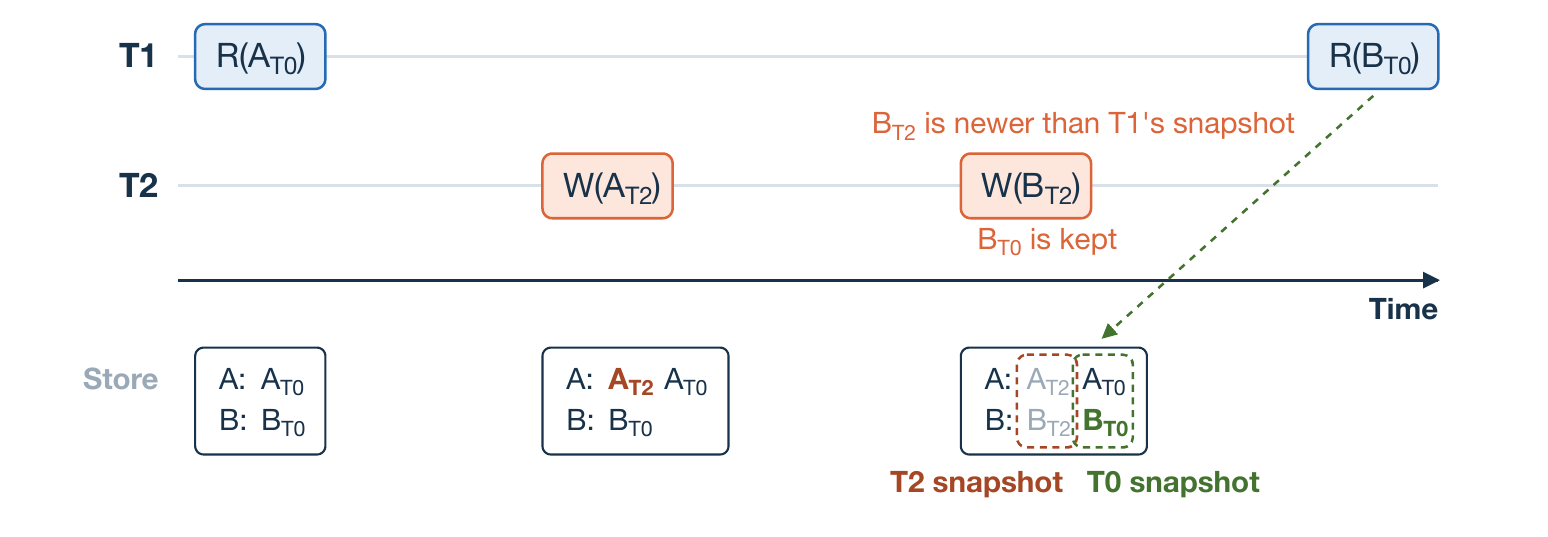
图中较新的 B 仍供之后的事务使用,较早开始的 T1 继续选择 B0。保留版本需要同时规定如何选取版本,才能保证每次读取来自同一份逻辑状态。
多版本
多版本并发控制(Multi-Version Concurrency Control,MVCC)为一条记录保存多个版本。每个版本至少包含数据值,以及决定它何时可见的标记。
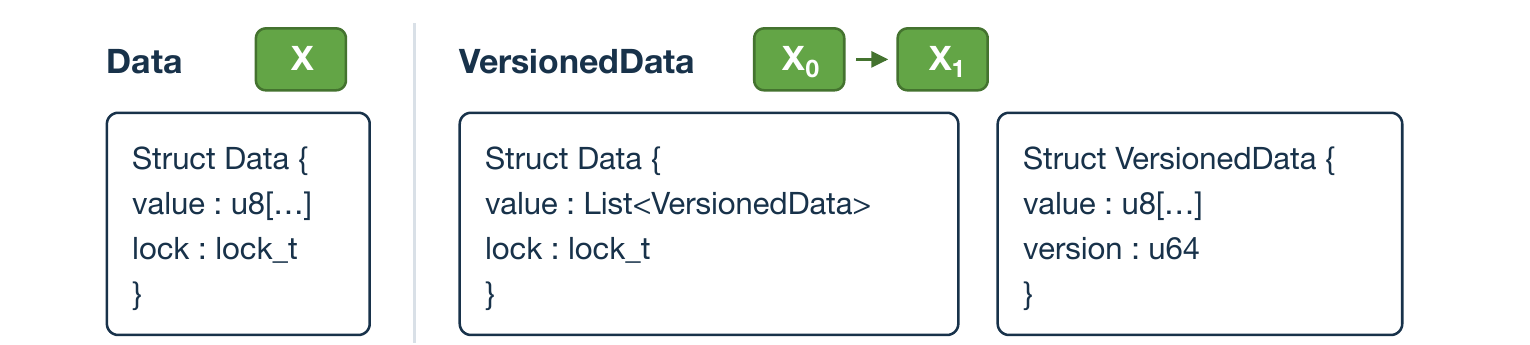
例如 A 的版本链可以写为:
| 版本标记 | 数据值 |
|---|---|
| 0 | 1 |
| 3 | 2 |
| 7 | 5 |
快照时间为 4 的事务选版本 3,取得值 2;快照时间为 8 的事务选版本 7,取得值 5。版本号和数据值分别表示历史位置与实际内容。
快照表示一组在同一可见性规则下选出的记录。事务开始时取得快照边界,之后每次读取都按同一个边界选择,自己的暂存写入仍优先对本事务可见。
写入则创建新版本,保留旧版本供仍在使用它们的读者访问。不同记录的最新版本号不必相同:某条记录较久没变化,它较早创建的版本仍可属于当前快照。
逻辑时间
本例使用全局原子计数器产生递增编号,作为开始时间 sts 和提交版本标记 cts。它们决定版本的逻辑次序,不要求等于现实中的秒数。
FAA 是 fetch-and-add,原子地取出计数器旧值并加上给定增量。例如计数器从 0 开始,可以用 FAA(g,1)+1 得到编号 1、2、3。不同线程取得不同编号;开始与发布过程使用同一套次序规则。
只读事务的版本选择为:
含义是:在对象 X 的可见版本中,找出提交标记不超过 T 开始边界的最新一个。式中的 max 按版本时间排序。
练习:A 有提交标记 0、3、7 的三个可见版本,值分别为 1、2、5。事务开始边界为 4,应读哪个版本?它后来再次读 A 时,能否直接换成最新版本 7?
解答:
读取标记 3 的版本,得到 2。固定事务快照继续使用边界 4,版本 7 超出该边界;再次读取仍应按同一个快照规则选择。若本事务已暂存修改,则按读自己写入的规则取得本地结果。
部分快照
只给新版本加上编号,还不能自动保证一整笔修改共同可见。写入包含多个记录,物理安装仍是分步完成的。
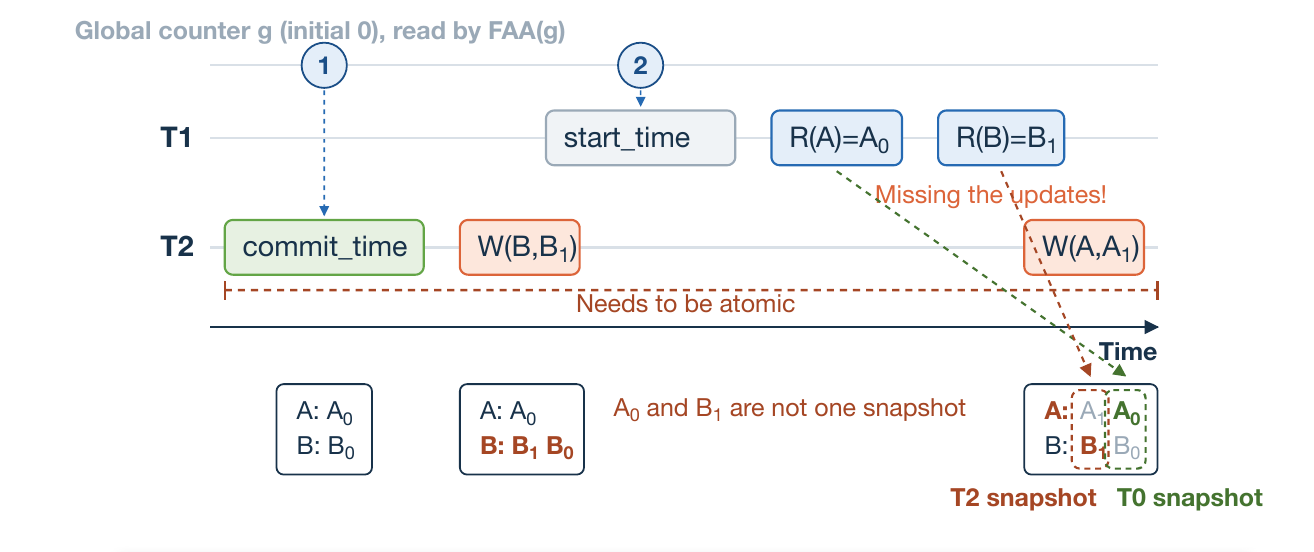
图中的过程为:
- T2 取得版本时间 1,准备同时生成 A1、B1。
- T2 先安装 B1,A1 还没写入。
- T1 取得开始时间 2。
- T1 读取 A,只找到 A0;读取 B,则找到满足
1≤2的 B1。 - T2 最后才安装 A1。
T1 取得的 A0、B1 混合了同一笔事务的前后状态。虽然每次读取都遵守了编号比较,一组更新的发布边界仍缺少协调。
这里的 cts 是发布过程中使用的逻辑标记。分配到它,只代表取得了编号;只有满足协议的安装、可见性和持久化条件,才具有相应的“提交完成”含义。
完整可见
一种便于理解的办法是:写入者先锁住全部写集合,再取得用于发布的时间标记,然后逐项安装新版本。读者遇到仍在安装的记录,就等待它变为可安全读取的状态。
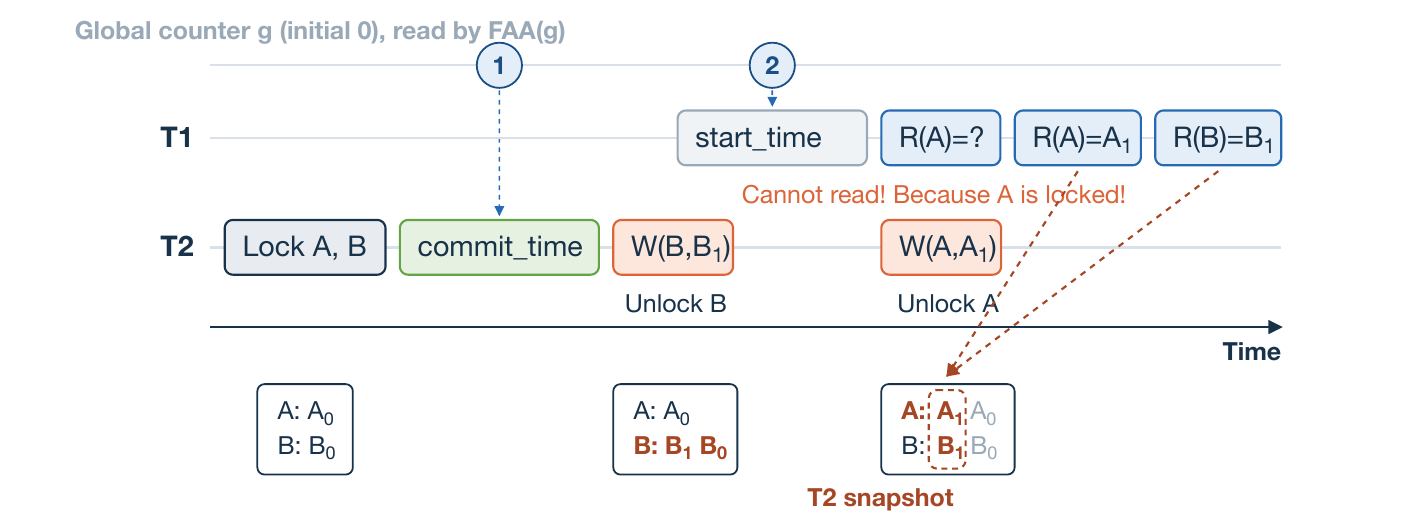
图中 T2 先锁 A、B,再取得时间 1。安装 B1 并释放 B 的锁后,T1 取得开始时间 2。它读取 A 时发现 A 仍被锁住,所以暂时等待;A1 安装完毕并释放后,T1 读取 A1,再按同一边界读取 B1。
这个示例允许已经安装完成的记录先释放锁。每条记录都必须在自己的新版本安全发布后才能解锁;读者要遵守锁状态、版本可见性和并发遍历规则。也可以选择全部安装后统一发布状态或统一解锁,实际数据库还有其他快照发布方案。
思考题:在这套读者遇锁等待的方案中,能先取提交时间,再去锁记录吗?
解答:
若写入者先取得 1,后来才锁 A、B,读者可能在这段间隔取得开始时间 2,并在任何锁出现前读走旧 A。之后写入者安装新 B,读者又按
1≤2选到它,仍会组合旧 A、新 B。因此这套规则要求全部相关写锁先建立,再分配发布版本时间;或者另用能保证完整快照可见的协议。时间编号的分配顺序需要与记录的保护和发布顺序一起设计。
版本链还需要安全访问:读者取得的节点不能在访问途中被释放,链头等共享元信息需要正确发布。只在普通代码中检查一次布尔变量,并不足以实现完整的并发数据结构。
写入冲突
多版本让读者选择历史版本,修改共享结果时仍要检测竞争。下面两笔事务都执行 A+=1,初始 A0=0。
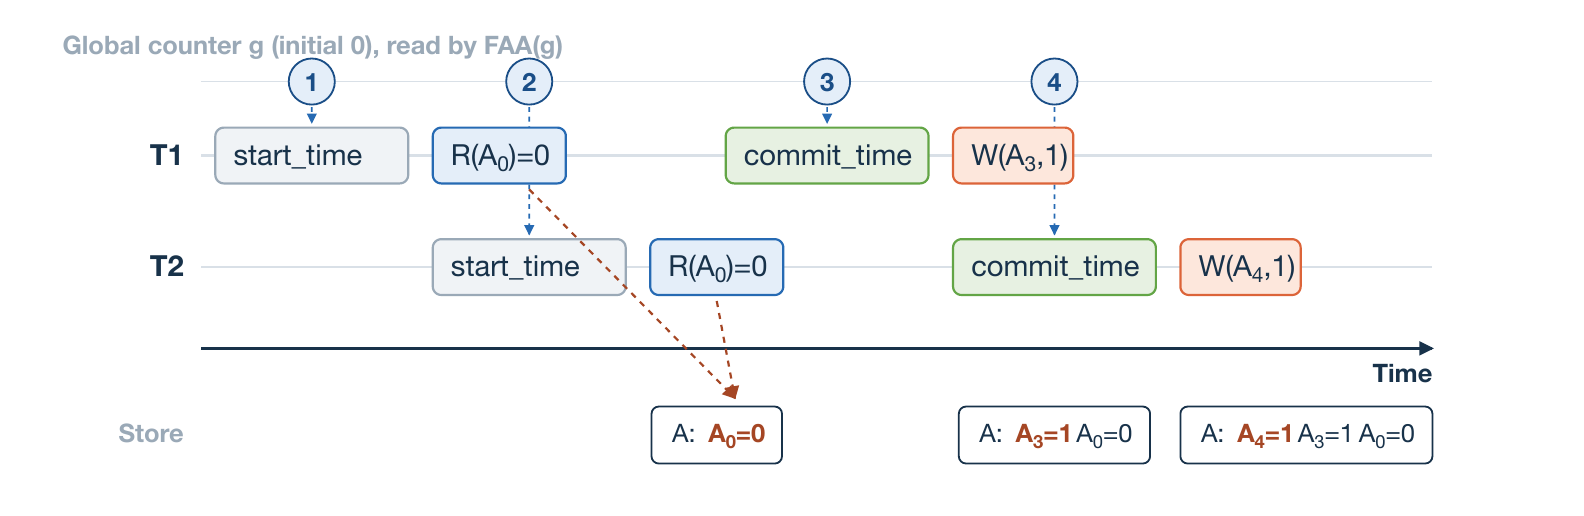
T1 的开始时间为 1,T2 为 2,二者都读 A0=0。若不验证就提交,T1 生成 A3=1,T2 又生成 A4=1。版本链里虽然有两个新版本,最新值仍为 1;两次完整自增应得到 2。
思考题:保存了两个值为 1 的新版本,是否意味着两次自增都正确生效?第二个写入者需要检查什么?
解答:
自增的新值取决于读取的旧值。两者都从 0 计算出 1,第二次没有接续第一次已经产生的结果。提交时应检查目标记录是否出现了本事务开始之后的新提交;若已经有,就丢弃旧计算、重试,或按其他明确的冲突规则处理。
在写锁保护下,可以对写集合中每个对象检查:
T2 开始于 2,提交时 A 的最新提交标记已为 3,满足 3>2,所以中止。重试取得更新的开始边界,读到 A3=1,再计算 2,才能接续这笔增加。
快照隔离
把前面的固定快照读取与写写冲突检测合在一起,就得到一类快照隔离(Snapshot Isolation,SI)的实现思路。
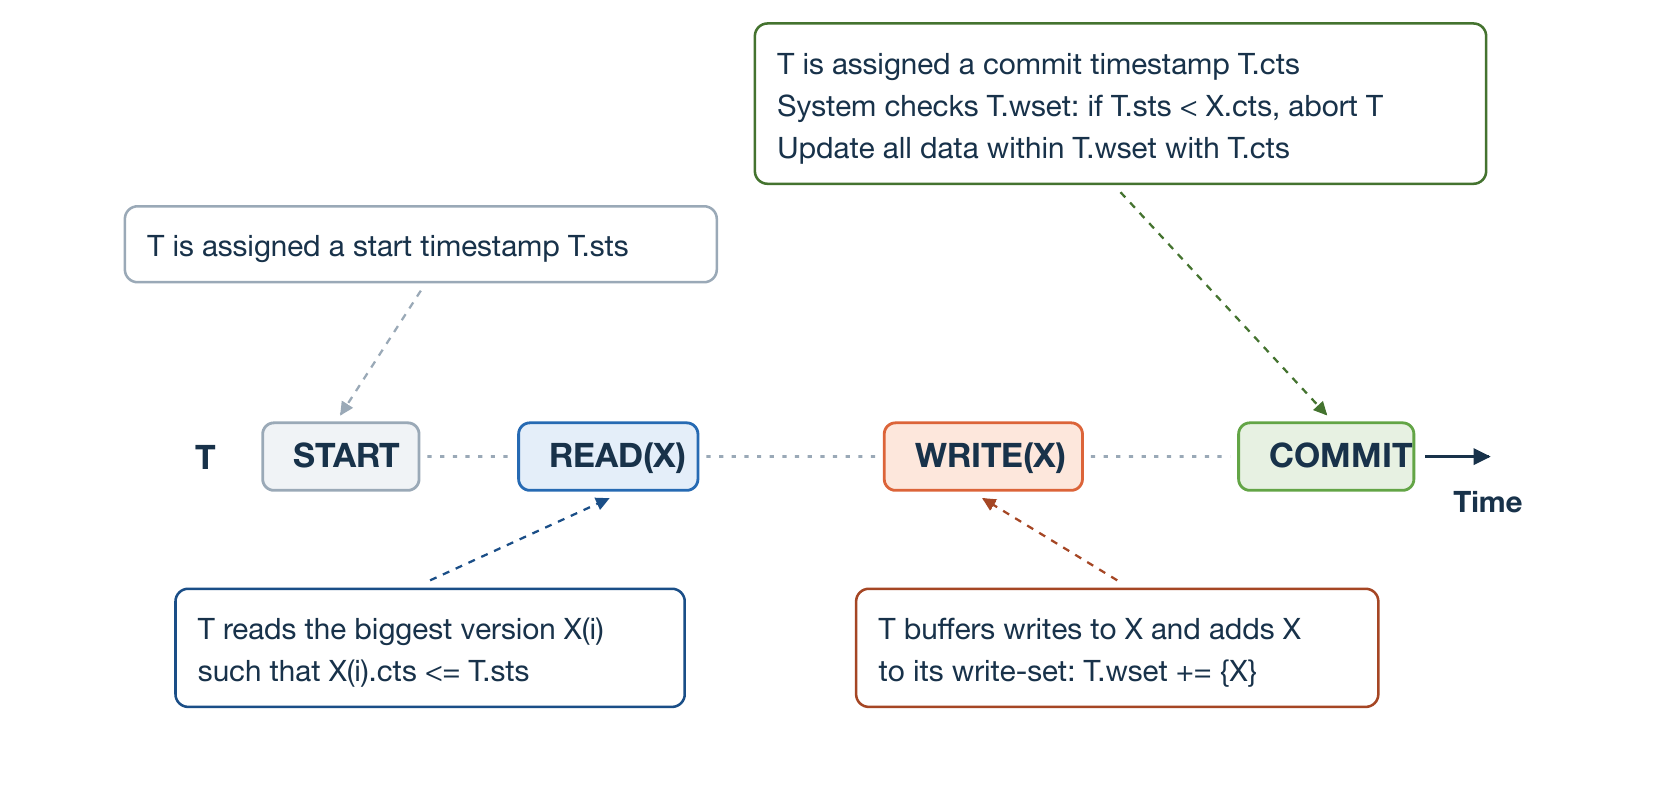
可以按下表跟踪:
| 时刻 | 操作 |
|---|---|
| 开始 | 取得 sts,建立私有写集合 |
| 读取 X | 优先读自己的写入,否则选择可见的最新 cts≤sts 版本 |
| 修改 X | 在私有工作区计算,并放入写集合 |
| 提交准备 | 按共同规则锁住写集合,检查最新写版本是否超过 sts |
| 发布 | 取得合适的 cts,安全安装完整新版本,再按协议解锁与确认 |
验证和取得编号的具体安排由实现决定,必须满足前面解释的发布条件。在本例中,写集合被保护期间再决定相应检查与编号,避免其他写入者插入冲突更新。
一笔只读事务没有写集合;已经取得完整有效的固定快照时,可以按它读完,通常无需因后续写入更新了当前版本而重新验证、重跑。它仍可能等正在发布的版本,系统故障、用户取消等情况则按相应接口处理。
读写事务即使通过这套写写检查,也还没有检查所有跨记录依赖。
写偏差
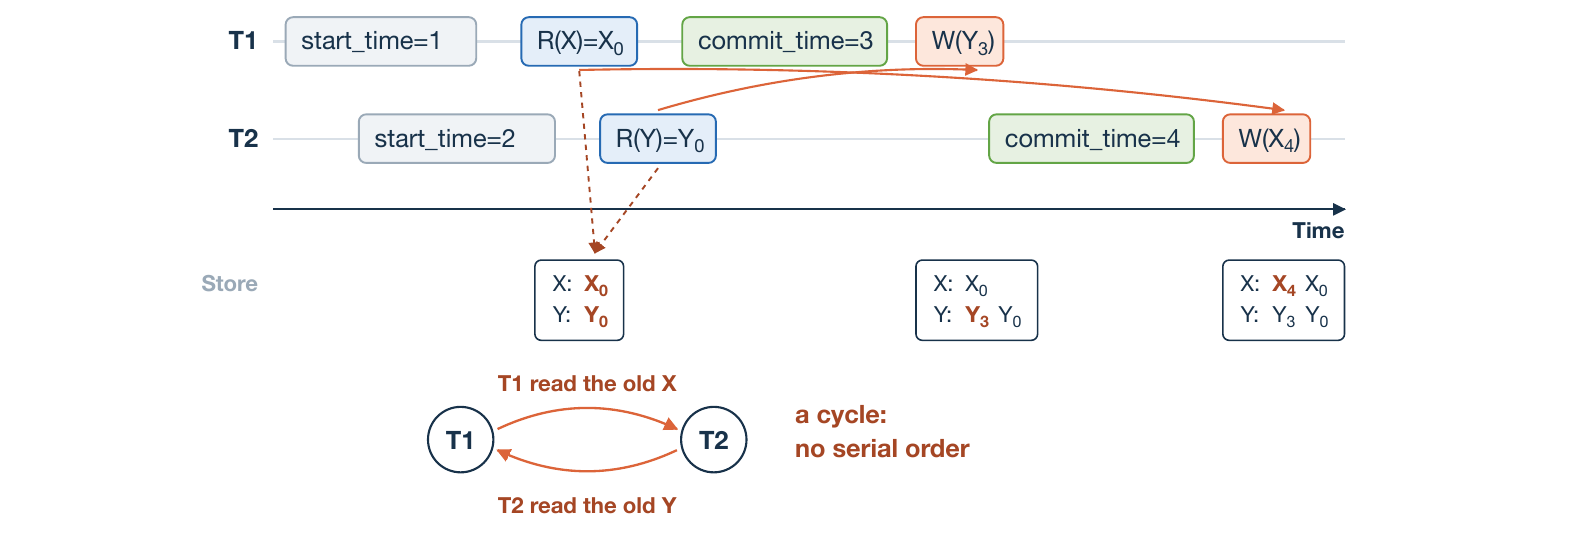
图中 T1 开始于 1,读取 X0,再提交 Y3;T2 开始于 2,读取 Y0,再提交 X4。两个事务写不同对象,彼此的写集合没有重叠,所以写写检查可能都通过。
但 T1 使用了 T2 修改之前的 X,要求在相应串行解释中位于 T2 前;T2 又使用 T1 修改之前的 Y,要求位于 T1 前。依赖成环,无法将两笔完整事务排成符合这些观察的串行顺序。这类异常称为写偏差(write skew)。
例题:两位值班人员 X、Y 初始都在岗,1 表示在岗、0 表示离岗。规则要求至少一人在岗。T1 读取 X,确认 X=1 就将 Y 改为 0;T2 读取 Y,确认 Y=1 就将 X 改为 0。二者从同一旧状态开始,快照隔离的写写检查会发现冲突吗?业务结果是否正确?
解答:
T1 的写集合只有 Y,T2 的写集合只有 X,没有共同写入的记录,因此仅检查写写冲突时可以都通过。二者分别看到对方仍在岗,最终得到 X=0、Y=0,违反至少一人在岗的规则。
如果 T1 完整先执行,T2 随后会看到 Y=0,不能再让 X 离岗;反过来也一样。两者都离岗没有合法串行解释。这正对应图中的双向读取依赖。
SI 能提供稳定快照并避免这里的同记录丢失更新,跨记录业务约束仍可能因这种依赖受到破坏。MVCC 是保存和选择版本的机制,可以与不同的并发控制协议结合;SI 是其中一种隔离保证。Berenson 等,1995系统讨论了快照隔离与这些异常。
读取验证
一种继续加强的办法是:读写事务在提交时验证读集合,检查它依赖的记录是否出现了会破坏串行解释的变化,并与相应的提交锁协议配合。前面的 OCC 思路可以用于这类多版本读写事务。
在值班例子中,若 T1 已发布 Y=0,T2 再验证它读取的旧 Y,就会发现依赖过期;若两者同时准备发布,锁状态与依赖检查也必须共同协调。不能让双方都仅在对方发布之前通过检查,然后独立写入。
纯只读事务可以继续使用完整快照,减少长查询的重跑。读写事务则根据需要选择更强的验证、锁定业务约束涉及的对象,或使用数据库已经实现的可串行化机制。
思考题:SI 下可以默认忽略写偏差吗?“使用 MVCC”是否已经说明系统提供了可串行化?
解答:
应先检查业务是否依赖跨记录条件;值班人数、额度总和等规则都可能受到影响。需要这些条件时,应选择能处理相应依赖的事务机制。
MVCC 说明保存并选择多个版本,具体隔离还取决于写冲突、读依赖和提交规则。MV-2PL、MV-OCC 等可以在多版本存储上提供不同保证,不能只凭 MVCC 这个名称确定事务的隔离级别。
版本回收
保留旧版本会占空间。某个仍在运行的事务可能还要读旧快照,过早删除它需要的版本,就会破坏后续读取。
系统可以跟踪活跃快照边界,保留每个边界所需的最新历史版本和之后仍可能被访问的版本;确认没有读者需要某段历史后,再安全回收。新链头的发布和旧节点的释放也要与并发访问协调。
长查询因此可能增加历史保留量。需要同时考虑读取稳定性、内存或存储占用以及回收进度,不能只根据某版本“已经被新版本替代”就将它删除。
机制选择
| 机制 | 主要做法 | 适用条件与成本 |
|---|---|---|
| 2PL | 访问前取得相应锁,遵守取锁与释放阶段 | 冲突时等待,注意锁范围和死锁 |
| OCC | 私有计算、验证依赖、发布写集合 | 低冲突时减少持锁,高冲突或长事务可能反复中止 |
| HTM | 硬件跟踪内存读写并尝试原子提交 | 受容量、执行事件与平台支持限制,必须有正确后备路径 |
| MVCC | 读取固定快照,写入保留新旧版本 | 长读可减少重跑,隔离保证取决于进一步的冲突检查 |
同一系统可以组合这些方法。例如用 MVCC 服务长只读事务,给读写事务增加 OCC 验证;或者用 HTM 作为一段锁保护代码的快速路径,失败时回到锁。
检查实现时,依次确认读取来自哪个版本、暂存修改是否已经共享可见、验证与发布怎样协调、冲突后怎样清理重试,以及整笔事务最终承诺哪种隔离与持久性。
参考资料
- Kung 与 Robinson,1981,On Optimistic Methods for Concurrency Control,ACM TODS 6(2),213–226。
- Intel,指令手册、RTM 接口与后备路径。
- Colin Scott,Numbers Every Programmer Should Know By Year,历史延迟示意。
- Mu 等,2014,Extracting More Concurrency from Distributed Transactions,OSDI。
- Wang 等,2014,Using Restricted Transactional Memory to Build a Scalable In-Memory Database,EuroSys。
- Tu 等,2013,Speedy Transactions in Multicore In-Memory Databases,SOSP。
- Saltzer 与 Kaashoek,2009,Principles of Computer System Design: An Introduction,事务与原子性。
- Berenson 等,1995,A Critique of ANSI SQL Isolation Levels,SIGMOD。
- PostgreSQL,事务隔离文档,快照与可串行化的接口实例。