贪心思想
贪心算法每一步根据当前情况选择一个看起来最有利的操作,通常不撤销已经作出的选择。局部选择能否导向全局最优,需要针对问题证明。课件用三个问题说明不同结果:最小生成树的贪心算法能精确求解;集合覆盖的贪心算法有近似保证;零钱兑换则依赖面值的特殊结构,对任意面值未必正确。
分析时应明确本轮选择的对象、选择后仍然成立的性质,以及何时结束。最小生成树的关键不变量是:已经选择的边仍能扩展成某棵最优树。后面的割性质将保证这个不变量。
对最小生成树,这个不变量可以形式化。记 T∗ 为图中所有 MST 的集合,Xt 为前 t 步已选择的边集,则要保持
Tt={T∈T∗:Xt⊆E(T)}=∅.
初始 X0=∅,所以 T0=T∗=∅。若本轮选择边 e,交换论证需要保证:对某棵 T∈Tt,能找到一棵生成树 T′,满足
Xt∪{e}⊆E(T′),w(T′)≤w(T).
由于 T 已最优,必有 w(T′)=w(T),从而 T′∈Tt+1。最终 ∣Xt∣=n−1 时,Xt 与包含它的 MST 边数相同,故二者相等。这把“本轮选择安全”与“最终全局最优”连接起来,也是后续割性质、Kruskal 和 Prim 证明使用的同一条逻辑。
最小生成树
课件从计算机组网出发:顶点表示计算机,无向边表示可以建设的连接,每条边有维护成本。目标是连接全部计算机,同时使总成本最小。
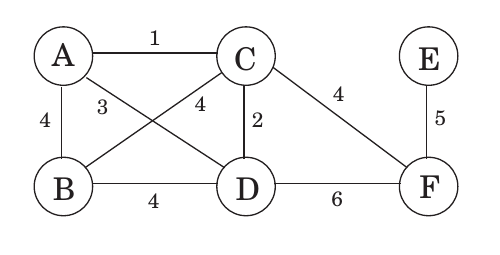
若连接中存在环,删除环上的一条边仍然连通;在图中所有成本均为正的条件下,删除还会降低成本。因此最优连接应当连通且无环,即构成一棵树。图中的一个最优方案为 AC,CD,BD,CF,EF,总权重为 1+2+4+4+5=16。
最小生成树(MST):给定连通无向图 G=(V,E) 及边权,选择边集 X⊆E,使 T=(V,X) 是树,且 w(T)=∑e∈Xw(e) 最小。
“生成”要求树包含全部顶点。若图不连通,就不存在生成树;可对每个连通分量分别求最小生成树,得到最小生成森林。单个顶点的生成树没有边,权重为 0。
下文统一记 n=∣V∣、m=∣E∣,并沿用上一篇的邻接表表示。
MST 的定义及下文的 Kruskal、Prim 算法允许零权或负权边。需要区分的是,上面的“最低成本连通子图一定无环”推导使用了正成本:有负权边时,任意连通子图问题可能希望保留额外的负权环,而 MST 问题从一开始就要求输出树。
树的性质
课件使用以下四条性质支撑后续证明,均针对有限无向图。
- 删除环边保持连通。 环上一条边的两个端点之间仍有另一条绕行路线,原来经过被删边的路径可以改走这段路线。
- n 个顶点的树有 n−1 条边。 从 n 个孤立顶点逐条加入树的边。每条边必合并两个不同分量,否则会形成环;从 n 个分量变为 1 个,恰需 n−1 次合并。
- 连通且恰有 n−1 条边的图是树。 若有环,反复删去环边,得到仍连通的无环图。结果是树,按上一条仍须有 n−1 条边,因此一条边也不能删,原图本来就无环。
- 树中任意两点之间恰有一条简单路径。 连通保证至少一条;若有两条不同的简单路径,它们的分叉与重新会合形成环。反过来,若任意两点恰有一条简单路径,图既连通也不可能有环,所以是树。
向一棵树加入一条原本不在树中的边,会与端点间的唯一路径组成一个环;再删去这个环中的任意一条边,就得到另一棵树。这种“加一条、换掉一条”的操作是交换论证的基础。
练习 5.4:证明:一个含 n 个顶点、k 个连通分量的无向图,至少有 n−k 条边。
本题考查生成树的边数与连通分量分解,等号对应生成森林。
记各连通分量为 G1,…,Gk,其中 ni=∣V(Gi)∣、mi=∣E(Gi)∣。每个连通分量都有一棵生成树,故
mi≥ni−1,i=1∑kni=n.
不同分量之间没有边,因此
∣E∣=i=1∑kmi≥i=1∑k(ni−1)=n−k.
当每个分量都是树时等号成立,即生成森林恰好有 n−k 条边。
割性质
割把顶点分成两个非空集合 S 与 V∖S。两个端点位于不同侧的边称为跨割边。若已选边集 X 中没有跨过这个割的边,就说这个割不切断 X 的任何一条边。
割性质:假设 X 包含于某棵 MST。选择一个不切断 X 的割,并从跨割边中取权重最小的边 e,则 X∪{e} 仍包含于某棵 MST。
取一棵包含 X 的 MST T。若 e∈T,结论已经成立。否则向 T 加入 e,会形成一个环。沿环跨入割的另一侧后,还必须跨回来,所以环上存在另一条跨割边 e′。
因为 X 没有跨割边,e′ 不属于 X。用 e 替换它,令
T′=T∪{e}∖{e′}.
删去环边保持连通,边数仍为 n−1,所以 T′ 是树;并且仍包含 X。由 e 是最轻跨割边,w(e)≤w(e′),故
w(T′)=w(T)+w(e)−w(e′)≤w(T).
T 已经最优,因此这里只能取等号,T′ 也是 MST。证明同时说明:最轻边权重相同时可以任选,但结论是“属于某棵 MST”,不要求每棵 MST 都包含所选边。
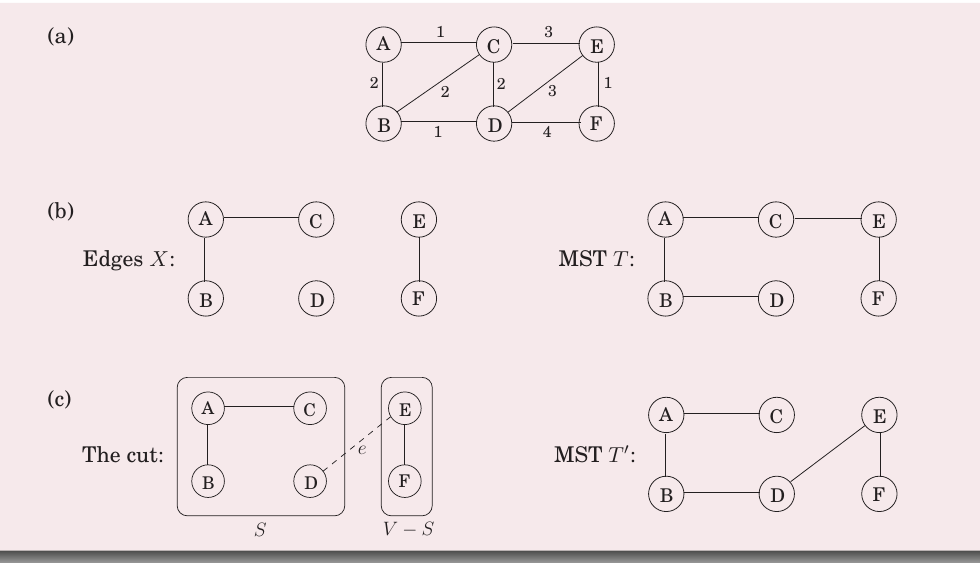
图中已选 X={AC,AB,EF},取 S={A,B,C,D}。跨割边有 CE:3、DE:3、DF:4。选 DE 后,可在图中的 MST T 中加入 DE、删去 CE,得到另一棵 MST T′,总权重均为 8;X 中的边没有被删掉。
练习 5.6:设 G=(V,E) 为无向图。证明:若所有边的权重互不相同,则它的最小生成树唯一。
本题考查最小生成树的交换论证,以及不同边权如何把非严格不等式加强为严格不等式。
在存在生成树的前提下,反设 T1=T2 是两棵 MST。取它们边集的对称差中权重最小的边
e=argg∈E(T1)△E(T2)minw(g).
不妨设 e∈E(T1)∖E(T2)。在 T2 中加入 e,得到唯一环 C。若 C−{e} 的边全部属于 T1,则 T1 也包含环 C,矛盾。因此存在
f∈(E(C)−{e})∩(E(T2)∖E(T1)).
e,f 均在对称差中,且权重互不相同,故
w(e)<w(f).
令 T′=T2+{e}−{f},则 T′ 仍是生成树,且
w(T′)=w(T2)+w(e)−w(f)<w(T2),
与 T2 的最优性矛盾。因此 MST 唯一。
练习 5.10:设 T 是图 G 的一棵最小生成树,H 是 G 的连通子图。证明:T∩H 包含于 H 的某棵最小生成树。
本题考查树的基本割与基本环,以及保持已有树边的交换论证;子图内允许存在多棵 MST。
记
F=E(T)∩E(H).
在 H 的所有 MST 中选取一棵 S,使 ∣E(S)∩F∣ 最大。这样的 S 存在,因为 H 连通且图有限。反设 F⊈E(S),取
e={u,v}∈F∖E(S).
删去 T 中的 e 后,得到两个顶点集为 A,B 的连通分量,其中 u∈A、v∈B。S 中的唯一 u→v 路径必有一条边 f 跨越割 (A,B)。
由于 T 中唯一跨越该割的边是 e,且 e∈/S,所以
f∈E(S)∖E(T),f∈/F.
T−{e}+{f} 是 G 的生成树,由 T 的最优性,
w(T)≤w(T)−w(e)+w(f),w(e)≤w(f).
另一方面,f 位于 S+{e} 的唯一环上,因此
S′=S+{e}−{f}
是 H 的生成树,且
w(S′)=w(S)+w(e)−w(f)≤w(S).
因为 S 已是 H 的 MST,只能有 w(S′)=w(S),所以 S′ 也是 H 的 MST。然而
∣E(S′)∩F∣=∣E(S)∩F∣+1,
与 S 的选择矛盾。因此
F⊆E(S),
即 T∩H 包含于 H 的某棵 MST。
Kruskal
Kruskal 算法把边按权重从小到大处理。若一条边不会使已选边成环,就加入;否则跳过。算法从若干孤立顶点开始,不断合并不同的连通分量。
算法:KRUSKAL(G,w)输入: 连通无向图及边权for u∈V do MAKESET(u)X=∅按权重非递减排序全部边for (u,v)∈E,按排序顺序 doif FIND(u)=FIND(v) thenX=X∪{(u,v)}UNION(u,v)if ∣X∣=∣V∣−1 then breakreturn X
判断能否加入边,等价于判断两个端点是否属于不同的当前分量,这可用后文的并查集实现。
正确性仍由割性质给出。初始空集可以扩展成 MST。考虑算法接受的边 e=(u,v),令 S 为当前包含 u 的连通分量;X 没有跨过该割的边。此时 e 是一个最轻跨割边:若有更轻的跨割边,它应已被扫描;而两个端点现在仍在不同分量,说明更早时也在不同分量,这条边本应被接受,产生矛盾。故加入 e 安全。最终选出 n−1 条不成环的边,得到一棵 MST。
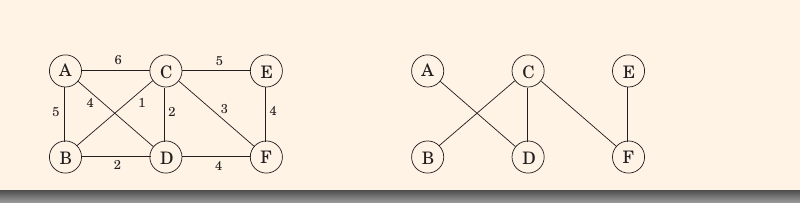
课件给出的扫描顺序为 BC,CD,BD,CF,DF,EF,AD,AB,CE,AC,同权边的顺序可以不同。逐条处理为:
| 边 |
权重 |
操作与原因 |
| BC |
1 |
加入,合并 B,C |
| CD |
2 |
加入,把 D 接入分量 |
| BD |
2 |
跳过,B,C,D 已连通 |
| CF |
3 |
加入,把 F 接入分量 |
| DF |
4 |
跳过,D,F 已有路径 |
| EF |
4 |
加入,把 E 接入分量 |
| AD |
4 |
加入,把 A 接入分量 |
| AB,CE,AC |
5、5、6 |
若继续扫描,都会成环;可提前停止 |
输出 {BC,CD,CF,EF,AD},总权重为 1+2+3+4+4=14。同权边可能产生其他最小生成树,最优总权重不变。
并查集
并查集维护若干互不相交的集合。MAKESET(x) 创建单元素集合;FIND(x) 返回所在集合的代表;UNION(x,y) 合并两个元素所在的集合。代表不同就表示集合不同。
课件把每个集合存成一棵带父指针的树,根的父指针指向自己,根即集合代表。这里的树是数据结构中的父指针树,不是原图中的生成树,两者的边没有对应要求。
按秩合并使较矮的树挂到较高树的根下;只有两棵等高树合并时,新根的秩才加 1。以下版本不使用路径压缩,秩可以按树高理解:
算法:MAKESET(x)parent[x]=x, rank[x]=0算法:FIND(x)while parent[x]=x do x=parent[x]return x算法:UNION(x,y)r=FIND(x), s=FIND(y)if r=s then returnif rank[r]<rank[s] then parent[r]=selse if rank[r]>rank[s] then parent[s]=relse parent[r]=s, rank[s]=rank[s]+1
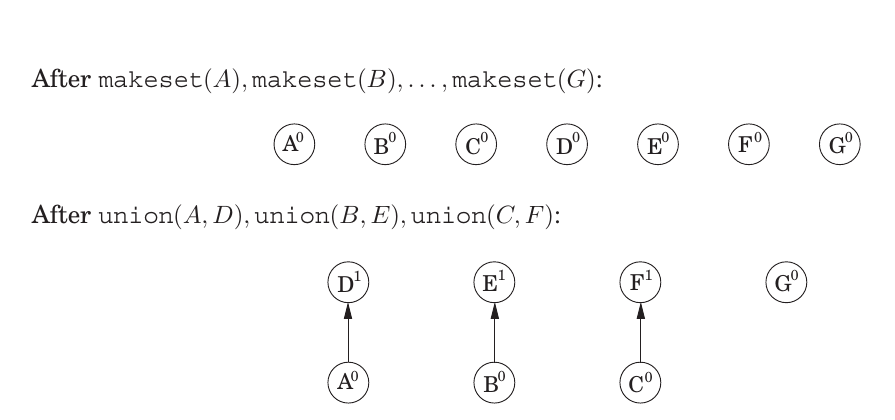
MAKESET 后 A 到 G 各自成树,秩均为 0。依次 UNION(A,D)、UNION(B,E)、UNION(C,F),可按图中的平局选择,让 D,E,F 分别为根,秩均变为 1。
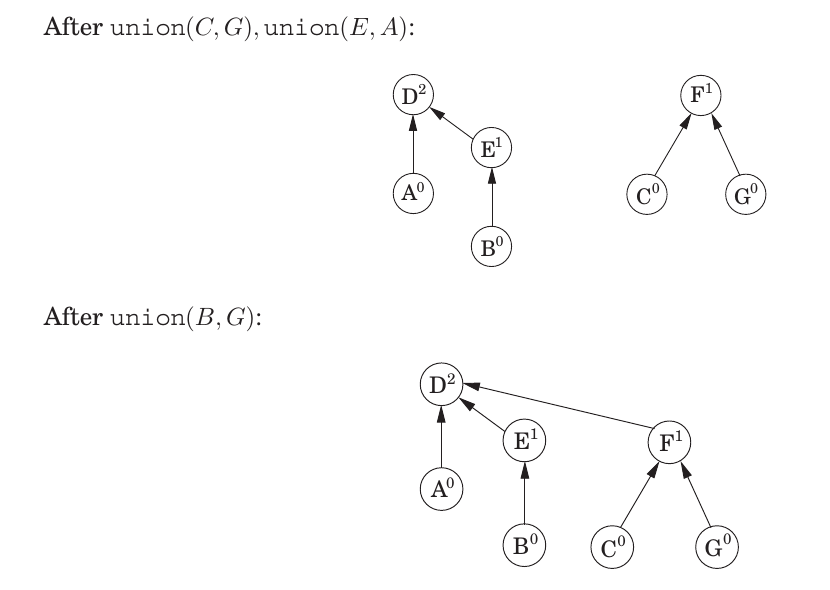
UNION(C,G) 先找到 C 的代表 F,将 G 挂到 F 下,F 的秩不变。UNION(E,A) 合并代表 E 和 D,两者秩相等,选 D 为新根后其秩变为 2。最后 UNION(B,G) 合并代表 D 与 F,将秩为 1 的 F 挂到秩为 2 的 D 下,全部元素归为一个集合。
秩为 r 的根至少含 2r 个元素:秩增加只能由两棵同秩树合并产生,规模至少翻倍。因此树高至多 ⌊log2n⌋,FIND、UNION 都花 O(logn) 时间。Kruskal 执行 n 次 MAKESET、每条边两次 FIND,以及至多 n−1 次 UNION;若 UNION 内部再次查根,也只是增加同阶操作。
加上排序,时间为 O(mlogm+(m+n)logn)。对连通简单图,n−1≤m=O(n2),通常写成 O(mlogn)。路径压缩还可进一步优化并查集,但不是课件这一版按秩合并所必需的步骤。
Prim
割性质还给出一个通用框架:从空边集开始,每轮选择一个不切断当前边集的割,加入一条最轻跨割边,直到选出 n−1 条边。Prim 算法把这个框架具体化:已选边始终构成一棵树,S 取为树中顶点的集合,每次把一个新顶点接入。
对尚未加入 S 的顶点 v,定义
cost[v]=u∈Sminw(u,v),
没有相应边时为 ∞。每次取 cost 最小的顶点,相当于选择最轻跨割边。初始化时任选根 s,令 cost[s]=0,从它开始长树。
算法:PRIM(G,w)for v∈V do cost[v]=∞, prev[v]=nil任选根 s, cost[s]=0H=MAKEQUEUE(V,cost)while H=∅ dov=DELETEMIN(H)if cost[v]=∞ then 报告图不连通并终止for (v,z)∈E 的邻接边 doif z∈H 且 cost[z]>w(v,z) thencost[z]=w(v,z), prev[z]=vDECREASEKEY(H,z)return {(prev[v],v):v=s}
课件更新语句写成了 cost(v)=w(v,z),但被降低的键应属于候选顶点 z,故这里改为 cost[z]=w(v,z),并明确只更新仍在队列中的顶点。连通图不会触发不连通分支。
在前面的 Kruskal 算例上从 A 运行 Prim,一种处理顺序是 A,D,B,C,F,E。接入边依次为 AD:4、DB:2、BC:1、CF:3、FE:4,总权重也是 14。它用 BD 替代了此前 Kruskal 输出中的同权边 CD,展示了 MST 可以不唯一。
每次接入边都符合割性质,故始终可以扩展成 MST;连通条件保证最终接入全部顶点,得到最优树。与上一讲的 Dijkstra 一样,数组实现需 O(n2+m) 时间,二叉堆为 O((n+m)logn),Fibonacci 堆为均摊 O(m+nlogn)。
两种键值
Prim 与 Dijkstra 的控制流程很相似,课件并列其伪代码作比较;它们维护的键值及求解目标不同。
| 比较项 |
Prim |
Dijkstra |
| 目标 |
所有顶点连通,树的总权重最小 |
源点到各顶点的距离最短 |
| 候选键值 |
接入当前树的一条边的最小权重 |
从源点出发的最短候选距离 |
| 更新候选值 |
w(u,v) |
dist[u]+w(u,v) |
| 边权条件 |
可正、可零、可负 |
要求非负 |
| 正确性依据 |
割性质 |
非负边下的最短路确定性质 |
例如三角形 AB:2、AC:3、BC:2。Prim 从 A 出发会选择 AB,BC,树总权重为 4;Dijkstra 为使 A 到 C 的距离为 3,会用直接边 AC,与 AB 组成的最短路树总权重为 5。最短路树不必是 MST。
红蓝规则
课件思考:反复使用红、蓝染色规则,为什么最后蓝边构成 MST?
红规则:在没有红边的环上,把一条尚未染色、权重最大的候选边染红。蓝规则:在没有蓝边跨越的割上,把一条尚未染色、权重最小的候选边染蓝。任选可执行规则,直到全部边染色。
保持同一个不变量:存在一棵 MST T,包含全部蓝边且不包含任何红边。初始显然成立。
对蓝规则,若新边不在 T 中,加入后形成的环上有另一条跨割边。它不是蓝边,因为该割没有蓝边;也不是红边,因为它在 T 中,因此尚未染色。新蓝边不比它重,交换后仍可选择一棵满足不变量的 MST。
对红规则,若新红边不在 T 中,无须改变 T。若它在 T 中,先将它从 T 删除,得到一个割;原环上必有另一条边跨越这个割且不属于 T。它不是蓝边,又因环中没有红边而未染色;其权重不大于被染红的候选边。用它替换新红边,仍得到最优树,并保留所有旧蓝边。
算法也不会在仍有未染色边时无规则可用:若一条未染色边的端点已由蓝边相连,可沿蓝路径组成无红边的环;否则取其一端所在的蓝色连通分量作割,该割没有蓝边且有未染色边。每一步至少染一条边,有限步后结束。此时满足不变量的 MST 只能由蓝边组成,而全部蓝边又已在这棵树中,因此蓝边恰好构成 MST。
平权时,“环上最重边”不一定被所有 MST 排除。染色规则保证存在与已作选择相容的 MST;不能据此断言每条红边都不属于任何最优树。
集合覆盖
课件的第二个问题是学校选址:每所学校必须位于一个城镇,每个城镇到某所学校的距离不能超过 30 英里,目标是学校数最少。对每个城镇 x,令 Sx 包含它自己和与它相距不超过 30 英里的城镇;在 x 建校就覆盖 Sx。
这得到集合覆盖问题:给定元素全集 B 和子集 S1,…,Sm⊆B,选择尽可能少的子集,使其并集等于 B。这里所有集合的选择成本均为 1。若全部集合的并集都不能覆盖 B,则没有可行解。
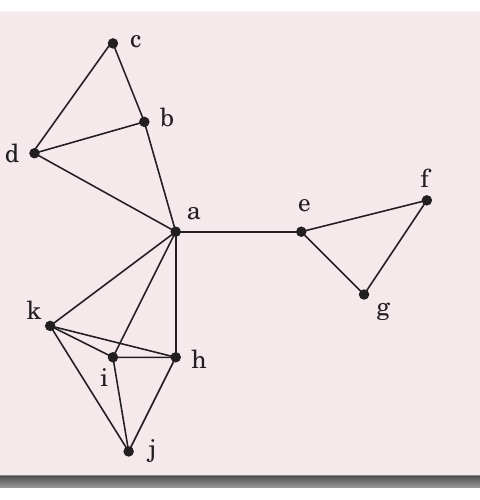
图中顶点为城镇 a 到 k,边表示两个城镇相距不超过 30 英里。覆盖只看这个距离条件:a 与 b 相邻、b 与 c 相邻,不意味着在 a 建校也能覆盖 c。
贪心规则是每次选择能覆盖最多尚未覆盖元素的集合,而不是每轮都比较集合原本的大小。
算法:GREEDY-SET-COVER(B,S1,…,Sm)R=B, I=∅while R=∅ do选择使 ∣Si∩R∣ 最大的 iif ∣Si∩R∣=0 then return 无解I=I∪{i}, R=R∖Sireturn I
若存在可行覆盖,每轮至少删除一个未覆盖元素,算法一定终止。直接实现可在每轮检查全部集合及其成员,比较新增覆盖数;若成员出现总次数为 L=∑i∣Si∣,最多 ∣B∣ 轮,时间为 O(∣B∣(m+L)),不需要枚举所有集合组合。
课件图中 Sa={a,b,d,e,h,i,k} 有 7 个元素,第一轮选择它。此后未覆盖的是 c,f,g,j,可选择 Se 同时覆盖 f,g,再分别选择 Sb 覆盖 c、Sk 覆盖 j,共选 4 个集合。
但三个集合已足够:
SbSeSk={a,b,c,d},={a,e,f,g},={a,h,i,j,k}.
它们覆盖全部 11 个城镇。并且没有一个候选集合能同时覆盖 c,f,j 中的任意两个,因此至少需要 3 个集合,最优值恰为 3。这个例子说明贪心选择可能超过最优,但下面仍可限制它的最坏表现。
近似保证
记 n=∣B∣,最优覆盖用了 k=OPT 个集合。令 nt 是贪心选择 t 个集合后仍未覆盖的元素数,初始 n0=n。
剩余元素仍被那 k 个最优集合覆盖。因此其中至少一个集合包含不少于 nt/k 个剩余元素,否则这些集合的并也不足以覆盖剩余元素。贪心选择的集合至少一样好,所以
nt+1≤nt(1−k1).
重复使用,得到 nt≤n(1−1/k)t。利用 1−x≤e−x,当 k>1、t>0 时可进一步得到严格上界
nt<ne−t/k.
取整数轮数 t=⌈klnn⌉,在 n≥2 时,右侧不超过 1,而 nt 是非负整数且严格小于 1,所以它只能为 0。若 k=1,贪心第一轮就能覆盖全部元素;若 n=1,可行实例同样只需一个集合。
课件将这个界简记为“至多 OPTlnn 个集合”。严格计数需要处理轮数取整和小规模情形,不能对 n=1 直接代入 ln1=0。一个对所有非空可行实例都成立的标准写法是
OPTGREEDY≤Hn≤1+lnn,
其中 Hn=1+1/2+⋯+1/n。这里的比值是最小化问题中的近似比,越接近 1 越好。
Hn 界也可用分摊法证明:每次选一个集合,把它的单位成本平均分给本次新覆盖的 r 个元素,每个元素分到 1/r。全部元素的费用总和就是贪心选集数。
观察任一最优集合 S。当其中还剩 q 个元素未覆盖时,贪心本次至少能新覆盖 q 个元素,因为 S 本身就是一个候选,所以此时覆盖的元素费用至多为 1/q。按 S 中元素被覆盖的先后求和,总费用至多为 H∣S∣≤Hn;同一轮覆盖多个元素也满足这个界。对最优覆盖的 OPT 个集合求和,至少计算了每个元素一次,因此贪心总费用不超过 OPTHn。
零钱兑换
给定面值 0<c1<⋯<ck,每种面值可使用任意多枚硬币。对非负整数金额 x,目标是恰好凑出 x,并使硬币总数最少。课件的收银员算法每次取不超过剩余金额的最大面值。
算法:CASHIERS-ALGORITHM(x,c1,…,ck)将面值按递增顺序排序,令 S=[ ]while x>0 doj=满足 cj≤x 的最大下标if 不存在这样的 j then return 贪心过程失败x=x−cj将一枚面值为 cj 的硬币追加到 Sreturn S
课件用集合并的符号记录硬币,但同一面值可以重复出现,实际应使用列表、多重集合或每种面值的枚数。对任意面值,“贪心过程失败”也不能直接解释为原问题无解,后面的反例会说明这一点。
以面值 {1,5,10,25,100} 为例,统一以美分计价。课件的 2.89 美元是 289 美分,贪心分解为
289=2⋅100+3⋅25+10+4⋅1,
共 10 枚。课件另一个示例写作 34 美元,按同样的单位应转换为 3400 美分,使用 34 枚 100 美分硬币;若讨论数值 34 美分,则为 25+5+1+1+1+1,共 6 枚,不能混用金额单位。
实现时不必逐枚选择。可从最大面值向下扫描,每种面值一次取 ⌊x/ci⌋ 枚,再对 x 取余。若只返回各面值的枚数,面值排序后只需 O(k) 次除法;若逐枚输出,则还要计入输出硬币的数量。
Quiz 与反例
Quiz:收银员算法是否最优?
A. 是,因为贪心算法总是最优。
B. 是,只要最小面值为 1,对任意面值都最优。
C. 是,因为这里的美国硬币面值具有特殊性质。
D. 否。
针对前文的面值 {1,5,10,25,100},答案为 C。A 把一种方法误当成了普遍的正确性保证,B 也被下面的反例否定。D 不适用于这组特定面值,但对任意面值不能保证贪心最优。
课件的邮资面值为 {1,10,21,34,70,100,350,1225,1500}。对金额 140,贪心先取 100、34,再取六个 1,共 8 枚;最优方案只需 70+70 两枚。最小面值为 1 仅保证任何整数金额都可凑出,不保证硬币数最少。
若最小面值大于 1,贪心甚至可能在有解时失败。面值 {7,8,9}、金额 15,贪心取 9 后剩 6,无面值可选;但 7+8=15 是可行方案。因此算法的失败分支只说明当前贪心选择无法继续。
美分制证明
为什么面值 {1,5,10,25,100} 恰好允许贪心?课件先限制任意最优解中小面值硬币的数量。记 1、5、10、25 美分硬币数分别为 P,N,D,Q。
| 任意最优解的性质 |
交换理由 |
| P≤4 |
五枚 1 可换为一枚 5 |
| N≤1 |
两枚 5 可换为一枚 10 |
| Q≤3 |
四枚 25 可换为一枚 100 |
| N+D≤2 |
三枚 10 可换为 25 和 5;两枚 10 加一枚 5 可换为一枚 25 |
若违背其中一条,就能以更少硬币表示相同金额,与最优性矛盾。最后一条使用 N≤1:若 N+D≥3,要么有至少三枚 10,要么有一枚 5 和至少两枚 10,恰好分别应用表中的两个交换。
由这些限制,可以算出最优解中小于某面值的硬币,总共最多能表示多少金额:
| 当前面值 ci |
更小面值在最优解中的最大总额 |
| 1 |
0 |
| 5 |
4 |
| 10 |
4+5=9 |
| 25 |
20+4=24 |
| 100 |
75+24=99 |
例如小于 25 的面值中,5 和 10 合计最多两枚,最大价值为两枚 10;加至多四枚 1,共 24。小于 100 时,再加至多三枚 25,最大价值是 99。
现在对金额作强归纳。x=0 时空方案最优。对 x>0,令 ci 为不超过 x 的最大面值,即 ci≤x<ci+1;最大面值的情形把上界理解为无穷。
任意最优解不能使用大于 x 的面值。若它也不使用 ci,就只能使用更小面值,但表中证明这些硬币的总额至多为 ci−1<x,无法凑出 x。因此某枚 ci 必须存在,这正是贪心第一步选择。
删去这枚硬币后,剩下的方案必须是金额 x−ci 的最优方案,否则替换为更优的剩余方案就能改进原解。由归纳假设,贪心能最优地处理 x−ci,所以也能最优地处理 x。这完成了课件的最优性证明。
方法对比
| 问题 |
贪心选择 |
能保证什么 |
证明依据 |
| Kruskal |
最轻且不成环的边 |
MST 精确最优 |
割性质、交换论证 |
| Prim |
当前树的最轻跨割边 |
MST 精确最优 |
割性质 |
| 集合覆盖 |
覆盖最多剩余元素的集合 |
Hn 近似 |
平均覆盖量、费用分摊 |
| 美分制兑换 |
最大可用面值 |
指定面值下精确最优 |
小面值数量限制、归纳 |
| 任意面值兑换 |
最大可用面值 |
无一般最优保证 |
140 与 15 的反例 |
相同的“每步选当前最好”形式,可以得到精确算法、近似算法或错误算法。要判断结果,应把局部选择如何约束剩余问题写清楚,再给出相应的最优性或近似比证明。
