概率基础
基本概念
随机实验与样本空间 :随机实验的所有可能结果的集合称为 样本空间 Ω \Omega Ω 基本结果 Outcomes 。
事件 :样本空间的子集 。
概率公理 :概率 P ( E ) P(E) P ( E ) [ 0 , 1 ] [0,1] [ 0 , 1 ]
必然事件的概率 P ( Ω ) = 1 P(\Omega) = 1 P ( Ω ) = 1
非负性 P ( A ) ≥ 0 P(A) \ge 0 P ( A ) ≥ 0
可加性 P ( A ∪ B ) = P ( A ) + P ( B ) P(A \cup B) = P(A) + P(B) P ( A ∪ B ) = P ( A ) + P ( B ) A ∩ B = ∅ A \cap B = \emptyset A ∩ B = ∅
随机变量 :将样本空间映射到可测空间的函数 。
常见分布
高斯分布 :N ( x ∣ μ , σ 2 ) = 1 2 π σ 2 exp [ − ( x − μ ) 2 2 σ 2 ] \mathcal{N}(x|\mu,\sigma^2) = \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left[-\frac{(x-\mu)^2}{2\sigma^2}\right] N ( x ∣ μ , σ 2 ) = 2 π σ 2 1 exp [ − 2 σ 2 ( x − μ ) 2 ] μ \mu μ σ 2 \sigma^2 σ 2 均匀分布 :离散情况下各结果概率相等,连续情况下在区间 [a,b] 内概率密度恒为 1 b − a \frac{1}{b-a} b − a 1 伯努利分布 :描述单次二元实验,变量 X ∼ B e r ( θ ) X \sim Ber(\theta) X ∼ B er ( θ ) θ \theta θ 1 − θ 1-\theta 1 − θ 二项分布 :描述 n n n k k k B i n ( X = k ∣ n , θ ) = ( n k ) θ k ( 1 − θ ) n − k Bin(X=k|n,\theta) = \binom{n}{k} \theta^k (1-\theta)^{n-k} B in ( X = k ∣ n , θ ) = ( k n ) θ k ( 1 − θ ) n − k
统计量
数学期望 :变量值的概率加权平均,反映分布的中心位置,μ = E [ X ] = ∑ x i ∈ X x i P ( X = x i ) \mu = E[X] = \sum_{x_i \in X} x_i P(X=x_i) μ = E [ X ] = ∑ x i ∈ X x i P ( X = x i ) 方差 :变量偏离期望的平方的期望,反映分布的离散程度,σ 2 = E [ ( X − μ ) 2 ] = ∑ x i p ( x i ) ⋅ ( x i − E [ X ] ) 2 \sigma^2 = E[(X-\mu)^2] = \sum_{x_i} p(x_i) \cdot (x_i - E[X])^2 σ 2 = E [( X − μ ) 2 ] = ∑ x i p ( x i ) ⋅ ( x i − E [ X ] ) 2 σ 2 = 1 N − 1 ∑ i = 1 n ( x i − μ ) 2 \sigma^2 = \frac{1}{N-1} \sum_{i=1}^n (x_i - \mu)^2 σ 2 = N − 1 1 ∑ i = 1 n ( x i − μ ) 2
联合分布
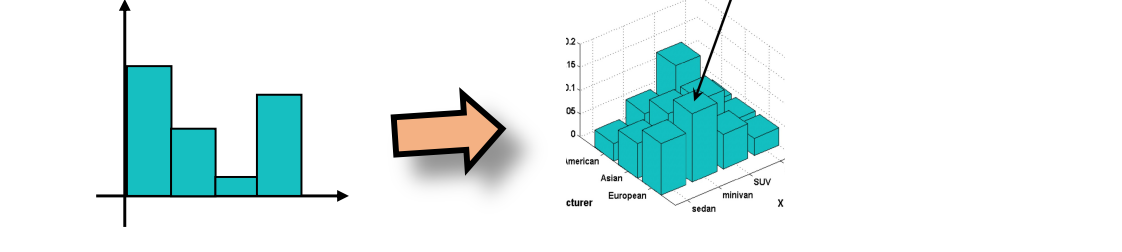
联合概率分布 :定义在多个变量状态空间笛卡尔积上的概率函数,包含变量间关系的全貌 。边缘化 :通过对联合分布中不需要的变量求和,提取目标变量的边缘概率分布,P ( Y ) = ∑ Z P ( X 1 , X 2 , … , X n ) P(Y) = \sum_Z P(X_1, X_2, \dots, X_n) P ( Y ) = ∑ Z P ( X 1 , X 2 , … , X n ) 条件概率 :已知事件 B B B A A A P ( A ∣ B ) = P ( A , B ) P ( B ) P(A|B) = \frac{P(A,B)}{P(B)} P ( A ∣ B ) = P ( B ) P ( A , B ) 独立性 :若事件 A A A B B B A A A B B B P ( A ∩ B ) = P ( A ) P ( B ) P(A \cap B) = P(A)P(B) P ( A ∩ B ) = P ( A ) P ( B ) 条件独立性 :在给定变量 Z Z Z X X X Y Y Y P ( X , Y ∣ Z ) = P ( X ∣ Z ) P ( Y ∣ Z ) P(X,Y|Z) = P(X|Z)P(Y|Z) P ( X , Y ∣ Z ) = P ( X ∣ Z ) P ( Y ∣ Z ) 链式法则 :任何联合分布都可以分解为条件概率的连乘:P ( X 1 , … , X n ) = P ( X 1 ) P ( X 2 ∣ X 1 ) … P ( X n ∣ X 1 , … , X n − 1 ) P(X_1, \dots, X_n) = P(X_1)P(X_2|X_1)\dots P(X_n|X_1, \dots, X_{n-1}) P ( X 1 , … , X n ) = P ( X 1 ) P ( X 2 ∣ X 1 ) … P ( X n ∣ X 1 , … , X n − 1 )
贝叶斯定理
在贝叶斯框架下,推断是对未知假设 H H H E E E
先验概率 Prior Probability P ( H ) P(H) P ( H ) :在观测证据前对假设的初始“信念”,这个值来自对事件发生概率的主观判断或历史经验。以发病率为例,H H H P ( H ) P(H) P ( H ) 人群中的自然发病率 。似然 Likelihood L ( H ∣ E ) = P ( E ∣ H ) L(H|E) = P(E|H) L ( H ∣ E ) = P ( E ∣ H ) :给定假设 H H H E E E E E E P ( E ∣ H ) P(E|H) P ( E ∣ H ) 发病情况下测出阳性的概率 ;化验这一证据的可信度,即已经测出阳性时反推到发病的可信度 ,就是似然 L ( E ∣ H ) L(E|H) L ( E ∣ H ) 后验概率 Posterior Probability P ( H ∣ E ) P(H|E) P ( H ∣ E ) :结合证据后更新的信念。也就是化验阳性后真正得病的概率 。
贝叶斯定理 是更新“信念”的运算核心,即后验概率正比于先验与似然的乘积:
P ( H ∣ E ) = P ( H ) P ( E ∣ H ) P ( E ) ∝ P ( H ) L ( H ∣ E ) P(H|E) = \frac{P(H)P(E|H)}{P(E)} \propto P(H)L(H|E)
P ( H ∣ E ) = P ( E ) P ( H ) P ( E ∣ H ) ∝ P ( H ) L ( H ∣ E )
贝叶斯网络
当系统涉及数十个甚至数百个随机变量时,直接构建联合概率表会遭遇维度灾难。对于 N N N 2 N 2^N 2 N
贝叶斯网络/概率图模型 通过引入领域知识中的条件独立性,将联合分布进行紧凑化表示 :
定义 :由一个有向无环图和一组条件概率表构成。图中节点代表随机变量,有向边代表变量间的因果依赖 。
局部马尔可夫性质 :每个节点在给定其父节点的情况下,与所有非后代节点条件独立。全局联合分布可以分解为局部条件概率的乘积:
P ( X 1 , X 2 , … , X n ) = ∏ i = 1 n P ( X i ∣ P a r e n t s ( X i ) ) P(X_1, X_2, \dots, X_n) = \prod_{i=1}^n P(X_i | Parents(X_i))
P ( X 1 , X 2 , … , X n ) = i = 1 ∏ n P ( X i ∣ P a re n t s ( X i ))
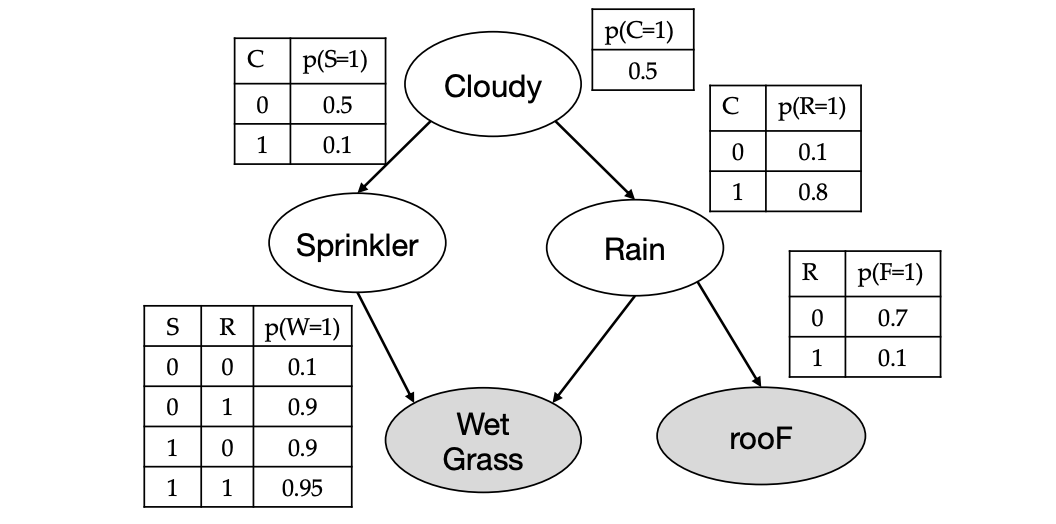
【例 1 】给定下图网络:
自顶向下写,得到:P ( C , S , R , W , F ) = P ( C ) P ( S ∣ C ) P ( R ∣ C ) P ( W ∣ S , R ) P ( F ∣ R ) P(C, S, R, W, F) = P(C)P(S|C)P(R|C)P(W|S,R)P(F|R) P ( C , S , R , W , F ) = P ( C ) P ( S ∣ C ) P ( R ∣ C ) P ( W ∣ S , R ) P ( F ∣ R )
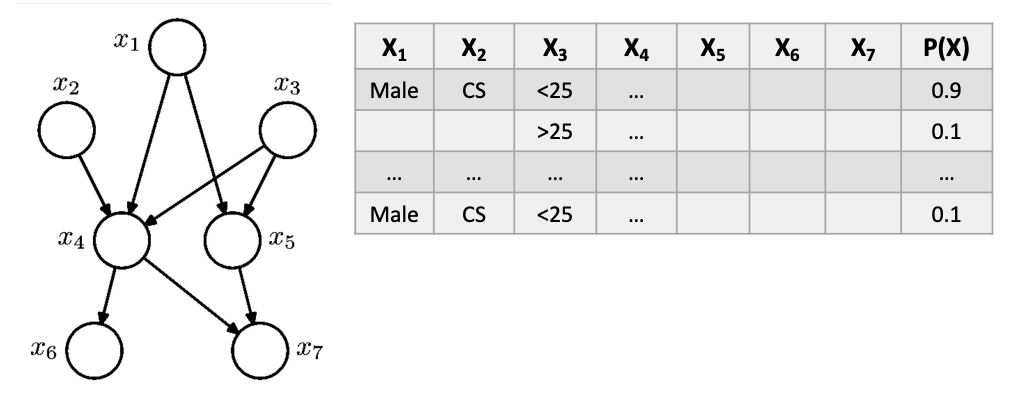
【例2 】给定下图网络:
p ( x 1 , x 2 , x 3 , x 4 , x 5 , x 6 , x 7 ) = p ( x 1 ) p ( x 2 ) p ( x 3 ) p ( x 4 ∣ x 1 , x 2 , x 3 ) p ( x 5 ∣ x 1 , x 3 ) p ( x 6 ∣ x 4 ) p ( x 7 ∣ x 4 , x 5 ) p(x_1, x_2, x_3, x_4, x_5, x_6, x_7) = p(x_1)p(x_2)p(x_3)p(x_4|x_1, x_2, x_3)p(x_5|x_1, x_3)p(x_6|x_4)p(x_7|x_4, x_5) p ( x 1 , x 2 , x 3 , x 4 , x 5 , x 6 , x 7 ) = p ( x 1 ) p ( x 2 ) p ( x 3 ) p ( x 4 ∣ x 1 , x 2 , x 3 ) p ( x 5 ∣ x 1 , x 3 ) p ( x 6 ∣ x 4 ) p ( x 7 ∣ x 4 , x 5 )
信息论
信息的度量
定义一个 事件 Event ,其有若干种 状态 States 。对于有两个状态的事件,只需要 1 bit 来编码两个不同的状态,即 0 和 1;有四个状态时,用 2 bit 编码,对应二进制的 0,1,2,3 四个数字;以此类推,对于有 M M M l o g 2 M log_2M l o g 2 M N N N N l o g 2 M Nlog_2M Nl o g 2 M
如果一个事件经常发生(概率高),其带来的信息量较低 。
如果一个事件极少发生(概率低),其发生时带来的信息量较高 。
重复接收相同的消息不会带来新的信息 。
定义香农信息量 用于量化单一事件的信息量。对于发生概率为p p p S I C = l o g 2 1 p SIC = log_{2}\frac{1}{p} S I C = l o g 2 p 1
熵
熵 Entropy 用来衡量随机变量概率分布不确定性,定义为分布中所有可能事件香农信息量的数学期望 。对于具有离散取值状态 { x 1 , ⋅ ⋅ ⋅ , x M } \{x_{1}, \cdot\cdot\cdot, x_{M}\} { x 1 , ⋅ ⋅ ⋅ , x M } ( p 1 , ⋅ ⋅ ⋅ , p M ) (p_{1}, \cdot\cdot\cdot, p_{M}) ( p 1 , ⋅ ⋅ ⋅ , p M ) X X X H ( X ) H(X) H ( X ) H ( X ) = E { l o g 2 1 p ( X ) } = − ∑ x ∈ X p ( x ) l o g 2 p ( x ) H(X) = \mathbb{E}\{log_{2}\frac{1}{p(X)}\} = -\sum_{x\in\mathcal{X}}p(x)log_{2}p(x) H ( X ) = E { l o g 2 p ( X ) 1 } = − ∑ x ∈ X p ( x ) l o g 2 p ( x )
熵衡量了我们对系统输出结果的缺乏了解程度,熵越高表示系统越不确定 。
均匀分布产生最大的不确定性,对应最大的熵(例如公平硬币投掷的熵为1 bit) 。
非均匀分布的不确定性较小,对应的熵也较低(例如不公平硬币的熵小于1 bit) 。
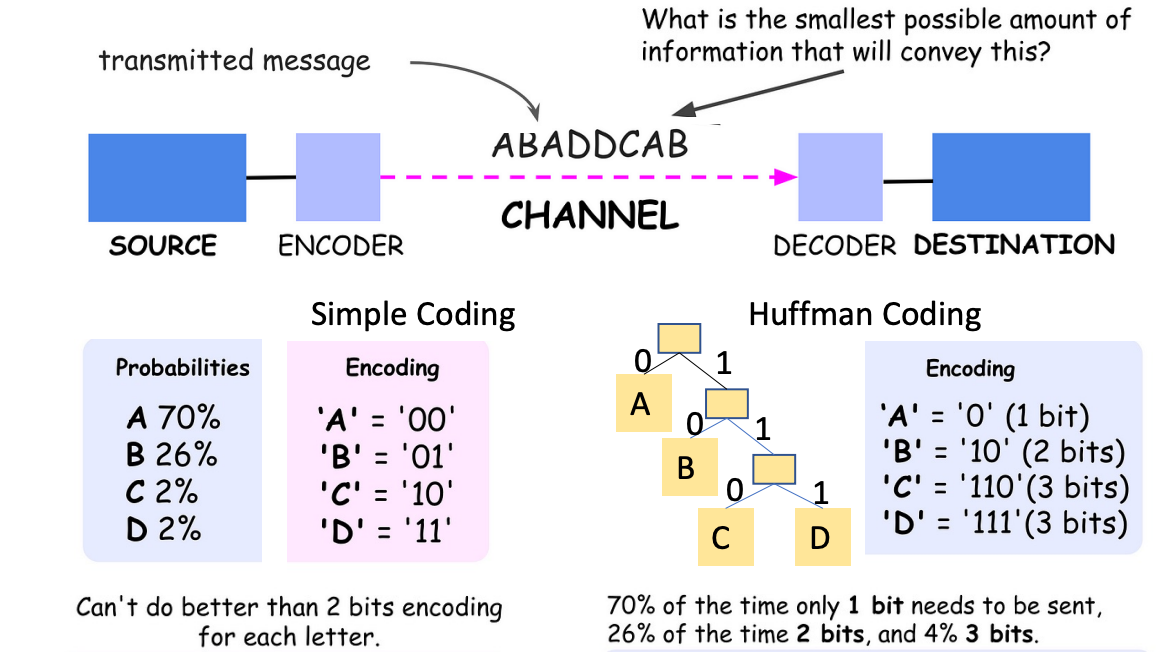
霍夫曼编码通过让出现频率来决定编码长度来降低需要的比特数,提高空间利用效率:
简单按字母种类数编码的信息量:L s i m p l e = 0.70 × 2 + 0.26 × 2 + 0.02 × 2 + 0.02 × 2 = 2 L_{simple} = 0.70 \times 2 + 0.26 \times 2 + 0.02 \times 2 + 0.02 \times 2 = 2 L s im pl e = 0.70 × 2 + 0.26 × 2 + 0.02 × 2 + 0.02 × 2 = 2
给出现概率高的字母短编码,出现概率低的长编码:L h u f f m a n = ( 0.70 × 1 ) + ( 0.26 × 2 ) + ( 0.02 × 3 ) + ( 0.02 × 3 ) = 1.34 L_{huffman} = (0.70 \times 1) + (0.26 \times 2) + (0.02 \times 3) + (0.02 \times 3) = 1.34 L h u ff man = ( 0.70 × 1 ) + ( 0.26 × 2 ) + ( 0.02 × 3 ) + ( 0.02 × 3 ) = 1.34
霍夫曼编码可以对信息进行无损压缩,从而去逼近信息熵来提高信息传输的效率。
联合熵与条件熵
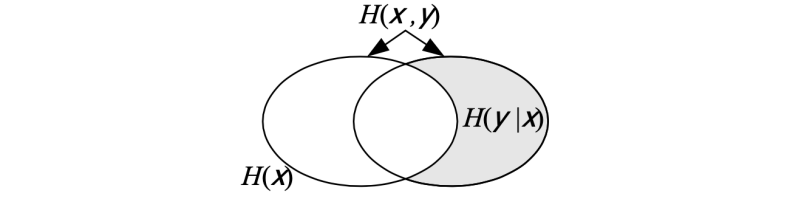
联合熵 Joint Entropy :衡量两个随机变量 X X X Y Y Y H ( X , Y ) = − ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 2 p ( x , y ) H(X,Y) = -\sum_{x\in\mathcal{X}}\sum_{y\in\mathcal{Y}}p(x,y)\log_{2}p(x,y) H ( X , Y ) = − ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 2 p ( x , y )
条件熵 Conditional Entropy :表示在已知变量 X X X Y Y Y H ( Y ∣ X ) = − ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 2 p ( y ∣ x ) H(Y|X) = -\sum_{x\in\mathcal{X}}\sum_{y\in\mathcal{Y}}p(x,y)\log_{2}p(y|x) H ( Y ∣ X ) = − ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 2 p ( y ∣ x )
条件熵可以通过变量 X X X Y Y Y H ( Y ∣ X ) = ∑ x ∈ X p ( x ) H ( Y ∣ X = x ) H(Y|X) = \sum_{x\in\mathcal{X}}p(x)H(Y|X=x) H ( Y ∣ X ) = ∑ x ∈ X p ( x ) H ( Y ∣ X = x )
条件熵满足链式法则,即联合系统的不确定性等于 X X X X X X Y Y Y H ( X , Y ) = H ( X ) + H ( Y ∣ X ) H(X,Y) = H(X) + H(Y|X) H ( X , Y ) = H ( X ) + H ( Y ∣ X )
交叉熵
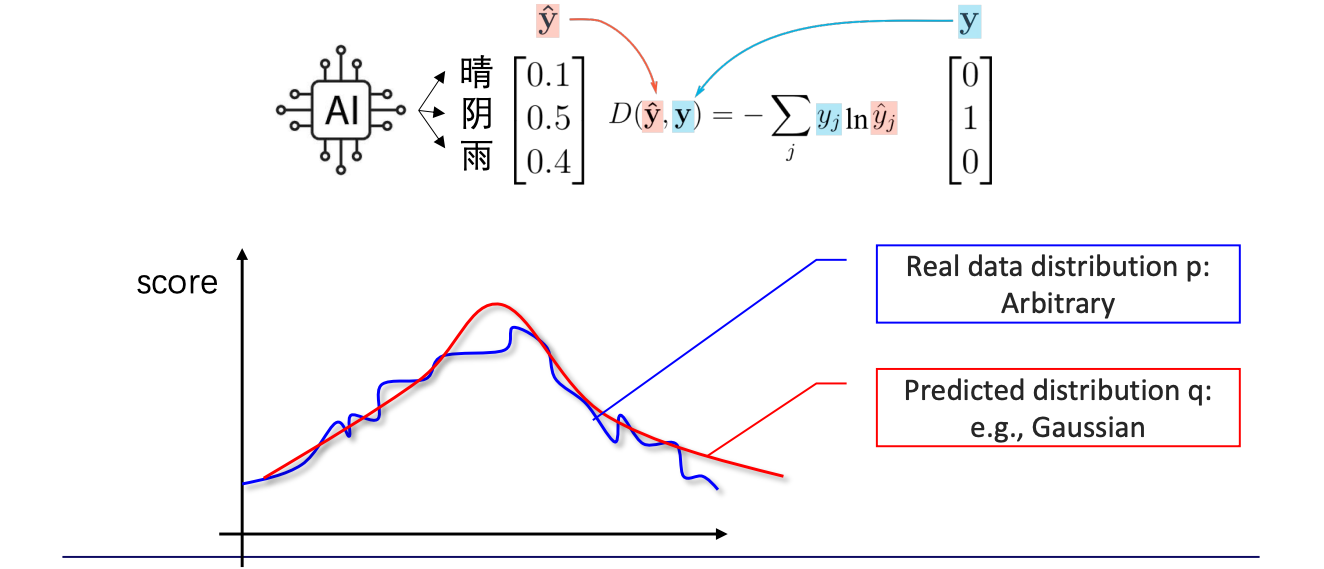
交叉熵 Cross Entropy 度量在真实概率分布为 p p p q q q
C E ( p , q ) = E x ∼ p ( x ) { l o g 1 q ( x ) } = − ∑ x ∈ X p ( x ) log 2 q ( x ) CE(p,q) = \mathbb{E}_{x \sim p(x)}\{log\frac{1}{q(x)}\}= -\sum_{x\in\mathcal{X}}p(x)\log_{2}q(x)
CE ( p , q ) = E x ∼ p ( x ) { l o g q ( x ) 1 } = − x ∈ X ∑ p ( x ) log 2 q ( x )
交叉熵常被用作机器学习分类任务的损失函数。通过最小化交叉熵损失,模型驱动预测分布 q q q p p p
相对熵
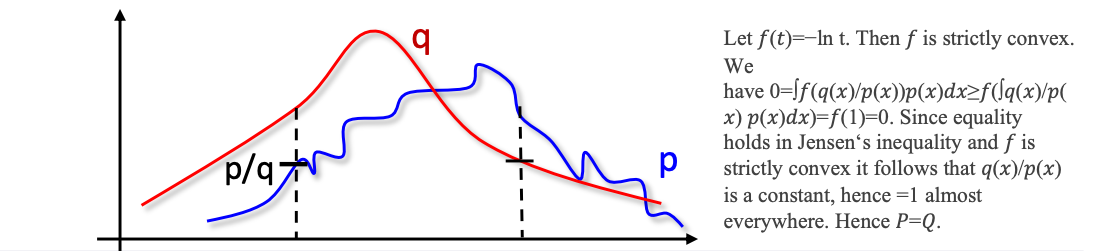
相对熵 Relative Entropy ,即 KL 散度,度量使用非真实分布 q q q p p p
D K L ( p ∣ ∣ q ) = ∑ x ∈ X p ( x ) log 2 p ( x ) q ( x ) D_{KL}(p||q) = \sum_{x\in\mathcal{X}}p(x)\log_{2}\frac{p(x)}{q(x)}
D K L ( p ∣∣ q ) = x ∈ X ∑ p ( x ) log 2 q ( x ) p ( x )
相对熵具有不对称性且恒大于等于 0,当且仅当分布 p p p q q q D K L ( p ∣ ∣ q ) = C E ( p , q ) − H ( p ) D_{KL}(p||q) = CE(p,q) - H(p) D K L ( p ∣∣ q ) = CE ( p , q ) − H ( p )
互信息
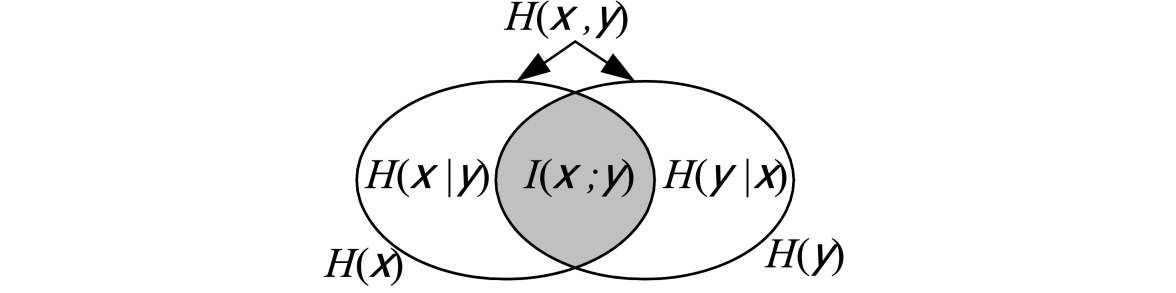
互信息 Mutual Information 衡量一个随机变量包含关于另一个随机变量的信息量,即观测到一个变量后,另一个变量不确定性的减少量 :
I ( X ; Y ) = ∑ x ∈ X ∑ y ∈ Y p ( x , y ) log 2 p ( x , y ) p ( x ) p ( y ) I(X;Y) = \sum_{x\in\mathcal{X}}\sum_{y\in\mathcal{Y}}p(x,y)\log_{2}\frac{p(x,y)}{p(x)p(y)}
I ( X ; Y ) = x ∈ X ∑ y ∈ Y ∑ p ( x , y ) log 2 p ( x ) p ( y ) p ( x , y )
互信息具有对称性,即 I ( X ; Y ) = I ( Y ; X ) I(X;Y) = I(Y;X) I ( X ; Y ) = I ( Y ; X )
I ( X ; Y ) = H ( X ) − H ( X ∣ Y ) = H ( X ) + H ( Y ) − H ( X , Y ) I(X;Y) = H(X) - H(X|Y) = H(X) + H(Y) - H(X,Y)
I ( X ; Y ) = H ( X ) − H ( X ∣ Y ) = H ( X ) + H ( Y ) − H ( X , Y )
决策树分类
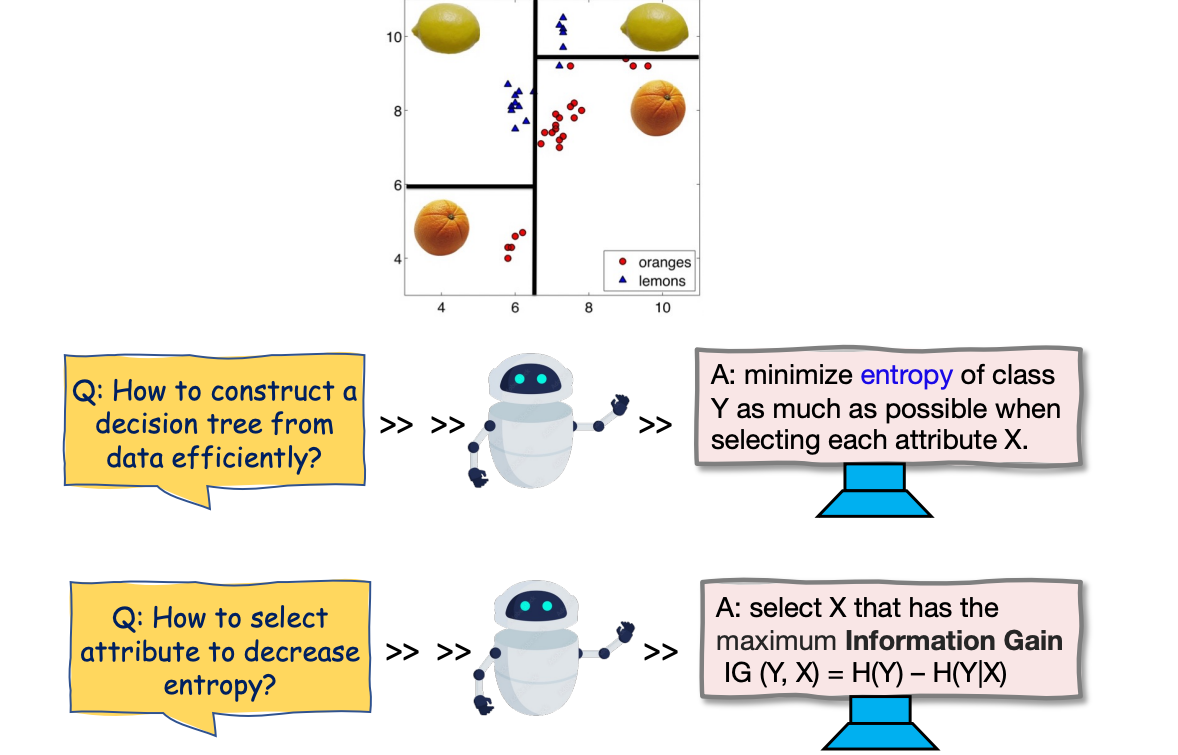
决策树构建的核心在于寻找最佳的特征属性节点进行分裂。最优选择标准是使分类目标变量 Y Y Y 信息增益 Information Gain 。
I G ( Y , X ) = H ( Y ) − H ( Y ∣ X ) IG(Y,X) = H(Y) - H(Y|X)
I G ( Y , X ) = H ( Y ) − H ( Y ∣ X )
信息增益在数学定义上完全等价于目标类别 Y Y Y X X X I ( X ; Y ) I(X;Y) I ( X ; Y )
随机过程
随机过程是一个数学模型,描述系统随时间以随机方式演变的过程 。在数学表达上,随机过程由一系列随机变量 S 1 , S 2 , … , S T S_1, S_2, \dots, S_T S 1 , S 2 , … , S T P [ S t + 1 ∣ S 1 , … , S t ] \mathbb{P}[S_{t+1}|S_1,\dots,S_t] P [ S t + 1 ∣ S 1 , … , S t ]
随机过程可根据时间与状态的连续性分为不同类别。例如,时间离散且状态离散的过程通常称为离散时间马尔可夫链;而时间连续状态离散的过程称为连续时间马尔可夫链。布朗运动则属于时间与状态均连续的维纳过程。
马尔可夫过程
马尔可夫过程 Markov Process 是一类具备马尔可夫性质的特殊随机过程,其性质的核心在于“无后效性”,即在给定当前状态的前提下,系统未来的状态与过去的历史状态独立 。其数学定义与重要公式表示为:对于状态序列 S 1 , S 2 , … , S t S_1, S_2, \dots, S_t S 1 , S 2 , … , S t
P [ S t + 1 ∣ S t ] = P [ S t + 1 ∣ S 1 , … , S t ] \mathbb{P}[S_{t+1}|S_t] = \mathbb{P}[S_{t+1}|S_1, \dots, S_t]
P [ S t + 1 ∣ S t ] = P [ S t + 1 ∣ S 1 , … , S t ]
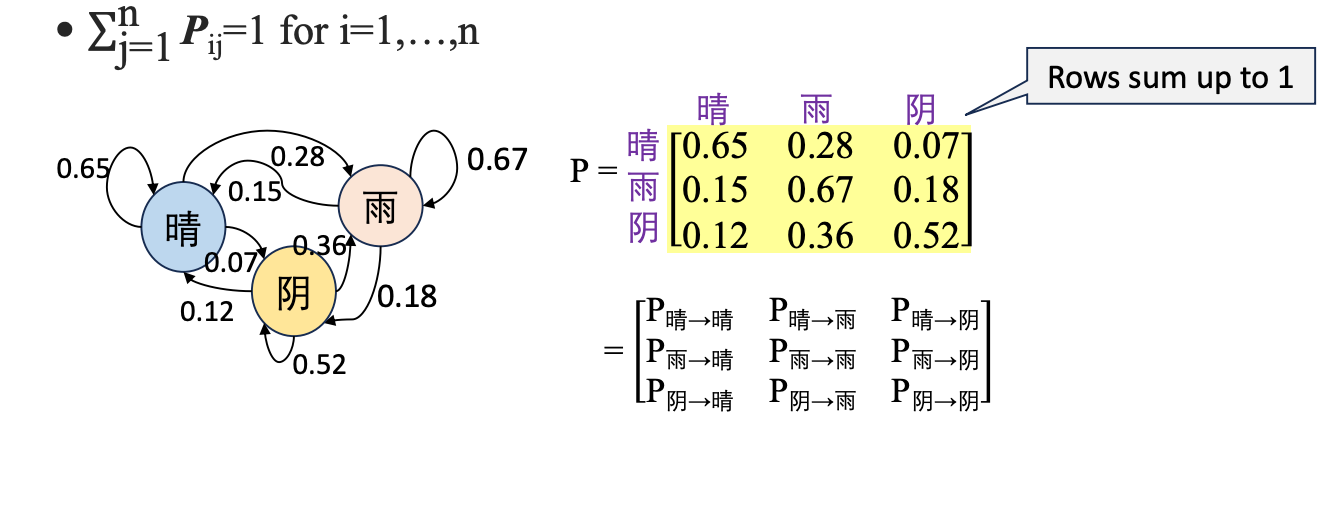
由于该性质,马尔可夫过程通常可以使用有限状态机、来直观表示系统在不同状态间的随机游走 。系统的动态变化通过状态转移矩阵进行表示,矩阵中的元素 P i j = P [ S i → S j ] P_{ij} = \mathbb{P}[S_i \rightarrow S_j] P ij = P [ S i → S j ] i i i j j j ∑ j = 1 n P i j = 1 \sum_{j=1}^n P_{ij} = 1 ∑ j = 1 n P ij = 1
对于存在状态转移的系统,可以通过转移矩阵计算多步后的状态分布分布 。若初始状态分布为 π 0 \pi_0 π 0 n n n π n = π 0 P n \pi_n = \pi_0 P^n π n = π 0 P n π n = π n − 1 P \pi_n = \pi_{n-1} P π n = π n − 1 P lim n → ∞ P n \lim_{n \to \infty} P^n lim n → ∞ P n
这一部分在 PageRank 中有应用:# 高级数据结构-14:PageRank 算法
马尔可夫决策过程
马尔可夫决策过程 Markov Decision Process 在马尔可夫过程的基础上,引入了 决策 Actions 与 奖励 Rewards 机制 。MDP 将状态转移公式由 P [ S t + 1 ∣ S t ] \mathbb{P}[S_{t+1}|S_t] P [ S t + 1 ∣ S t ] P [ S t + 1 ∣ S t , A t ] \mathbb{P}[S_{t+1}|S_t, A_t] P [ S t + 1 ∣ S t , A t ]
一个完整的MDP通常定义为一个五元组 ( S , A , { P s a } , γ , R ) (S, A, \{P_{sa}\}, \gamma, R) ( S , A , { P s a } , γ , R )
CS188 里有更详细的:# 4. MDPs