计算机系统工程-03:远程调用
远程调用
函数是一段可以被调用的程序。调用方传入参数,函数处理后返回结果,例如 Add(2,3) 返回 5。本地调用在当前程序里执行;远程调用把参数发送到另一台机器,再把结果传回来。客户端是发起调用的一方,服务器是提供函数实现的一方。
RPC 是 Remote Procedure Call,中文叫远程过程调用。例如,文件服务器提供 Read、Write,应用通过这些函数读写远端文件。RPC 库负责打包参数、发送请求和接收结果。
直接使用 Socket 时,开发者需要规定报文格式,完成编码和解码,并把收到的数据分成完整消息。多个调用同时等待时,还要把回复交给对应的调用方。RPC 框架负责这些公共工作。RPC 的早期讨论见于 1976 年的 RFC 707,Birrell 与 Nelson 在 1984 年进一步介绍了实现方法。Sun RPC 后来用于 NFS;gRPC、Thrift 和面向对象的 RMI(Remote Method Invocation,远程方法调用)也提供远端调用功能。
远端调用要经过网络,程序需要处理超时和重试。Read(file, offset, size) 重试时可能读到更新后的内容;Append(file, data) 重复执行可能追加两份数据。编写接口时,要说明重试后怎样处理结果。
模块接口
文件系统可以先实现本地 Read、Write 等操作,再由 RPC 存根接收远端参数、调用这些实现、返回结果。接口说明输入、输出和错误条件,通信代码集中处理消息格式与传输,使业务实现能够复用。
例如要在二十台机器上运行同一程序,可以把已编译文件放在共同的网络工作区,各机器通过文件服务读取同一版本。这样仍要检查目标机器的架构与运行环境,并协调新版本的发布。网络文件系统把文件访问组织为远端操作,具体实现将在分布式文件系统中展开。
分层后,开发者可以分别检查文件操作、RPC 和二者连接处。使用编程工具时,也能围绕接口和有关模块给出明确任务;还需要执行跨模块的检查,确认参数、错误处理和提交条件能共同工作。
时钟服务
客户端需要向服务器说明“读取时间”,以及想用秒还是分钟表示。服务器把数值放进回复,客户端收到后再调用本机的设置时钟函数。这一次交互包含请求、服务器执行、回复三个阶段。存根是供业务程序调用的适配代码,负责把普通函数参数转换成网络消息,再把回复还原成返回值。
思考题:只有服务器具有准确时钟和
GET_TIME(units)的实现,客户端怎样调用它并设置自己的时钟?客户端存根和服务端存根各负责什么?解答:
客户端通过存根发送 GET_TIME 的参数,服务端存根解码并调用时间函数,再把结果沿回复返回。客户端据此调用 SET_CLOCK;精确校时还需估计网络传输误差。下图给出完整调用路径。
假设服务器有准确时钟,客户端希望取得时间并校准本机:
| 位置 | 过程 | 执行步骤 |
|---|---|---|
| 客户端 | SYNC_CLOCK() |
调用 t = GET_TIME(SECONDS),再执行本地 SET_CLOCK(t) |
| 服务端 | GET_TIME(units) |
读取 CLOCK,按秒或分钟等约定单位换算后返回 |
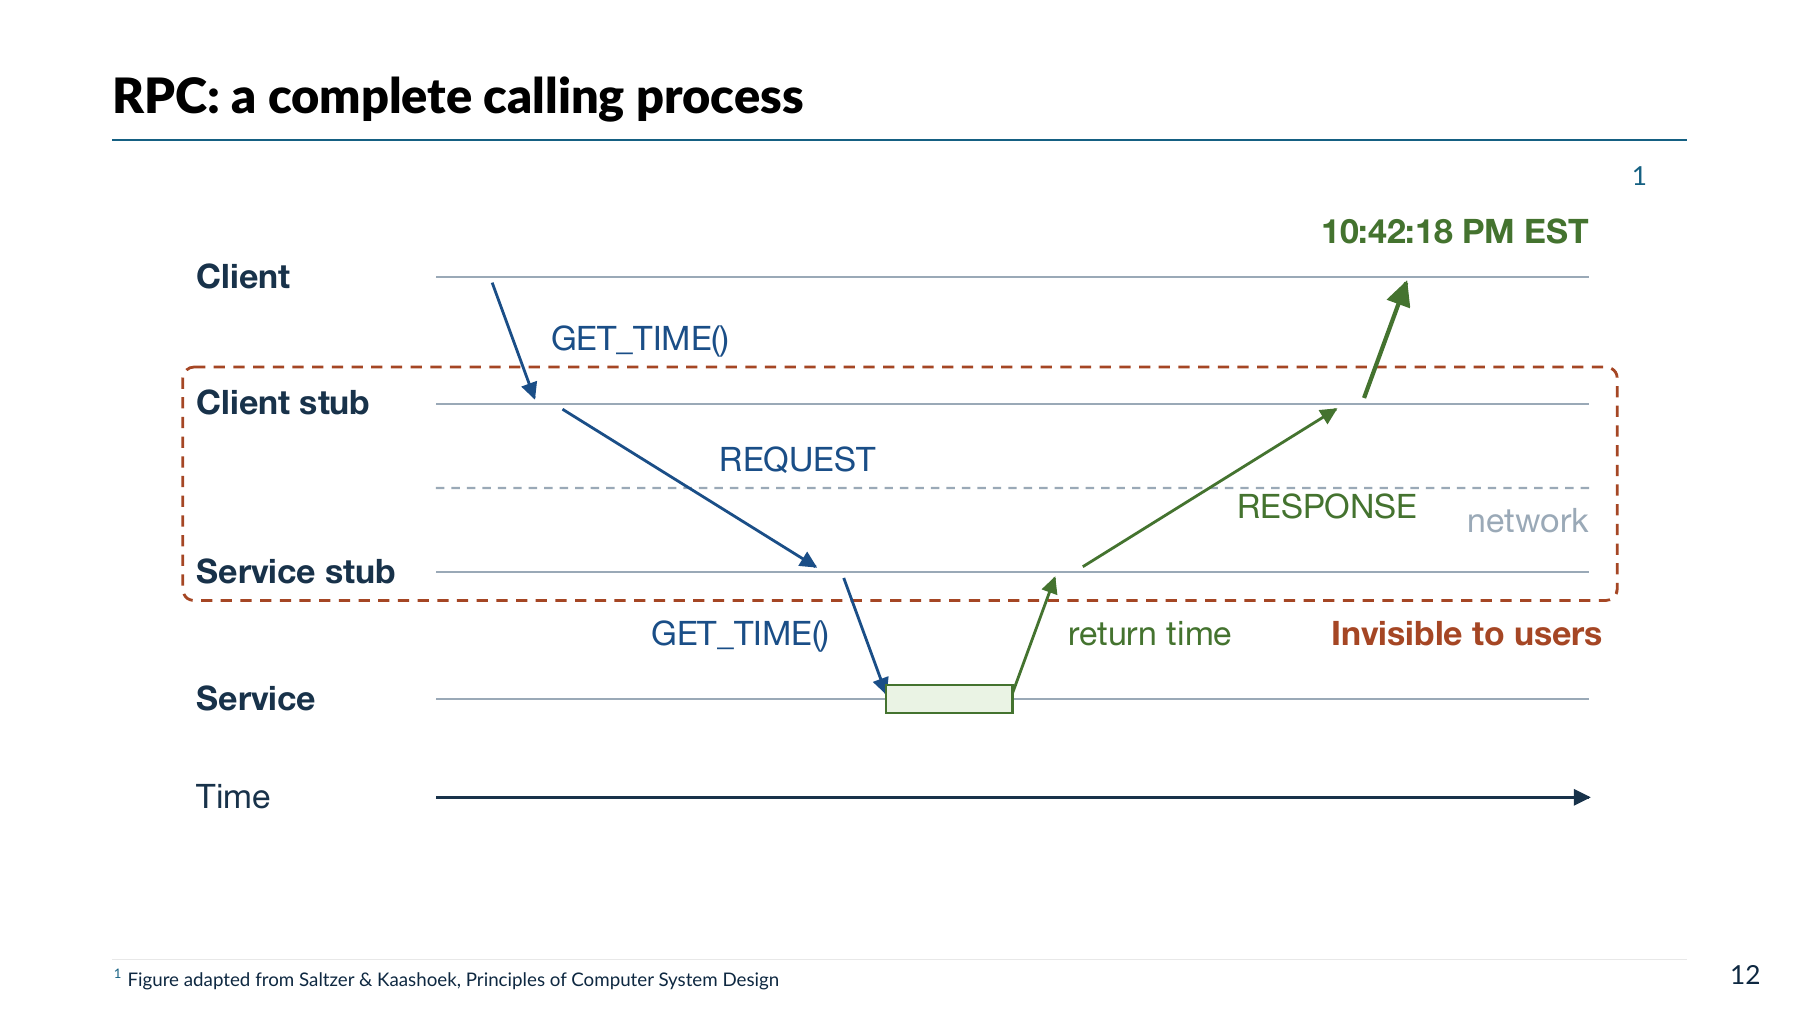
图的横轴是时间,四条线分别表示调用方、客户端存根、服务端存根和时间函数。请求从客户端发到服务器,服务器运行 GET_TIME 后把结果送回。按顺序看:
- 调用方进入客户端存根,参数编码成请求。
- 请求经网络到达服务端,存根解码并选择过程。
- 业务过程运行,返回时间值。
- 服务端编码回复,客户端按调用标识找到等待者。
- 客户端存根解码结果,返回业务代码。
框架可能复用连接、异步等待或使用不同传输方式,图中展示的是共同流程。调用方仍要处理超时和错误状态。
校时误差
每台机器通过本地计时装置维护时间,频率偏差会逐渐积累成时钟偏差。时间服务提供一个参考值,客户端还要估计消息经过网络的时间。本例可以约定使用 Unix 时间戳,以 1970 年 1 月 1 日 00:00:00 UTC 为起点,单位也要明确写入协议。
服务器读取到 t,回复在网络上走了 d 秒,客户端收到时参考时间约为 t+d。直接设置为 t,会把这一段传输时间带进误差。若往返耗时为 20 ms、两段大致对称,可以先估算回程约 10 ms,再配合其他校准步骤使用。
NTP 使用多次时间测量。一次交换中的四个时刻为:客户端发送 T1,服务器接收 T2,服务器发送 T3,客户端接收 T4。由此估计服务器相对客户端的偏差与网络往返时间:
前一个公式利用两个方向的时间差,后一个从完整等待中扣除服务器处理时间。路径不对称、排队和计时精度会影响估计,所以系统还要进行筛选与持续校准。RFC 5905给出了 NTP 的具体时间格式与算法。
请求和回复
报文是一条按约定格式组织的网络消息。请求头记录调用身份、方法和协议版本,参数部分保存业务输入。接收方先解析请求头,找到要调用的函数,再读取参数。xid 是这次调用的标识;回复带回它,客户端才知道应唤醒哪个正在等待的调用。
思考题:RPC 请求消息中要放哪些内容,才能让服务器选中正确函数、读出参数,并让客户端识别回复?
解答:
请求要包含调用标识 xid、消息方向、RPC 版本、程序号与版本、过程号、认证信息和编码后的参数。服务器按程序和过程标识选择函数,再解码参数。回复带回同一 xid、处理状态与结果,客户端据此查找等待中的调用。
请求除了业务参数,还要说明调用对象及回复归属。Sun RPC 类报文包含下面的字段:
| 请求字段 | 用途 |
|---|---|
xid |
关联一次请求与回复 |
| CALL/REPLY 标记 | 区分消息方向 |
| RPC 版本 | 确定报文协议 |
| 程序号、程序版本、过程号 | 选择服务器上的程序与过程 |
| 认证信息 | 按所用认证机制提供凭证与校验信息 |
| 参数 | 过程的输入 |
xid 通常是 32 位整数。客户端为正在等待回复的调用分配不同标识,服务器在回复中带回同一个值。服务器判断重复请求时,还需要结合客户端身份和被调用的方法。
这里的调用标识描述一次 RPC,名称中出现 transaction 也需要按 RPC 协议理解。一笔银行事务可能包含多次 RPC;各次调用的标识和共同的业务事务标识可以分别保存。
回复带回相同的 xid,并说明请求是否被接受、过程是否执行完成。版本错误、认证失败、找不到方法或参数解析失败,都有相应状态。函数正常返回时,业务结果也可以表示“余额不足”等情况。
匹配回复
线程是在同一进程里运行的一条执行流程。两个线程同时请求数据时,各自都在等待自己的返回值。客户端可以建立一张表,例如 1 → 等待网页的线程、2 → 等待图片的线程。收到 xid=2 的回复,就查表交给图片线程;收到 xid=1,再交给网页线程。
多个线程可以共用一条连接,服务端也可以同时处理这些请求。后发出的请求可能先完成,所以客户端需要根据调用标识分发回复。
思考题:线程 1 请求
page.html,线程 2 请求logo.png,二者共用连接,图片先完成。收到回复时怎样找到对应线程?为什么请求需要 xid?解答:
客户端保存
xid=1 → 线程1、xid=2 → 线程2的对应关系。图片先完成时,收到 xid=2 的回复就交给线程 2;随后收到 xid=1,再交给线程 1。xid 将每条回复与它所属的请求关联,完成顺序变化也能正确分发。
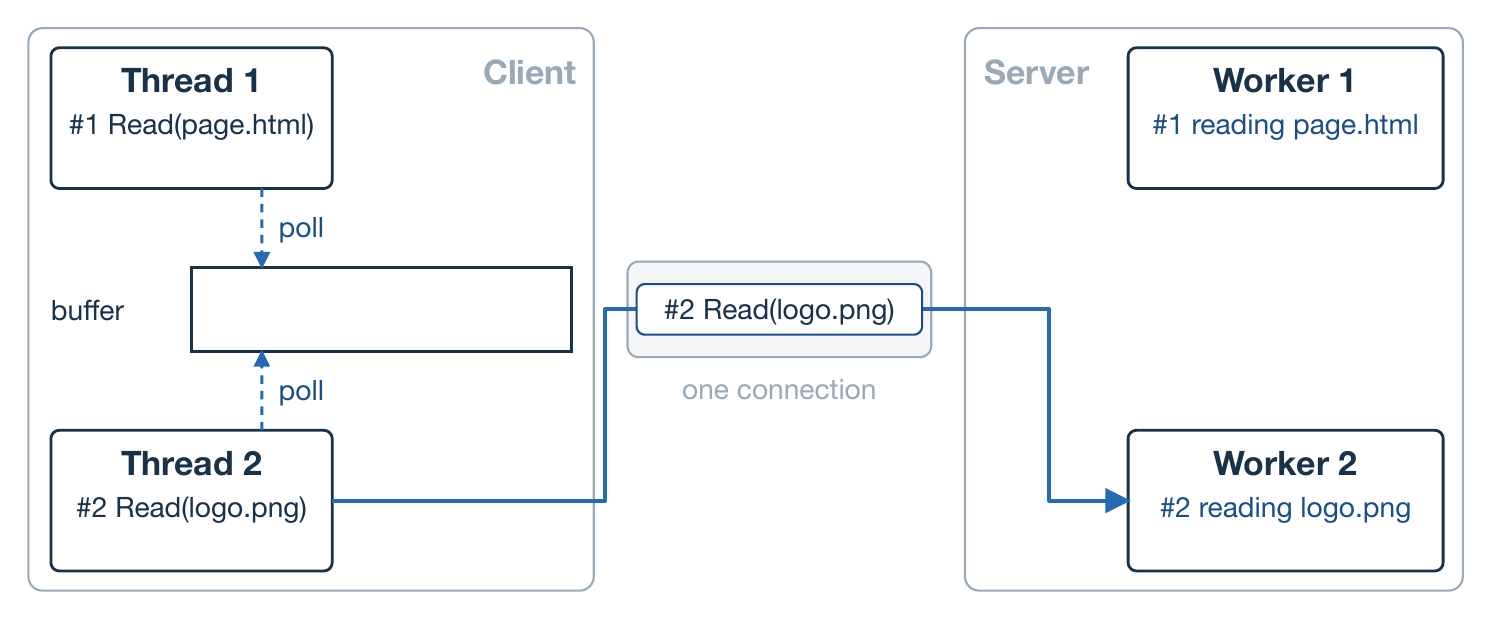
图中线程 1 请求 page.html,线程 2 请求 logo.png,服务器把请求交给两个工作线程。这个例子假设图片先读完,所以回复 2 先回来。实际完成顺序取决于文件大小、缓存和排队时间。
如果接收方把先到的回复交给最早等待的线程,线程 1 就可能收到图片内容。客户端记录 xid=1 对应线程 1、xid=2 对应线程 2,收到回复后交给相应线程。服务器要避免重复执行,还需记录哪些请求已经处理过。
客户端需要协调调用标识的分配,以及等待表、发送队列和接收队列的访问。例如可以把线程编号与线程内递增序号组合为标识,再结合客户端身份区分不同来源。
序号有取值范围。16 bit 计数器只有 种值,回绕时可能与尚未完成的旧请求冲突。客户端重启后,线程编号也可能重新出现,因此需要新的运行代次或其他身份规则。重复发送同一请求时沿用标识,新业务操作则取得新的标识。
本地调用由线程的执行状态、调用栈和返回地址联系到调用方。一个进程可以同时存在多次函数调用,因此进程号只标识进程。远端调用跨过这些本地执行结构,存根需要显式保存等待关系。
连接复用
给每个线程建立独立连接,可以简化部分回复分发,但会增加连接状态、缓冲区和管理工作。许多逻辑调用也可以共用连接,用调用标识找到各自的等待者。
TCP 连接由协议栈管理,多个连接的报文可以共享网卡的接收和发送队列。网卡再把流量分给处理核心,具体队列与连接的对应由实现安排。Linux 网络扩展文档介绍了这类分发机制。
C10K 问题讨论单台服务器如何高效处理约一万个并发连接,涉及线程调度、事件处理、内存和 I/O 等资源。连接数、硬件队列数和正在处理的调用数是不同的计数,需要分别检查。
参数编码
一个字节有 8 bit,可表示 0 至 255。两位十六进制数正好表示一个字节,数字范围从 00 到 ff。0x 表示后面的数按十六进制书写,连续四组两位数则表示四个字节。
思考题:参数按值传递和按引用传递,跨机器时各需要怎样处理?整数
0x89abcdef在大端、小端机器上各怎样排列?字符串、整数宽度和内存对齐还需要哪些共同约定?解答:
按值传递把数据内容编码成字节。跨机器传对象引用时,需要编码对象内容和对象间关系,在接收方重建本地对象。需要修改调用方对象时,应把修改结果放进回复,再由调用方更新;若要持续访问远端对象,则需共同识别的对象 ID 和相应协议。普通内存地址属于所在进程的地址空间。
0x89abcdef的大端排列为89 ab cd ef,小端为ef cd ab 89。两端还要约定整数宽度与符号、浮点表示、字符编码及字段布局,按统一格式读取。
内存地址用于在某个进程自己的内存中找数据。例如一个对象的地址为 0x1000,对象内容是姓名和年龄。发送方把这些内容写成字节,接收方读出姓名和年龄后创建自己的对象。这个对象在接收方的地址可以不同;网络传递的是双方约定的数据表示。
指针记录一个进程中的内存地址。跨机器传对象时,发送方把对象内容编码成字节,接收方读出内容,并在自己的内存中创建对象。字符串、结构体和链表都需要处理这种转换。
这一转换称序列化或编码,在 RPC 中也叫 marshal;反向过程是反序列化或 unmarshal。XDR、ASN.1、JSON、XML Schema、Thrift 和 Protobuf 都涉及对数据表示的约定。Java Serializable、Python pickle 等语言专用格式也能保存对象,但跨语言及长期版本兼容需要另外评估。
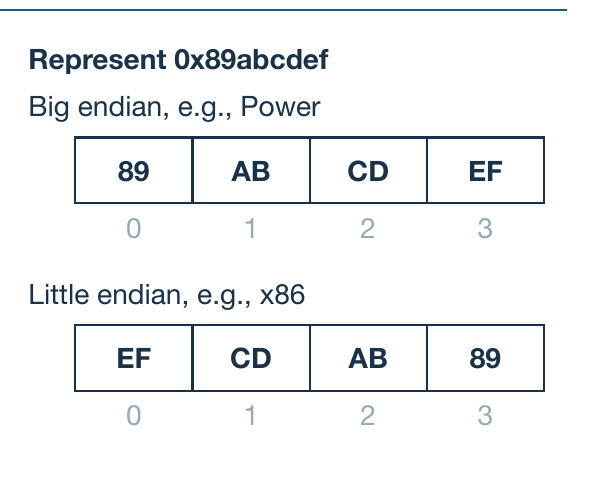
图中,同一个整数 0x89abcdef 在大端机器上按 89 ab cd ef 排列,在小端机器上按 ef cd ab 89 排列。两端要按统一的线上顺序发送和读取。整数宽度、浮点格式、内存对齐和字符编码也要规定清楚,例如“中”的 GBK 字节为 d6 d0,UTF-8 字节为 e4 b8 ad。
字段布局
结构体的内存布局还可能包含对齐填充。考虑一个 uint8_t a 和一个 uint64_t b:两个字段的数值内容共需 1+8=9 B。若该 ABI 要求 b 按 8 B 对齐,a 后要填充 7 B,b 从偏移 8 开始,整个结构体可能占 16 B。
| 区域 | 偏移 | 用途 |
|---|---|---|
| a | 0 | 一字节数值 |
| 填充 | 1 至 7 | 满足本例的对齐要求 |
| b | 8 至 15 | 八字节数值 |
不同平台、编译器选项和结构体定义会决定具体布局。线上编码可以直接声明字段类型与顺序,再由两端构造各自对象。这样能够避免接收方按自己的 sizeof 与字段偏移解释另一种布局。
浮点数也需要明确格式。例如十进制 12.3 可按 float16、bfloat16、float32 或 float64 等格式保存,它们的范围、精度与字节数不同。协议指定具体格式后,两端才能使用相同规则解释;普通二进制浮点还可能用近似数值表示该十进制小数。
对象中的指针会指向更多对象。编码链表时,需要写入节点内容与联系;如果引用关系成环,可以为对象分配编号、记录已访问对象,并在接收方重建联系。采用这种方案时,要在协议中规定编号和引用的含义。
编码格式
字符串表示一段文字,整数表示没有小数的数值,布尔值表示真或假,数组表示一组元素。JSON 用字段名和值表示对象,用方括号表示数组;二进制格式可以用字段编号代替完整名称。接收方都需要知道每个值怎样解释,才能还原相应类型。
思考题:Java 客户端与 Python 服务器怎样交换对象?使用语言专用对象格式会遇到什么兼容问题?JSON 这类文本格式怎样传输图片等二进制内容?
解答:
双方可以采用共同的消息定义和跨语言编码,例如通过 IDL 生成各自的消息类、编码器和存根。Java Serializable、Python pickle 等依赖各自语言的对象模型,跨语言和升级兼容需另行安排。JSON 可把二进制数据转成 Base64 文字;每 3 B 通常变为 4 个编码字符,总长度约增加三分之一。
选择编码格式时,要考虑接收方能否还原数据、不同语言和版本能否共同使用,以及传输和解析需要多少时间。
| 格式 | 特点 | 需要另外约定的内容 |
|---|---|---|
| JSON、XML 等文本格式 | 易于阅读与调试,多语言支持较广 | 数字类型与精度、二进制表示、版本规则 |
| Thrift、Protobuf 等二进制格式 | 利用字段编号和类型描述,通常较紧凑 | schema、生成代码及兼容规则 |
JSON 消息会重复发送字段名。如果接收语言用浮点数保存大整数,可能丢失精度。图片等二进制内容常用 Base64 表示,长度约增加三分之一。文本格式便于查看和调试,选择时可以结合消息大小与使用场景。
JSON 的数字语法有明确规则,具体程序仍要决定把数值放入什么类型。例如业务 id 要求 64 位整数,双方需要约定取值范围与转换方式;使用 binary64 的程序通常只能精确区分 至 的整数。数组中的许多浮点数也会产生数字文字、分隔符和解析工作。RFC 8259说明了 JSON 数字的互操作范围。
二进制编码也要消耗 CPU 和内存。比较运行速度时,需要测量编码、发送、接收和解码的总时间。
YAML、TOML、CSV 也是常见文本格式。使用这些格式时,双方仍要说明字段含义、类型和升级后的处理方式。
思考题:消息采用二进制格式后,RPC 总耗时是否一定减少?网络变快时,还需要测量哪些成本?
解答:
是否减少取决于整个调用的成本。二进制格式可以减少字段名、长度和数值的传输字节,但也需要编码、解码、分配内存和处理请求。网络变快后,传输所占时间可能变小,CPU 与内存工作占比上升。因此应测量相同消息从编码到业务处理、回复解码的完整耗时。
接口定义
IDL 是 Interface Definition Language,中文叫接口定义语言。开发者在 IDL 文件里写明消息有哪些字段、每个字段的类型,以及可以调用哪些方法。schema 指其中的数据结构定义。Thrift 有自己的 IDL,Protobuf 使用 .proto 文件;gRPC 也在这个文件中定义服务和方法。
思考题:一份跨语言、可升级的消息定义,应怎样说明字段身份、类型和可以调用的方法?生成工具能替开发者完成哪些代码?
解答:
消息定义应给字段稳定编号、类型和含义,并约定缺少字段时的默认值与未知字段的跳过规则;方法声明写明名称、请求类型和回复类型。生成工具可以输出各语言的消息类、序列化与反序列化代码、客户端和服务端存根。业务函数及业务层的重试、去重规则仍需开发者实现。
Person 是消息类型,user_name 是其中的字段,string 表示该字段保存字符串。字段编号用于在线上传输时识别字段,程序运行时再为这些字段填写具体值。
以表示个人信息的 Person 为例,简化的 Protobuf 消息声明可以包含:
| 声明 | 含义 |
|---|---|
message Person |
定义消息类型 |
string user_name = 1; |
字符串字段,编号 1 |
int64 favorite_number = 2; |
64 位整数类型的字段,编号 2 |
repeated string interests = 3; |
可包含多个字符串的字段,编号 3 |
这里的 2 是字段编号。程序运行时把 favorite_number 的值设为 1337,编码器再根据字段编号和类型生成标识,并把 1337 编成字节。
例如,rpc GetTime(TimeRequest) returns (TimeResponse); 声明了方法名、请求类型和回复类型。服务器按这个声明实现 GetTime,客户端按同一声明调用它。读取时钟的具体代码由服务器开发者编写。
开发者先写 IDL,再运行工具生成消息类型、编码和解码代码,以及 RPC 存根。客户端使用生成的存根,服务器实现其中声明的方法。Python 客户端和 C++ 服务器可以根据同一份定义生成各自代码。protoc 生成 Protobuf 消息代码,gRPC 插件生成服务相关代码。gRPC 官方说明
Thrift 编码
下面沿字节图读取同一个对象。每个十六进制数由两位组成,例如 0b、0a、00,各占 1 B;Martin 的六个英文字母占 6 B。字段头说明类型和编号,长度说明后面有多少字节。知道这些规则后,接收方就能从一串连续字节中逐段找到各个字段。
下面的对象有三个字段:userName="Martin"、favoriteNumber=1337、interests=["daydreaming","hacking"]。这个对象的无空格 JSON 编码为 81 B。下面计算它采用不同格式时的编码大小;发送完整 RPC 消息时,还要加上请求头等信息。
例题:
userName="Martin"、favoriteNumber=1337、interests=["daydreaming","hacking"]。按图中的 BinaryProtocol 和 CompactProtocol 格式,逐段计算字段头、长度、整数和字符串占用的字节,再求对象总大小。解答:
- BinaryProtocol:姓名的类型、编号、长度、内容共 B;整数为 B;列表的字段头、元素类型和数量共 8 B,两个字符串分别为 B、 B,STOP 为 1 B。合计 B。
- CompactProtocol:姓名为 B;整数 1337 经 ZigZag 得到 2674,Varint 为
f2 14,加字段头共 3 B;列表头 2 B,字符串为 B、 B,STOP 为 1 B。合计 B。
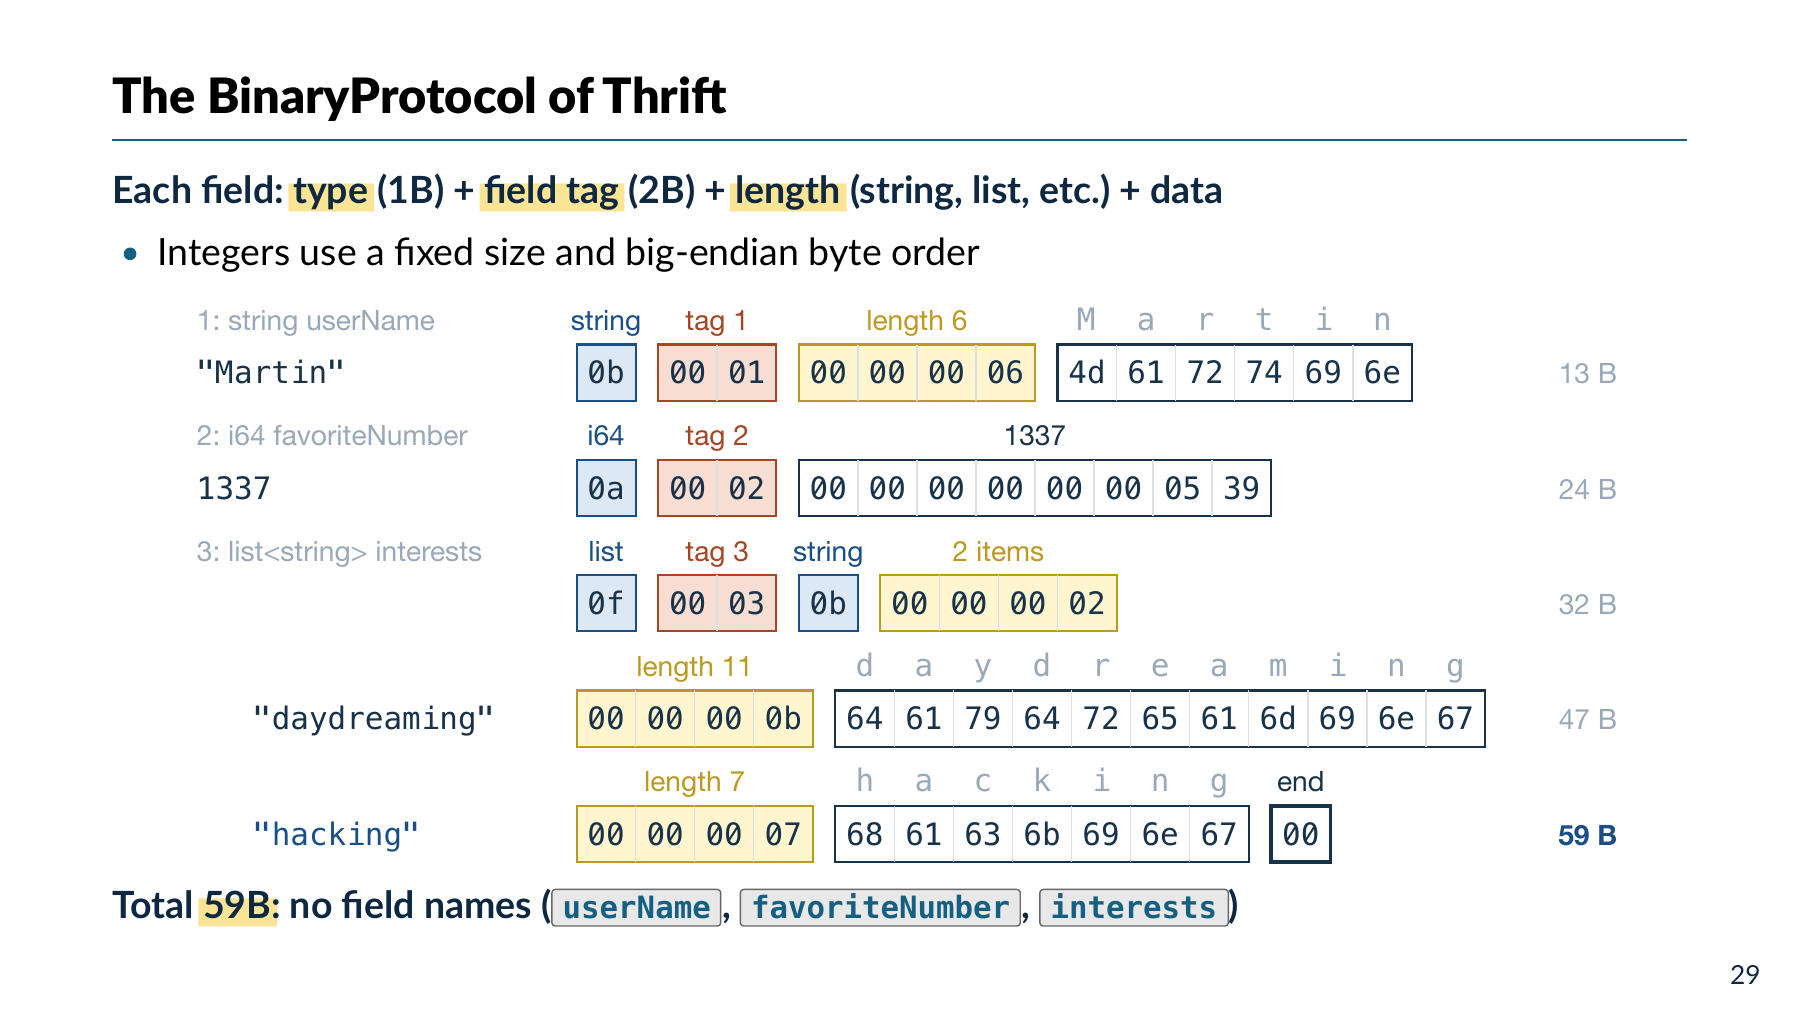
BinaryProtocol 每个字段先写 1 B 类型和 2 B 字段编号,整数采用固定宽度、大端序。沿图逐段读取:
- 姓名:
0b表示字符串,00 01是字段 1,00 00 00 06是长度 6,后接Martin,共 13 B。 - 数字:
0a表示 i64,00 02是字段 2,后接00 00 00 00 00 00 05 39,数值为 1337。本字段 11 B,累计 24 B。 - 列表:字段类型与编号占 3 B,元素类型占 1 B,数量占 4 B;每个字符串另有 4 B 长度。
- 最后写
00STOP 标记。总量为 B。
图右边的 13、24、32、47、59 B 表示从开头到当前位置的累计长度。相邻数值相减,可以得到中间一段占了多少字节。
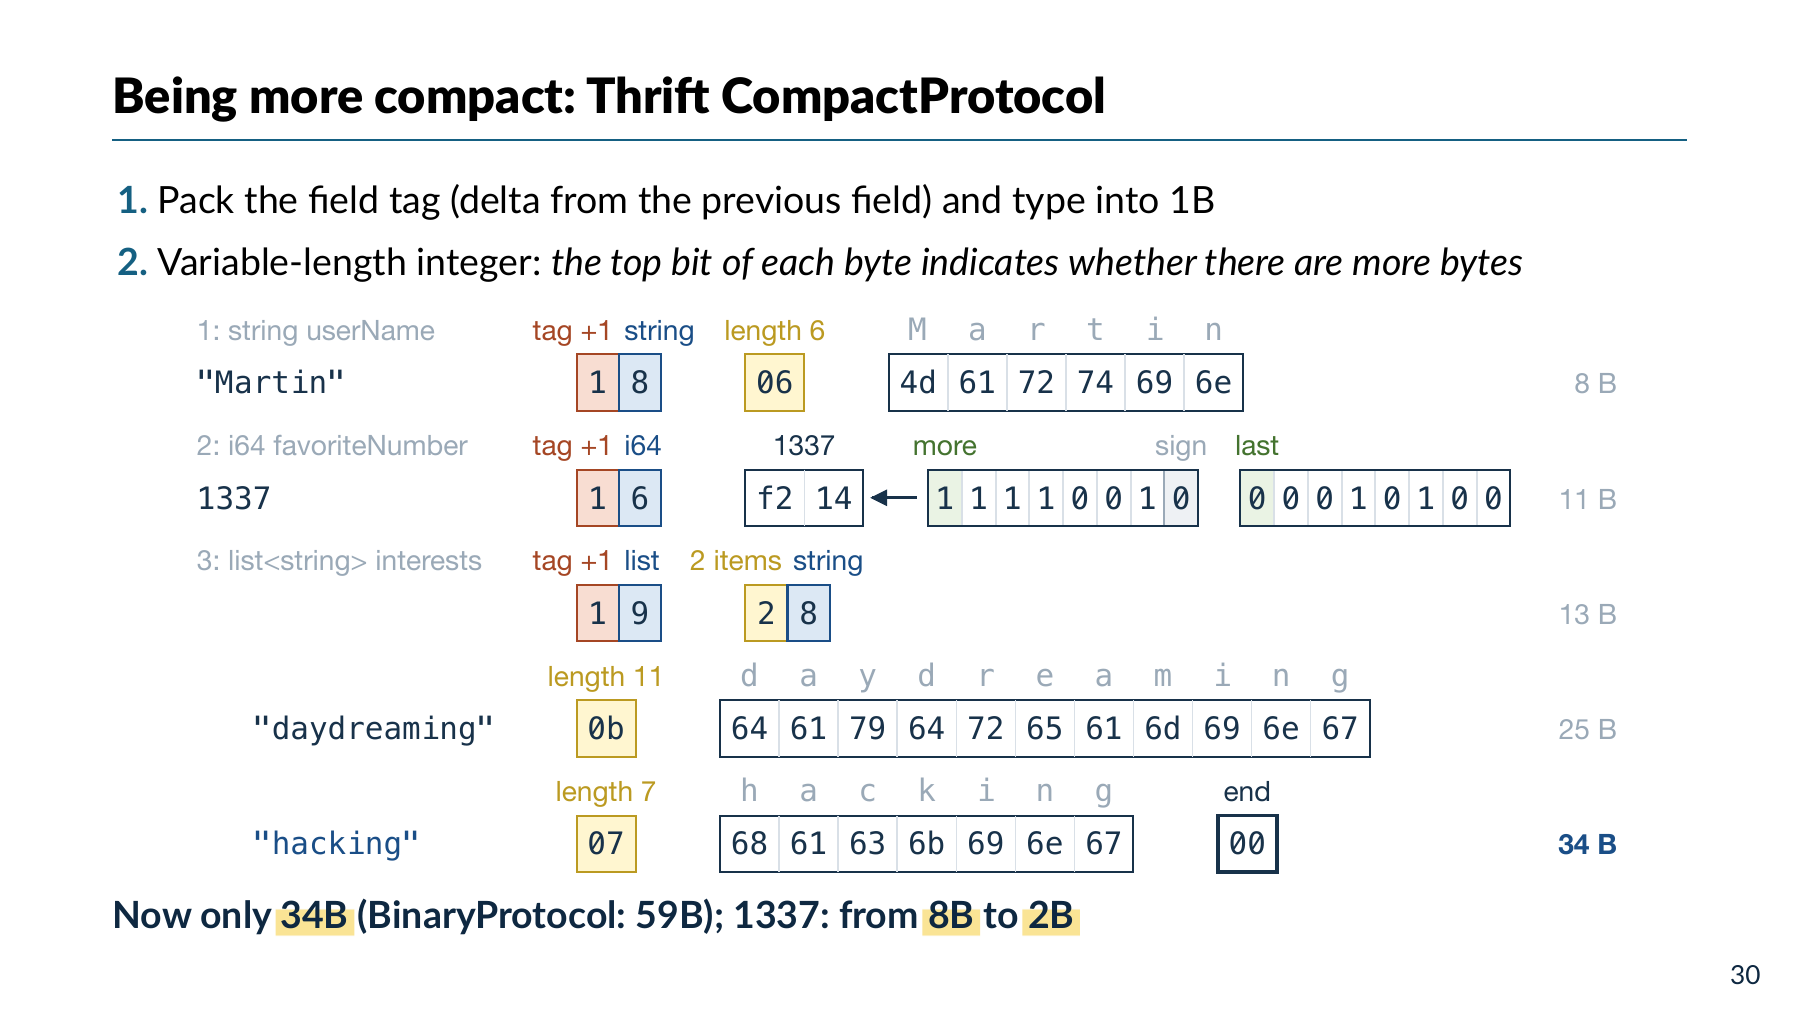
CompactProtocol 在字段编号增量适合时,将增量与类型合并到 1 B;较小长度和整数用变长表示。图中的有符号整数 1337 先经 ZigZag 映射为 2674,再以 Varint 编成 f2 14。姓名字段共 8 B,数字字段 3 B,列表头 2 B,两个字符串 12 B、8 B,STOP 1 B,总量 B。
ZigZag 把有符号整数映射成非负整数,映射顺序是 0→0、-1→1、1→2、-2→3。正数 x 对应 2x,负数 x 对应 -2x-1。因此 1337 对应 2674。f2 14 去掉各字节的最高位后得到 114、20,还原为 ,再解映射回 1337。
这两种编码保存了同样的字符串内容。CompactProtocol 减少了字段描述、长度和小整数占用的字节;这个对象的总大小由 59 B 变为 34 B。
Protobuf 编码
Protobuf 用字段编号识别字段。每个字段开头的 Tag 同时记录字段编号和后续值的编码方式 wire_type,Tag 本身也用 Varint 编码。
左移三位相当于乘以 8,为 wire_type 留出最低三位;按位或把两部分合并。字段编号与 wire_type 各自在自己的位段中,因此也可写成 。
| wire_type | 编码方式 | 常见类型 |
|---|---|---|
| 0 | Varint,按继续位确定结束 | int32、int64、bool、enum |
| 1 | 固定 8 B | fixed64、double |
| 2 | 先读长度,再读相应字节 | string、bytes、嵌套消息 |
| 5 | 固定 4 B | fixed32、float |
旧 group 格式还使用开始、结束类型 3、4,现已弃用。
变长整数
一个字节有 8 位,最高位在左。Varint 的低 7 位保存数值,最高位表示是否还有后续字节:1 为继续,0 为结束。每个数值块的基数为 ,按低位块在前的顺序发送。
例如 128 除以 128 得到余数 0、商 1,数值块为 0、1。给前一个块加继续位后,字节为 80 01,还原为 。
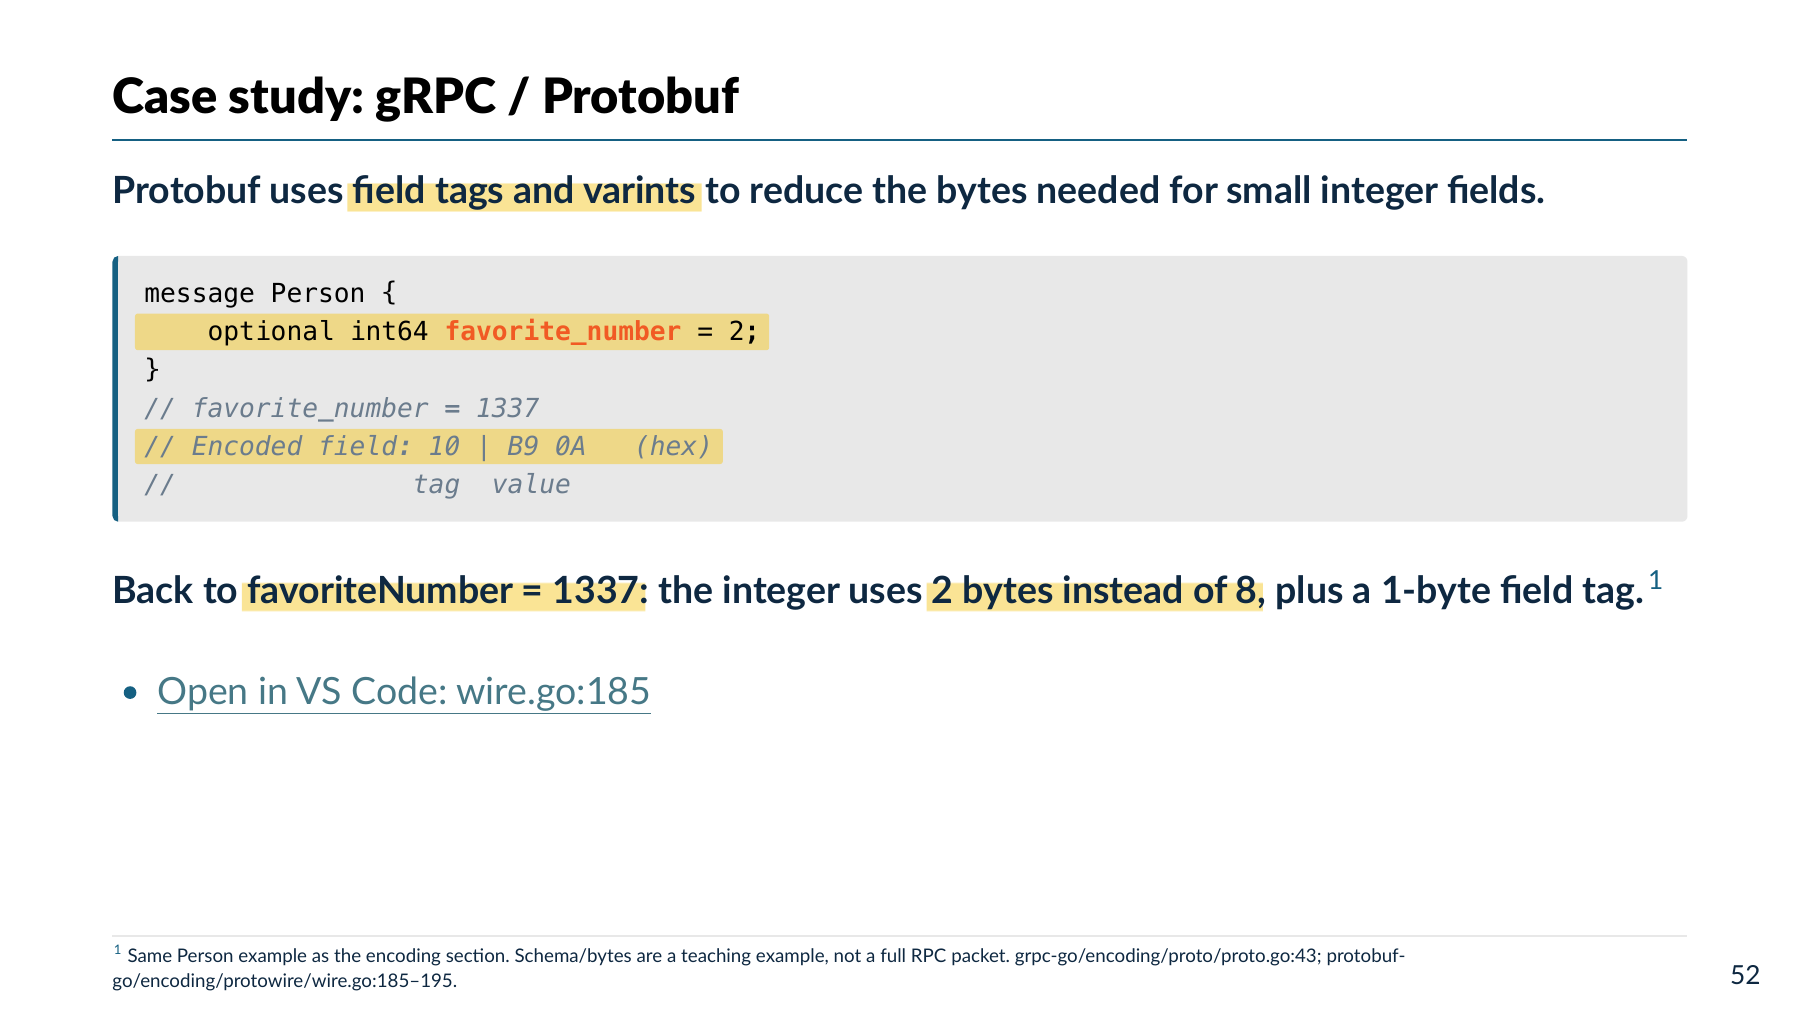
例题:字段声明为
int64 favorite_number = 2;,实际值为 1337。计算 Tag、Varint 和完整字节串,并说明接收方怎样还原它。解答:
字段编号为 2,int64 使用 wire_type=0,所以 Tag 为 ,十六进制是
10。编号 2 的二进制00000010左移三位得到00010000,低三位000表示类型 0。16 小于 128,Tag 占一个字节。将 拆成低位块 57、高位块 10:
顺序 7 位数值 继续位 完整字节 第一字节 0111001,即 571 10111001,即b9第二字节 0001010,即 100 00001010,即0a完整字节串为
10 b9 0a,共 3 B。接收方从首字节 16 计算16 >> 3 = 2和16 & 7 = 0,知道字段号为 2、后面按 Varint 读取;去掉b9 0a的继续位,取得 57、10,还原 。字段编号和类型决定 Tag,实际数值决定后面的整数编码。字段名字来自消息定义。int64 规定整数范围,Varint 按值决定长度;sint64 还会先使用 ZigZag。
字符串示例是字段 1 的 user_name="Martin"。它用 wire_type=2,Tag 为 ,写作 0a;长度为 06,随后是六个字母,完整字节串为 0a 06 4d 61 72 74 69 6e,共 8 B。Protobuf 编码说明
版本兼容
一份消息定义可能增加或删除字段,而客户端与服务器的升级时间不同。例如旧版本只认识姓名和号码,新版本又增加兴趣列表。升级期间,双方仍需处理已经发送或保存的旧消息。字段编号、类型和缺省值的约定,使接收方知道缺少某个字段时用什么值、遇到新字段时怎样继续解析。
思考题:旧消息定义只有
id,新定义增加priority,约定缺省值为 0。
- 旧程序写出
{id:7},新程序应怎样读取?- 新程序写出
{id:7,priority:1},旧程序应怎样处理?- 这些行为对字段编号、可缺省规则和未知字段处理有什么要求?
解答:
- 新程序读取旧消息,得到 id=7,并为缺少的 priority 使用约定值 0。
- 旧程序读取新消息,识别 id=7,按编码规则跳过新增 priority 字段,继续解析。
- 格式要支持字段身份识别和未知字段跳过,已有编号与含义保持稳定,新增字段允许缺省并有明确默认值。直接改变内存结构还需要相应编码协议提供这些兼容规则。
reader 是解码消息的程序,writer 是编码消息的程序。向后兼容表示新程序能读旧消息,向前兼容表示旧程序能处理新消息。图中的 STOP 是 Thrift 结构的结束标记,接收方读到它就结束当前结构。
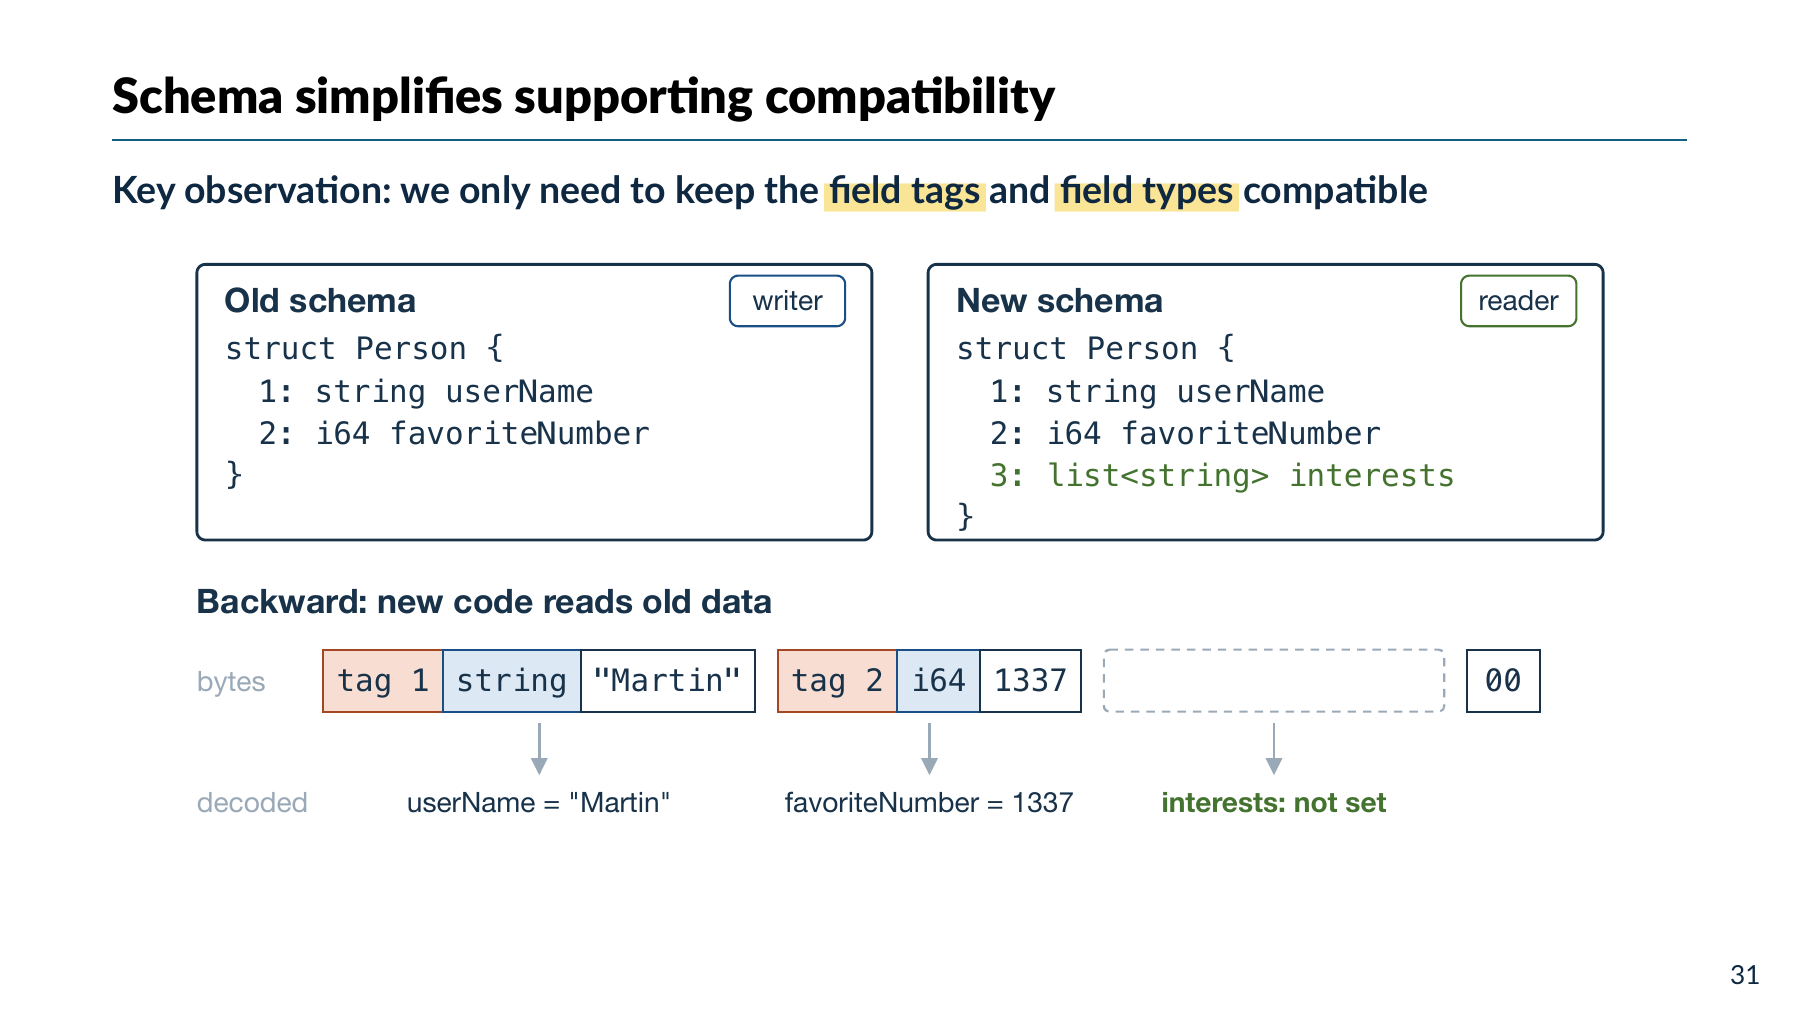
新 reader 能读取字段 1、2、3,旧消息只发送了 1、2。它读到 STOP 后结束解析,字段 3 保持未设置,或使用消息定义中的默认值。为了让旧消息继续有效,新增字段需要允许缺省。
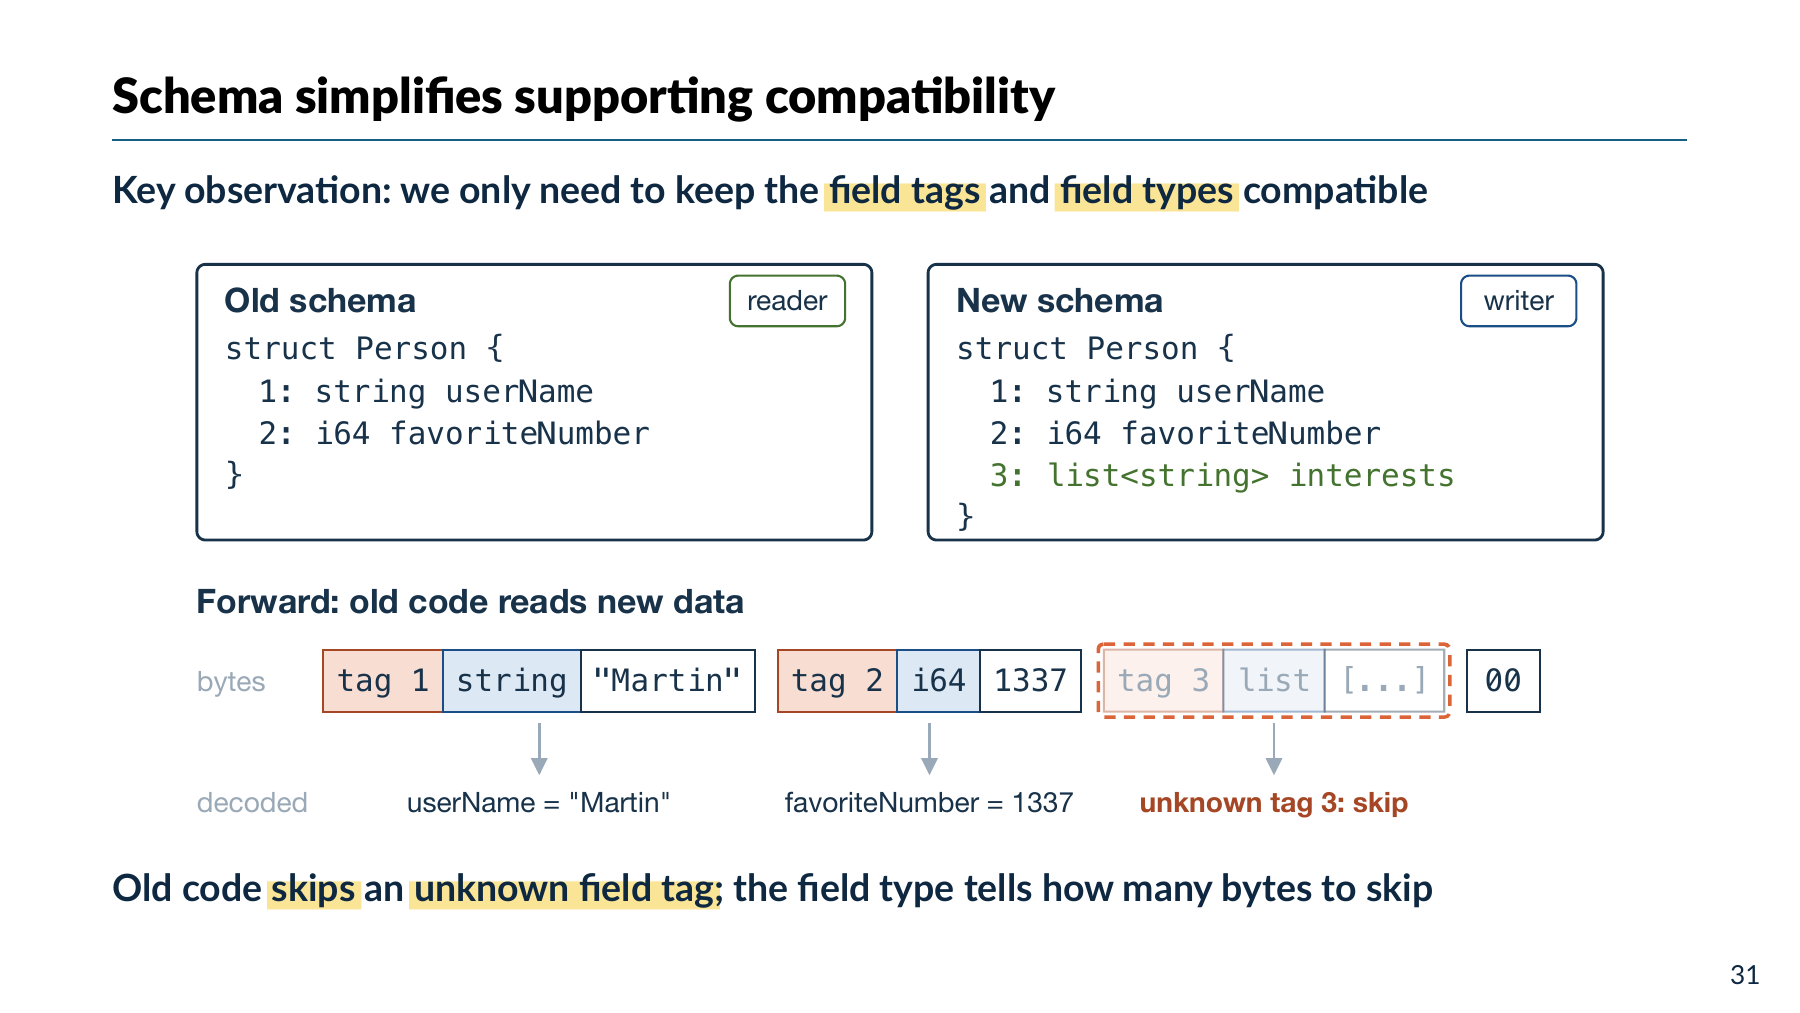
新 writer 发出字段 1、2、3,旧 reader 遇到新增的字段 3,按编码规则跳过它,再继续读后面的字段。Varint 读到终止位,定长类型按固定字节数跳过,带长度的类型先读取长度。
已有字段编号和语义应保持稳定,新增字段需要可缺省的规则;Protobuf 删除字段后应保留其编号,防止用于其他含义。跳过未知字段保证能够解析,业务是否仍可正确运行还要检查新旧程序的约定。
若服务端直接把旧消息当作加长后的新结构体读取,缺少的 priority 位置可能超过消息边界,或读到没有定义的值。解码时要检查实际长度、字段身份与类型,再为允许缺省的字段赋值。新旧 schema 可以按兼容规则演进,生成代码也要遵守这些边界检查。
调用成本
对按阶段完成的简化调用,可以把时间拆成编码、网络、业务处理、排队和解码:
这些部分包含请求与回复的有关工作。消息有效字节为 S、可用传输率为 B 时,单段理想发送时间为 S/B;传播、协议头、网络排队与往返还会增加时间。
减少消息大小主要改变有关传输工作,紧凑编码也可能增加 CPU 工作。前面的 Thrift 对象由 59 B 变为 34 B,减少 25 B,约为原大小的 42%;总调用能节省多少,需要同时测量其他部分。
练习:只按有效字节计算,1 Gbit/s 链路传输 59 B 与 34 B 的时间差是多少?若更紧凑的编码额外花费 1 μs,其他成本相同,净变化是多少?
解答:
1 Gbit/s 等于 B/s,25 B 的理想发送时间差为 μs。编码增加 1 μs 后,合计多花约 0.8 μs。
实际报文还有头部、最小帧和传输时延等条件。这个计算只用来说明,节省字节与增加编码工作要一起计入。
再看高带宽情形。假设传输率为 100 GB/s,即 800 Gbit/s,4 KiB 有效数据的纯发送时间约为 0.041 μs。真实网络仍有等待与往返,但在这种假设下,较长的编码解码过程就可能成为主要成本。对象结构、语言实现、分配和复制都会影响测量结果。
远端映射
受控运行环境还可以减少格式转换。先执行并产生对象的函数是生产者,后续读取对象的函数是消费者。Dmerge 的 RMMAP(remote memory map,远端内存映射)把生产者的有关内存映射到消费者地址空间;消费者访问对象及内部指针时,由操作系统取得对应远端页面。
RDMA 是远程直接内存访问,网卡按注册范围与访问权限读写对端缓冲区,可用于加快页面读取。注册先指定允许使用的内存范围,远端映射再建立对象地址与这些页面的联系。
这一过程需要操作系统、网络、分配器与语言运行时配合,处理地址冲突、对象布局、跨机器生命周期和隔离。普通 RPC 参数编码仍按双方协议构造对象;使用远端映射时,地址能够使用的条件由这套额外机制建立。
序列化成本也与对象结构有关。Dmerge 论文中的一个 3.2 MB pandas dataframe 包含约 40 万个子对象,序列化耗时约 10 ms;这是该实验对象的测量。比较方案时,要把页面访问、预取、映射与保留对象的成本一起计算。Dmerge 原论文
网络故障
超时表示客户端等待的时间超过了设置的期限。例如最多等 1 s,过了 1 s 仍没有回复,客户端就结束等待并报告超时。请求可能已经到服务器,回复也可能还在路上,所以客户端还需要用调用标识或业务记录查询实际结果。
本地函数在调用它的进程中运行,进程崩溃会中断调用。RPC 的客户端和服务器分别运行,网络也可能出故障。客户端收到超时时,服务器可能尚未执行,也可能已经完成。
思考题:客户端一直收不到回复并发生超时,服务器可能处于哪些状态?怎样区分请求丢失、服务器停顿与已经执行但回复丢失?
解答:
可能是请求丢失、请求仍在路上、服务器崩溃、服务器暂时停顿、过程已完成但回复丢失,或回复仍在路上。一次超时只记录等待超出期限,无法据此选定一种情况。需要用稳定调用 ID 查询执行记录和业务结果,再按协议重试;缺少可靠记录时,结果仍可能不确定。
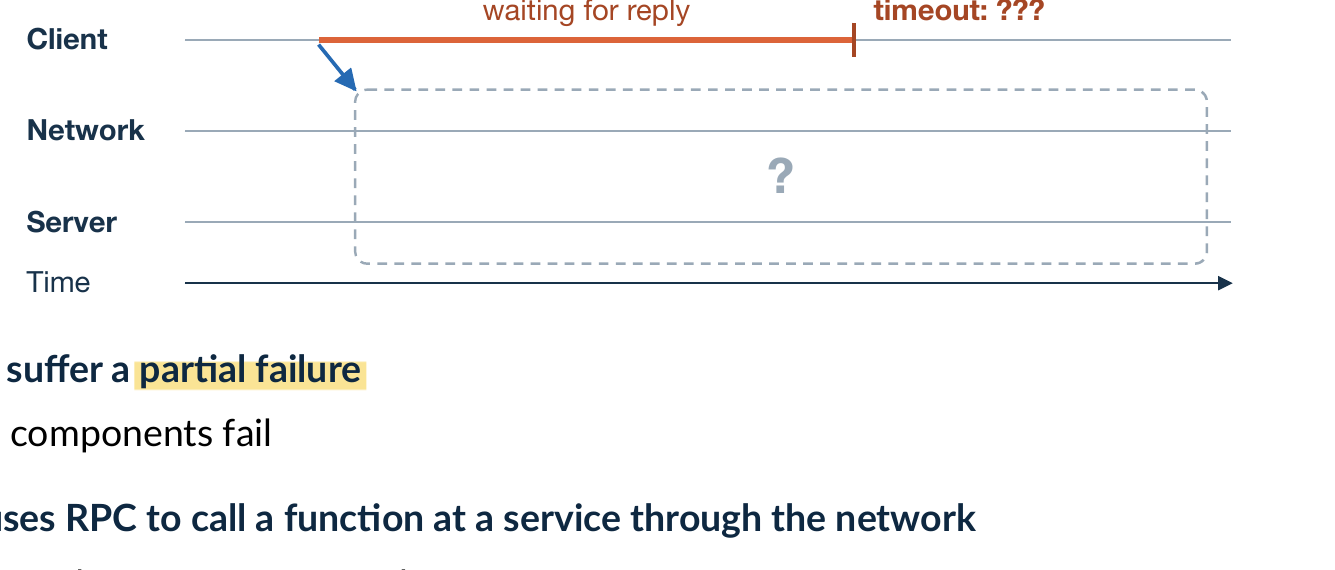
超时可能由下面六种情况产生:请求丢失;请求延迟;服务器崩溃;服务器暂时停顿;过程已执行但回复丢失;回复仍在路上。请求延迟时,服务器可能在客户端超时以后才收到它。
服务器忙碌时,请求可能在队列里等待;应用线程暂时停顿时,请求也可能迟迟无法处理。故障若发生在业务过程内部,一部分修改可能已经执行,这又需要由事务与恢复机制处理。客户端仅根据等待时间,无法还原这些内部阶段。
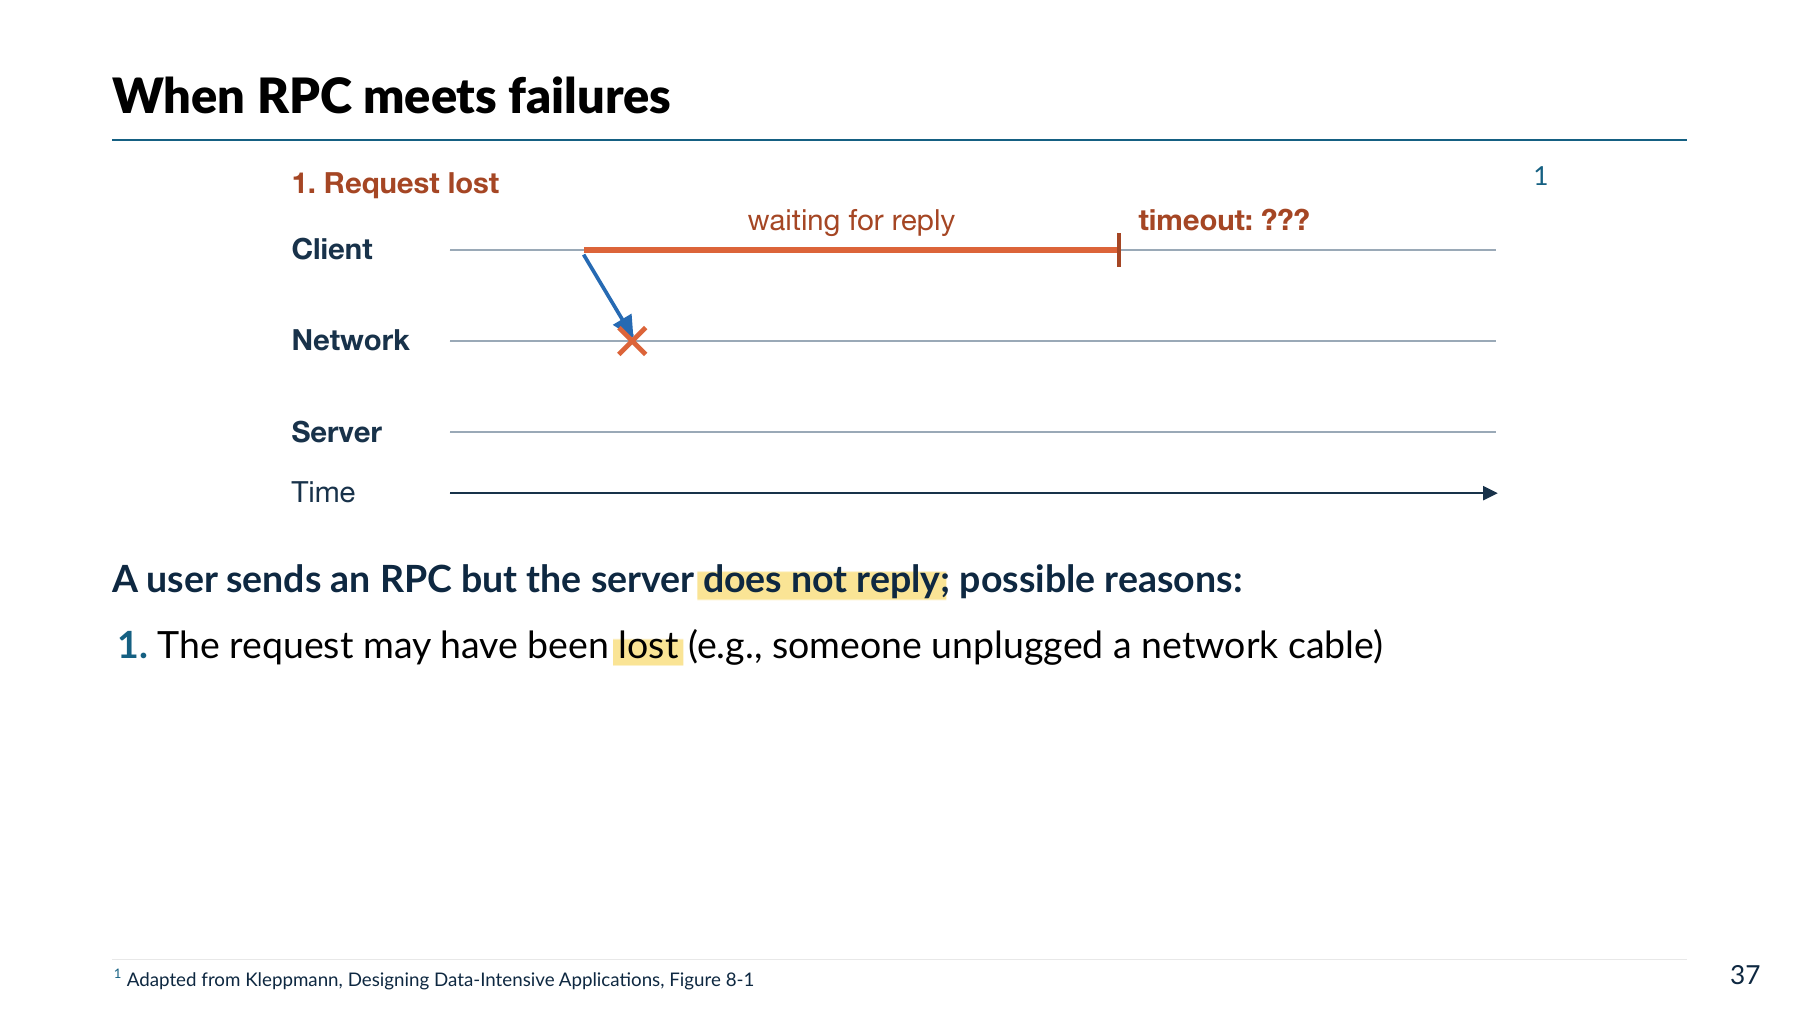
第一图红叉在请求路径上,服务器没有 run。若其他条件正常,重试提供首次执行的机会。
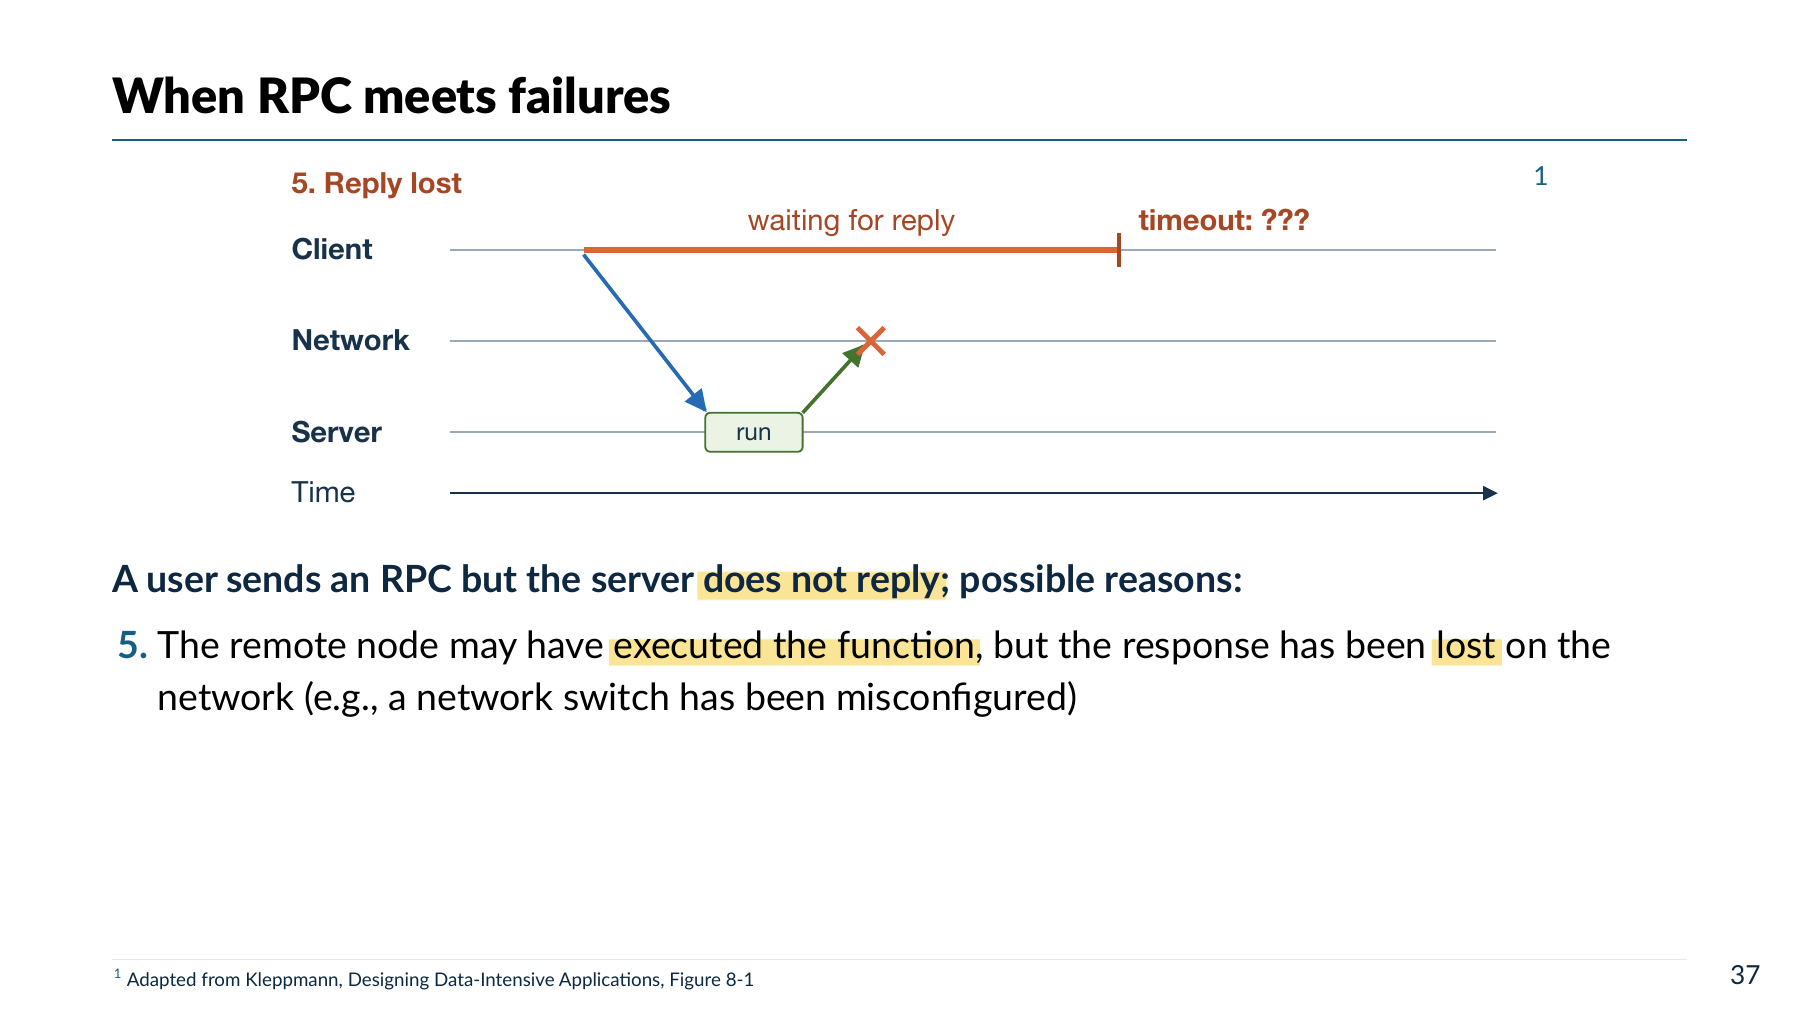
第二图中,服务器先运行函数,红叉出现在回复途中。客户端等到超时后重试,AddBalance(100) 就可能再加 100。程序需要检查返回状态,并在结果不明时按业务记录确认操作是否完成。
执行次数
调用次数、服务器执行次数和业务修改次数需要分别记录。例如一次加款调用在客户端看来只发起了一次,重试却可能使服务器收到两条请求。服务器识别重复请求后,可以把两次接收对应到同一项业务操作,再决定返回已有结果或继续处理。
思考题:应用开发者通常希望一次调用产生怎样的执行效果?系统实现至多一次、至少一次或恰好一次效果时,分别需要记录和处理什么?
解答:
应用通常希望一次逻辑调用只产生一次已确认的业务修改。至少一次方法在未获成功回复时重试,允许过程重复执行,完成依赖通信和服务最终恢复。至多一次需要稳定 ID 与去重记录,重复请求等待已有执行或取已有结果,失败时可能执行零次或一次。恰好一次效果需要把业务修改、请求 ID 和结果一起可靠提交,重试沿用 ID,恢复后按记录确认结果。
| 名称 | 处理方法 | 可能结果 |
|---|---|---|
| 至少一次 | 未获成功回复时重试 | 可能重复执行;完成依赖故障最终恢复、持续重试等前提 |
| 至多一次 | 固定调用 ID,检测并抑制重复 | 失败时可能执行零次或一次,调用方未必知道是哪种 |
| 恰好一次效果 | 持久去重记录与业务修改原子提交 | 故障恢复后按记录确认结果,客户端持续重试直至完成 |
按 Birrell 的设计,收到成功回复时可以确认过程已完成一次;收到服务器失败通知时,过程可能执行了零次或一次。超时只说明等待超过期限,客户端还需要进一步确认服务器和业务结果。
回复缓存
回复缓存保存“请求标识 → 已完成结果”。处理编号 7 时,服务器把余额从 0 改为 100,并保存 7 → 100;再收到编号 7,就读取这份记录并返回 100。若要在崩溃恢复后继续这样判断,余额修改和编号 7 的完成记录需要一起可靠提交,恢复后先检查这份记录。
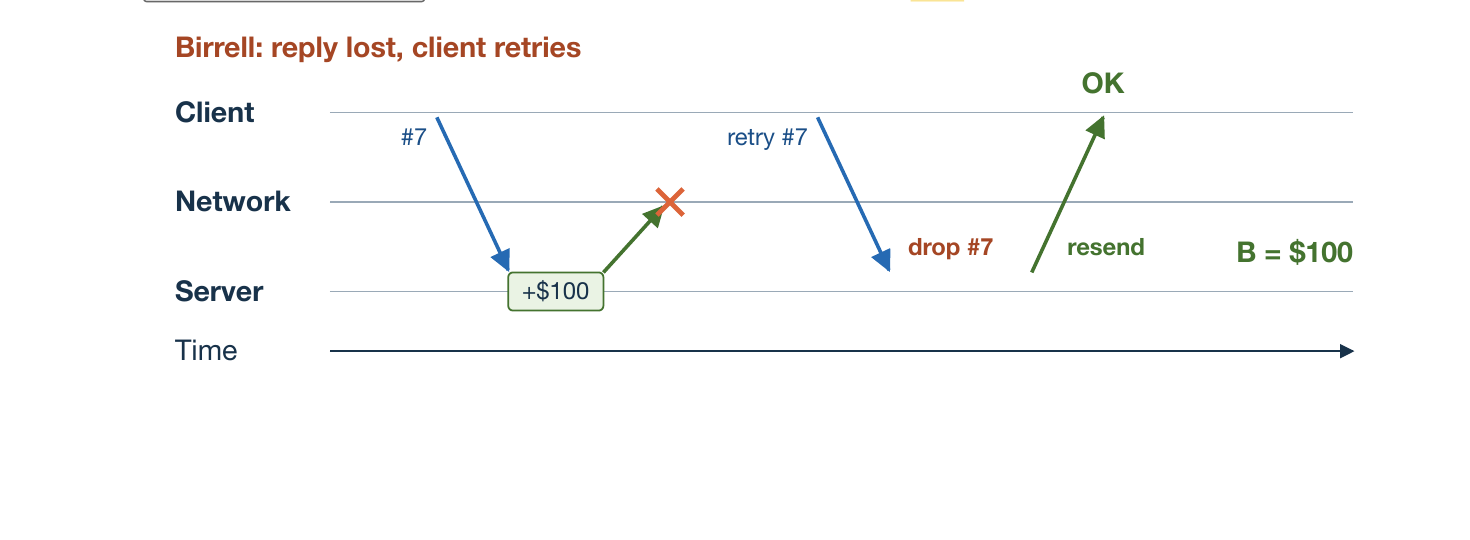
客户端发送编号 7 的加款请求,服务器使 B 从 0 变为 100,但回复丢失。客户端仍用编号 7 重试;服务器若保存了这次结果,就重发结果并跳过业务过程。换成编号 8 会被当作新调用,失去去重依据。
思考题:账户 B 初始为 0,只有一次
Transfer(100)。服务器报告 CRASH,调用方无法确认过程是否执行。B 可能是多少?重试前应怎样确认结果?解答:
按这次转账已经完成或尚未完成的两种情况,B 可能为 100,也可能为 0。应查询这笔操作的可靠业务记录或请求完成记录,保持原操作 ID,再由协议处理继续执行或返回已完成结果。在这个只有一笔加款的例子中,余额可帮助检查;实际确认仍需与具体操作身份对应。
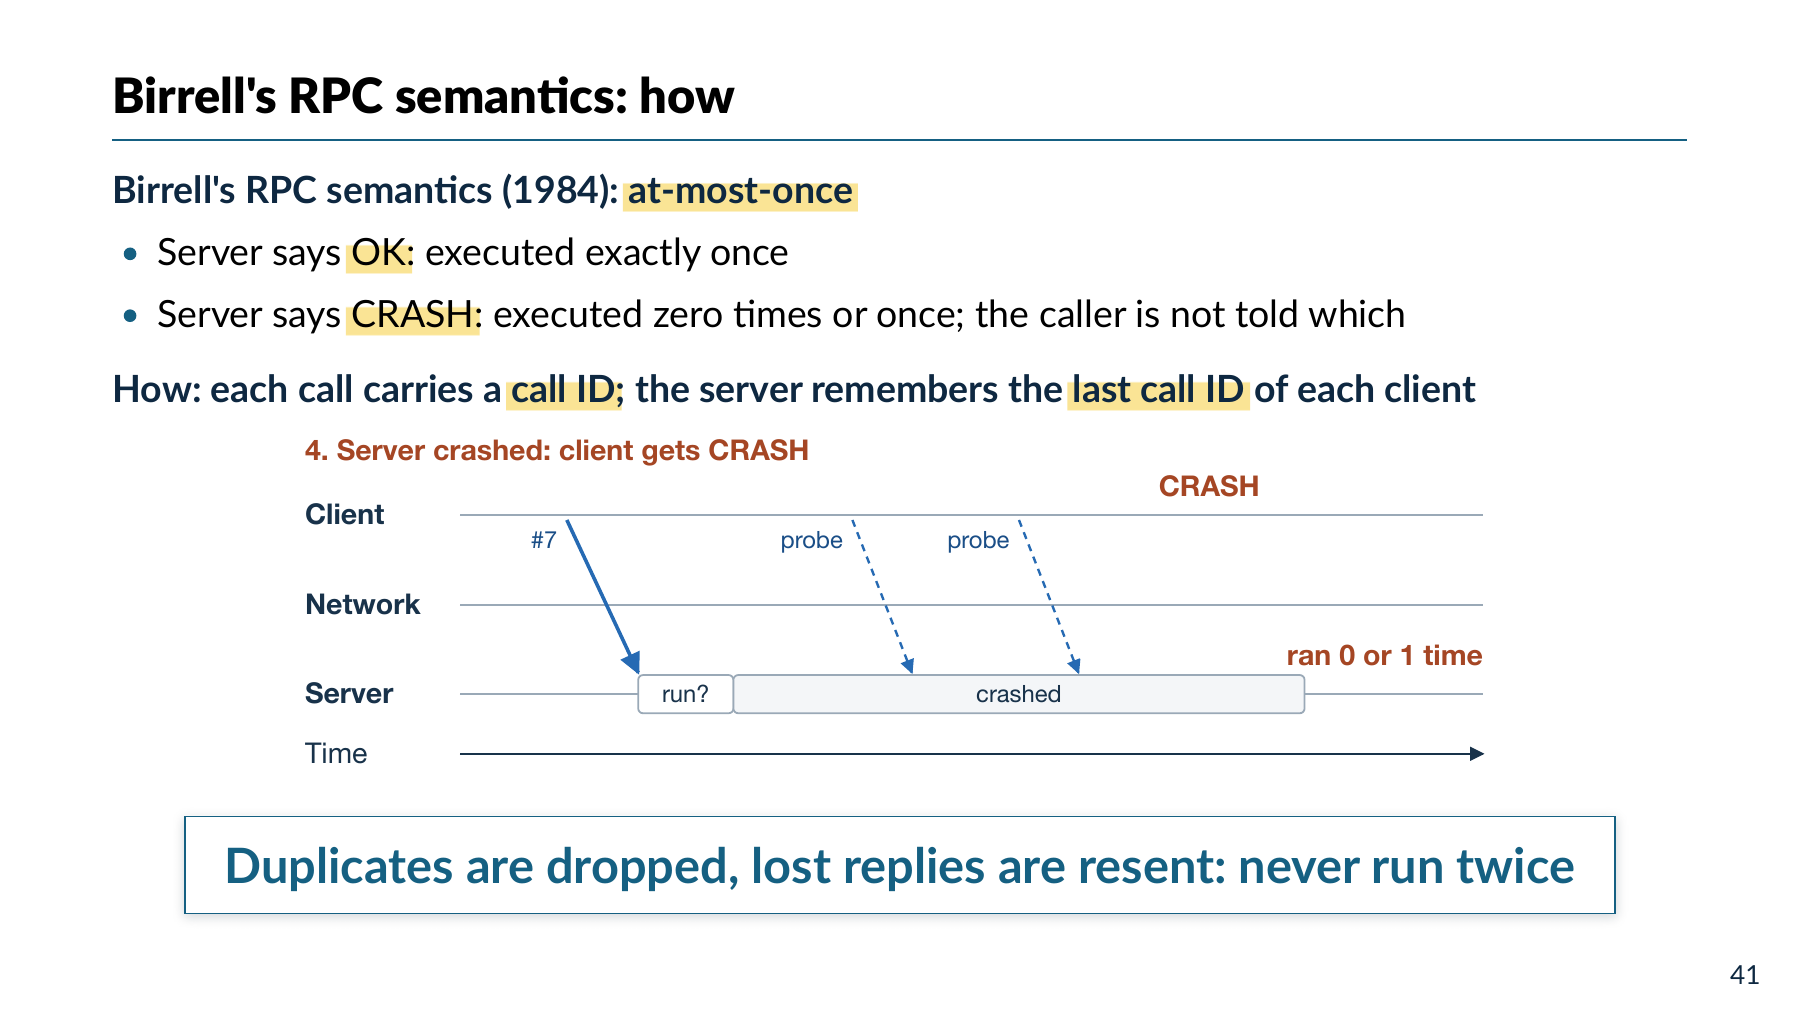
图中的 CRASH 表示客户端还无法确认执行结果。Sun RPC 依赖保存的回复记录识别重复请求,记录淘汰或重启丢失后,请求可能再次执行。要跨重启去重,服务端需要把业务更新和请求 ID 一起持久保存,恢复后先检查记录再处理重试。
思考题:服务器重启后仍要识别重复请求,需要可靠保存哪些信息?若业务修改与完成记录只有一份保存成功,会产生什么问题?
解答:
需要保存稳定请求 ID、执行或提交状态,以及已完成调用的结果,并将完成记录与业务修改一起可靠提交。只保存业务修改时,恢复后可能再次执行;只保存完成记录时,可能返回一个实际未完成的结果。事务或相应日志恢复协议要让两类记录共同生效,并在重试时检查它们。
正在执行
完成结果之外,还要处理首次请求仍在运行时到来的重复请求。例如第一次加款需要 100 ms,客户端在 50 ms 超时并重发,这时回复缓存尚没有完成结果。
服务器可以先按请求身份登记“正在执行”,由一份受协调的执行记录处理业务。重复请求查询到这个状态,就等待原执行或按接口返回处理中;原执行提交后,所有有关等待者取得相同结果。登记、执行状态和提交记录需要配合并发控制,避免两个线程同时把首次请求当作新请求。
缓存回收
每次调用都保留记录,空间会持续增长。假设每秒完成 1000 次新调用,每条记录占 100 B,完全不回收时一天约增加 1000*100*86400=8.64 GB,尚未计入索引和较大的回复。
安全回收需要规定何时同一调用还能重试。可以结合客户端确认、会话期限、调用序号边界等信息,确认旧调用不会再被当成新操作执行。某些方案可以回收具体回复,同时保留完成边界或其他防重信息。
思考题:编号 7 的加款已经完成,回复记录因容量限制被删除。很久以后编号 7 又到达,直接当新请求执行会怎样?
解答:
可能再次加款,产生第二次业务修改。服务器需要依据仍有效的调用身份、完成边界或业务记录判断;超出协议允许的重试范围时,可以要求查询业务状态或返回相应错误。
去重保证需要说明记录保留时间、客户端重启后的身份规则,以及故障恢复条件。删除记录与编号复用要按这些规则共同安排。
重复执行
幂等指同一操作重复执行后的效果与执行一次相同,数学形式为 。代码中,重复执行 i=1,结果始终为 1;重复执行 i++,数值会继续增加。每次加款 100 元同样会累加,需要识别对应的业务操作。
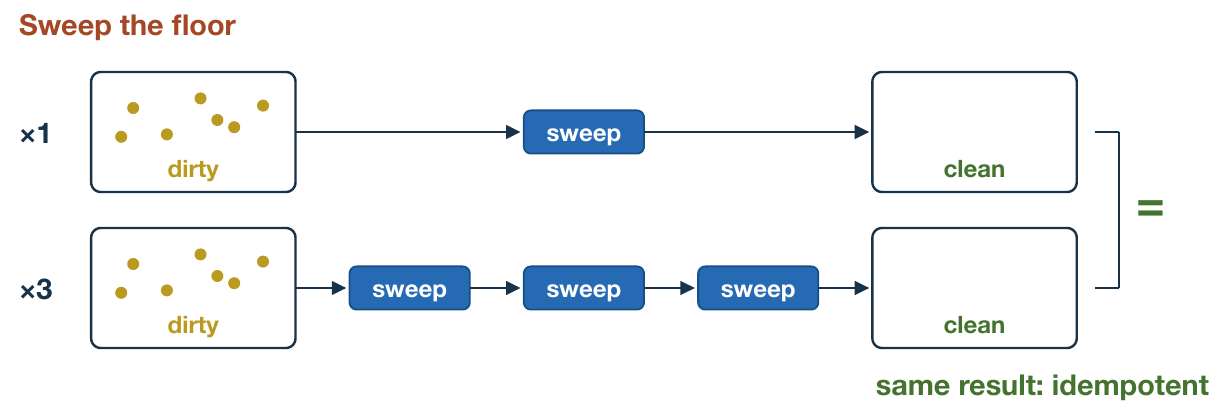
图中把地面状态简化为 dirty(有污物)和 clean(干净)。清扫一次得到 clean,继续清扫两次仍为 clean,因此连续执行一次与三次具有相同的最终状态。这个例子假定清扫期间没有新的污物,只检查最后的地面状态;耗时和执行次数各有自己的记录。
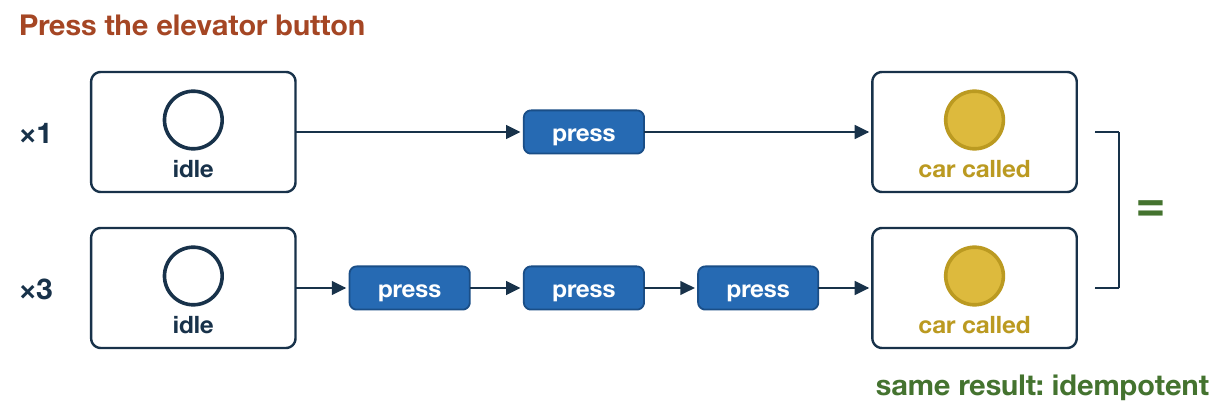
电梯按钮的简化状态包括 idle(尚未呼叫)和 car called(已经呼叫)。第一次按下建立请求、按钮亮起;请求尚未完成时,连续按下仍保留同一请求。完成并复位后,再按则发起下一次请求。判断重复操作,需要明确它对应哪一次业务意图。
幂等性还要与并发规则配合。例如把值设为 1 可以重复执行,但另一请求已经把值改为 2 后,旧请求再次设置 1 会覆盖较新修改。接口可以结合版本检查和请求去重,决定旧请求是否仍允许应用。
思考题:两个用户各请求一次 ReadTime,回复丢失引起重试,服务器实际运行三次。这个结果是否可以接受?什么情况下至少一次重试适用?
解答:
按图中的“取得当前时间”语义,可以接受:第三次读取取得新的当前时间,服务端没有因此累计修改业务状态。返回值会随时钟变化。至少一次重试适用于这样的查询、幂等更新,或具备可靠重复检测的业务;校时程序还需处理读取时刻和网络等待造成的误差。
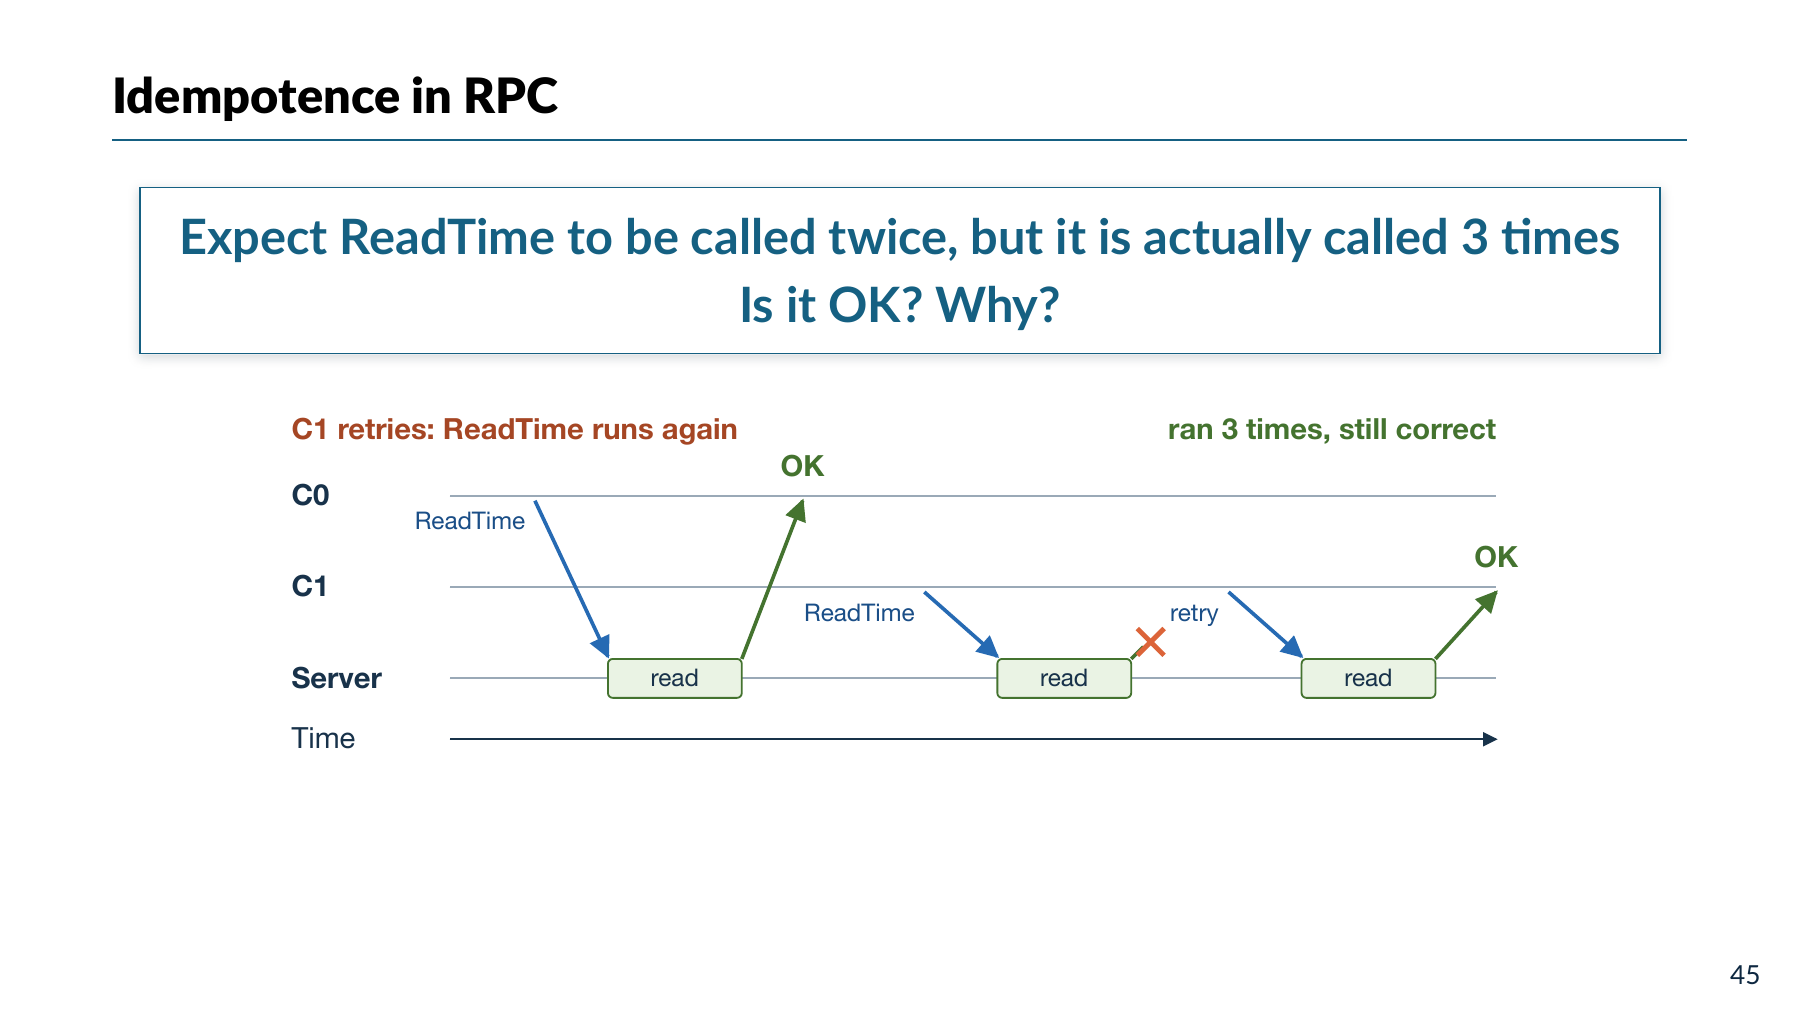
C0、C1 各读一次时间,C1 的回复丢失后又读一次。读时间只取得当前值,可以再次读取;时钟继续走,重试返回的时间也会变化。
思考题:两个点赞请求因重试实际执行三次,计数从预期的 2 变成 3,应怎样处理?投票请求需要依据什么业务身份或操作标识识别重复?
解答:
点赞重复执行会多加一次计数,因此要为每次逻辑点赞分配稳定 ID,重试沿用这个 ID。服务器把 ID 检查、计数更新和完成记录一起提交,重复请求返回已有结果。每人每轮只能投一次时,可按“用户 ID、投票轮次”记录投票;允许改票时,还要定义改票操作,并协调原票与新票的更新。
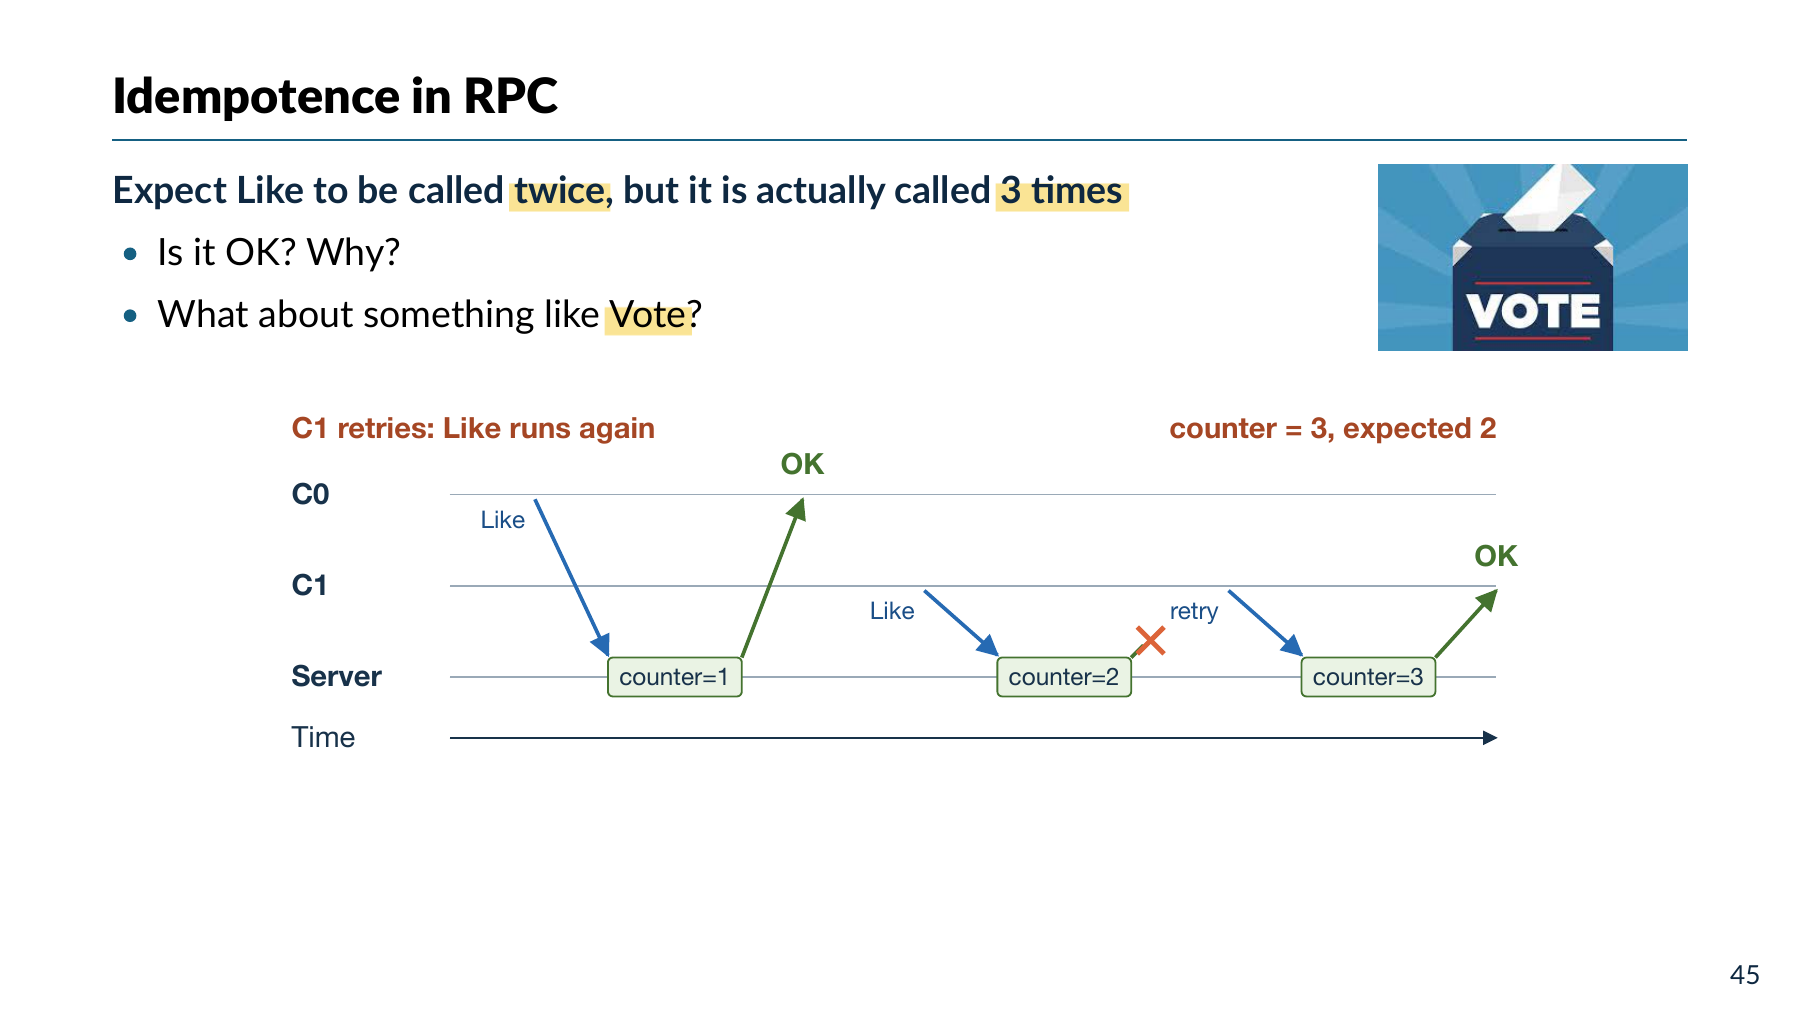
C0 使计数为 1,C1 第一次使其为 2,重试又使其为 3。两次业务意图产生三次状态变化,点赞和投票一类操作需要按业务身份或操作 ID 识别重复。
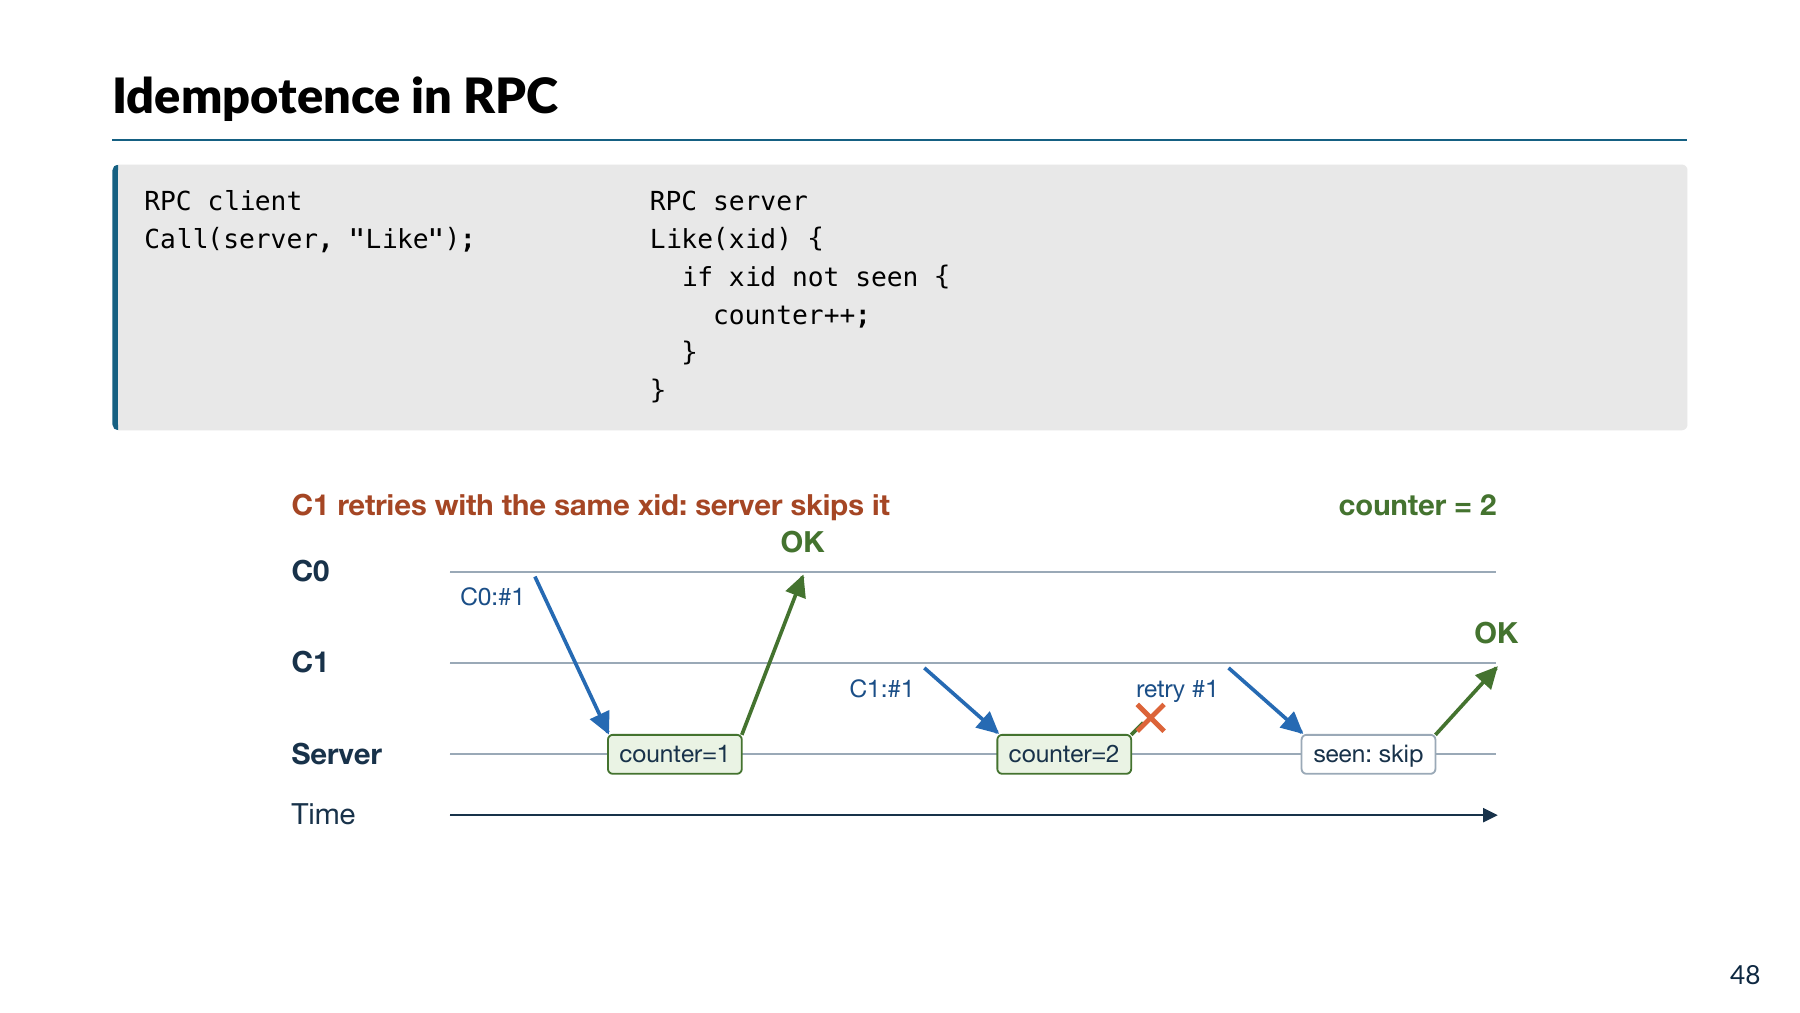
图中 C0:#1 和 C1:#1 是两次调用,C1 重试时继续使用 C1:#1。服务端把请求 ID 和计数更新一起提交,收到重复请求后返回保存的结果。开发者还要规定 ID 保留多久、何时允许复用,以及怎样处理付款等外部操作。
RPC 组成
一次调用依次经过这些组件:业务代码调用客户端存根,编码器生成字节,传输层发送,服务器解析并调用业务函数,回复沿相反路径返回。服务发现负责找到服务器地址;回复匹配负责找到等待调用;重试与去重负责处理等待和重复消息。
RPC 系统包含网络格式、编解码库、存根生成器、服务端分发、客户端回复匹配及重试,以及服务绑定或发现机制。传输可选 TCP、UDP 或适合特定硬件的 RDMA,具体由框架支持范围决定。
在前面的 Sun RPC 例子中,服务器先查回复缓存,找到记录就返回保存的结果,查不到才调用业务函数。Protobuf 例子介绍了编码器怎样把字段和值写成 10 b9 0a。完整调用需要这些组件共同完成参数编码、网络传输和请求处理。
思考题:客户端怎样找到服务端地址?RPC 可以怎样选择 TCP、UDP 或 RDMA 作为传输方式?
解答:
服务地址可来自配置,或通过服务名向注册、发现服务查询。TCP 提供可靠有序字节流,RPC 格式负责划分消息;UDP 发送独立数据报,RPC 框架按协议处理丢失、重排和重试。RDMA 在相应网卡与注册内存条件下访问远端缓冲区。应按硬件、消息大小、等待成本和故障处理要求选择框架支持的传输。
超时重试
退避表示两次尝试之间先等待一段时间,减少故障期间密集重发。maxAttempts=3 包含第一次请求,因此最多重试两次。按示例的基础退避值,第一次失败后等待约 0.1 s,第二次失败后等待约 0.2 s;实际等待还会按框架规则加入调整,并受整次调用的截止时间限制。
gRPC ReadTime 的一组重试配置如下:
| 项目 | 示例值 | 含义 |
|---|---|---|
maxAttempts |
3 | 包含首次调用,最多再试两次 |
initialBackoff |
0.1 s | 初始退避 |
maxBackoff |
1 s | 退避上限 |
backoffMultiplier |
2 | 基础等待时间逐次增加 |
retryableStatusCodes |
UNAVAILABLE | 仅对选定状态考虑重试 |
实际重试还要检查调用期限和处理状态,并按框架规则等待。ReadTime 可以再次读取时间;Like 会增加计数,需要用请求 ID 避免重复增加。定义接口时,应把重试条件和结果确认办法一起写清楚。
有限重试到达次数或截止时间上限后,可以返回失败或结果未确认,由应用继续查询与处理。永久故障下,重复发送也无法保证完成。至多一次主要约束重复效果,至少一次的完成还依赖持续重试和故障恢复等条件。gRPC 重试文档说明了策略、退避和提交后的重试边界。
参考资料
- Birrell 与 Nelson,1984,Implementing Remote Procedure Calls,RPC 的结构与失败处理。
- IETF,RFC 5905,NTP 校时;RFC 8259,JSON 数据交换。
- Protobuf,编码说明,Tag、Varint 与线型。
- gRPC,服务定义与重试文档。
- Linux,网络扩展文档,硬件队列与流量分发。
- Lu 等,2024,Serialization/Deserialization-free State Transfer in Serverless Workflows,Dmerge 与远端内存映射。