图与表示
图 G = ( V , E ) G=(V,E) G = ( V , E ) V V V E E E ( u , v ) (u,v) ( u , v ) u u u v v v n = ∣ V ∣ n=|V| n = ∣ V ∣ m = ∣ E ∣ m=|E| m = ∣ E ∣
课件中的线性时间 O ( n + m ) O(n+m) O ( n + m ) 邻接表 :对每个顶点存储其邻居或出边,遍历全图只需扫描全部顶点和全部邻接表。无向边通常在两个端点的表中各存一次;有向边只存入起点的出边表。若改用邻接矩阵,每次找邻居可能需要扫描一整行,同样的遍历实现就可能花 O ( n 2 ) O(n^2) O ( n 2 )
深度搜索
深度优先搜索 (DFS)沿尚未访问的邻居不断深入,当前顶点的邻居都处理完后再返回。课件先给出从单个顶点出发的 EXPLORE,其中 PREVISIT、POSTVISIT 分别在进入和离开顶点时执行,后文会用它们记录分量编号与访问时刻。
算法:EXPLORE ( G , v ) v i s i t e d [ v ] = true PREVISIT ( v ) for u ∈ Adj ( v ) do if ¬ v i s i t e d [ u ] then EXPLORE ( G , u ) POSTVISIT ( v ) \begin{array}{l}
\hline
\textbf{算法:EXPLORE}(G,v) \\[4pt]
\hline
visited[v]=\text{true} \\
\text{PREVISIT}(v) \\
\textbf{for}\ u\in\operatorname{Adj}(v)\ \textbf{do} \\
\qquad\textbf{if}\ \neg visited[u]\ \textbf{then}\ \text{EXPLORE}(G,u) \\
\text{POSTVISIT}(v) \\
\hline
\end{array}
算法: EXPLORE ( G , v ) v i s i t e d [ v ] = true PREVISIT ( v ) for u ∈ Adj ( v ) do if ¬ v i s i t e d [ u ] then EXPLORE ( G , u ) POSTVISIT ( v )
正确性 :若所有顶点初始均未访问,EXPLORE( G , v ) (G,v) ( G , v ) v v v
每次递归都沿图中的边前进,因此新访问的顶点一定从 v v v v v v u u u u u u
单次 EXPLORE 不一定覆盖全图,因此完整 DFS 还需要外层循环:
算法:DFS ( G ) for v ∈ V do v i s i t e d [ v ] = false for v ∈ V do if ¬ v i s i t e d [ v ] then EXPLORE ( G , v ) \begin{array}{l}
\hline
\textbf{算法:DFS}(G) \\[4pt]
\hline
\textbf{for}\ v\in V\ \textbf{do}\ visited[v]=\text{false} \\
\textbf{for}\ v\in V\ \textbf{do} \\
\qquad\textbf{if}\ \neg visited[v]\ \textbf{then}\ \text{EXPLORE}(G,v) \\
\hline
\end{array}
算法: DFS ( G ) for v ∈ V do v i s i t e d [ v ] = false for v ∈ V do if ¬ v i s i t e d [ v ] then EXPLORE ( G , v )
每个顶点只进入 EXPLORE 一次,标记和访问钩子的总代价是 O ( n ) O(n) O ( n ) O ( m ) O(m) O ( m ) O ( n + m ) O(n+m) O ( n + m ) O ( n ) O(n) O ( n )
连通分量
无向图中,若任意两个顶点之间都有路径,图就连通。连通分量 是极大的连通顶点集合,分量之间没有边。从一个顶点运行 EXPLORE 恰好找出它所在的分量;完整 DFS 外层循环每次启动新的 EXPLORE,就开始处理一个新分量。
给每个顶点记录 ccnum[v],可在 PREVISIT 中令 ccnum[v]=cc,并在 DFS 外层每次启动搜索前把 cc 加 1。最后 cc 是分量数;两个顶点的编号相同,当且仅当它们在同一个分量中。非空无向图连通,当且仅当分量数为 1。
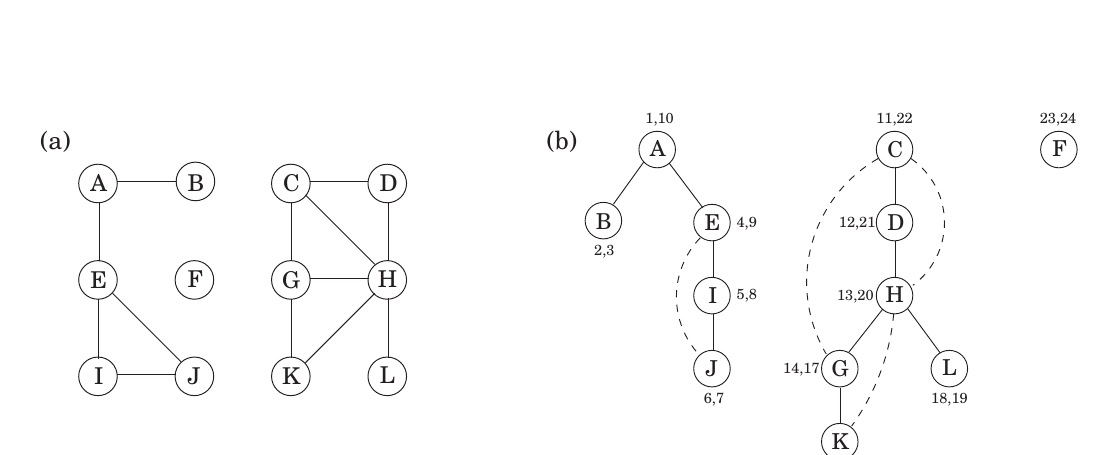
递归第一次发现新顶点时使用的边构成DFS 树边 ,多次搜索则得到 DFS 森林。无向图其余的非树边连接一个顶点与它的祖先,称为后向边 。若一条非树边连接两个互不为祖先的分支,较早被搜索的分支会沿这条边发现另一端,使另一端成为其后代,故这种情况不能发生。扫描无向树边的反方向时,应将它识别为同一条树边。
第六讲最初的 12 点无向例图有两个分量:A A A J J J K , L K,L K , L A − C A-C A − C E − J E-J E − J D − H D-H D − H K K K L L L
练习 3.11:给定无向图 G G G e e e e e e
本题考查搜索可达性,以及边位于环上与删边后端点仍连通的等价关系。
设 e = { u , v } e=\{u,v\} e = { u , v } u u u e e e G − e G-e G − e v v v
伪代码将邻接表项写成 ( v , f ) (v,f) ( v , f ) e e e
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// 在忽略指定边 e 后检查其两个端点是否仍然连通。 function CYCLE-THROUGH-EDGE(G = (V, E), e = {s, t}): for each v in V: visited[v] ← FALSE visited[s] ← TRUE Q ← 空队列 ENQUEUE(Q, s) while Q is not empty: u ← DEQUEUE(Q) for each (v, f) in Adj(u): if f = e: continue if visited[v] = FALSE: visited[v] ← TRUE ENQUEUE(Q, v) return visited[t]
正确性由以下等价关系得到:
e 位于某个环上 ⟺ G − e 中存在从 u 到 v 的路径 . e\text{ 位于某个环上}
\iff
G-e\text{ 中存在从 }u\text{ 到 }v\text{ 的路径}.
e 位于某个环上 ⟺ G − e 中存在从 u 到 v 的路径 .
若存在包含 e e e e e e u u u v v v e e e u u u v v v e e e
搜索只需 O ( ∣ V ∣ + ∣ E ∣ ) O(|V|+|E|) O ( ∣ V ∣ + ∣ E ∣ ) O ( ∣ V ∣ ) O(|V|) O ( ∣ V ∣ ) e e e
访问时刻
令全局计数器 clock 从 1 开始。在 PREVISIT 中记录 pre[v]=clock,在 POSTVISIT 中记录 post[v]=clock,每记录一次就将计数器加 1。每个顶点有一个进入时刻和一个退出时刻,整个搜索共得到 2 n 2n 2 n
课件图中的三个分量分别由 A A A C C C F F F A A A [ 1 , 10 ] [1,10] [ 1 , 10 ] C C C [ 11 , 22 ] [11,22] [ 11 , 22 ] F F F [ 23 , 24 ] [23,24] [ 23 , 24 ] E E E [ 4 , 9 ] [4,9] [ 4 , 9 ] I I I [ 5 , 8 ] [5,8] [ 5 , 8 ] J J J [ 6 , 7 ] [6,7] [ 6 , 7 ] B B B [ 2 , 3 ] [2,3] [ 2 , 3 ]
区间引理 :任意两个顶点的访问区间,要么互不相交,要么一个严格包含另一个。
若 v v v u u u v v v u u u v v v u u u v v v u u u
于是可以从时刻判断祖先关系。若 v v v u u u
p r e [ u ] < p r e [ v ] < p o s t [ v ] < p o s t [ u ] . pre[u]<pre[v]<post[v]<post[u].
p re [ u ] < p re [ v ] < p os t [ v ] < p os t [ u ] .
边的分类
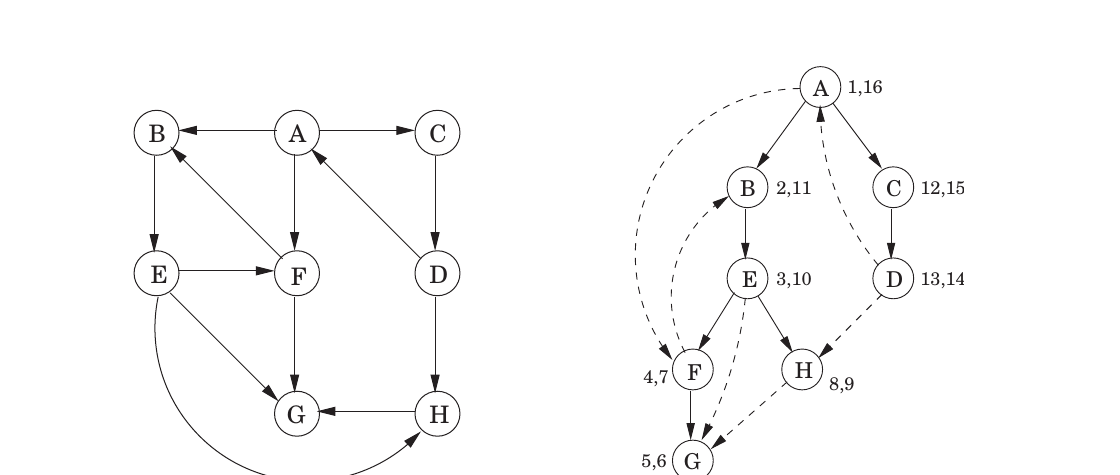
有向图的 DFS 仍然得到搜索森林,但非树边可以有更多类型:树边属于搜索森林;前向边 指向非孩子的后代;后向边 指向祖先;交叉边 连接互不为祖先的顶点。根、父亲、孩子、祖先、后代都相对于本次 DFS 森林而言,访问顺序不同,分类也可能不同。
图中 A A A A → B A\to B A → B B → E B\to E B → E E → F E\to F E → F F → G F\to G F → G E → H E\to H E → H A → C A\to C A → C C → D C\to D C → D F → B F\to B F → B D → A D\to A D → A A → F A\to F A → F E → G E\to G E → G H → G H\to G H → G D → H D\to H D → H A : ( 1 , 16 ) A:(1,16) A : ( 1 , 16 ) B : ( 2 , 11 ) B:(2,11) B : ( 2 , 11 ) E : ( 3 , 10 ) E:(3,10) E : ( 3 , 10 ) F : ( 4 , 7 ) F:(4,7) F : ( 4 , 7 ) G : ( 5 , 6 ) G:(5,6) G : ( 5 , 6 ) H : ( 8 , 9 ) H:(8,9) H : ( 8 , 9 ) C : ( 12 , 15 ) C:(12,15) C : ( 12 , 15 ) D : ( 13 , 14 ) D:(13,14) D : ( 13 , 14 )
记 p ( u ) = p r e [ u ] p(u)=pre[u] p ( u ) = p re [ u ] q ( u ) = p o s t [ u ] q(u)=post[u] q ( u ) = p os t [ u ] ( u , v ) (u,v) ( u , v )
类型
时刻关系
树边或前向边
p ( u ) < p ( v ) < q ( v ) < q ( u ) p(u)<p(v)<q(v)<q(u) p ( u ) < p ( v ) < q ( v ) < q ( u )
后向边
p ( v ) < p ( u ) < q ( u ) < q ( v ) p(v)<p(u)<q(u)<q(v) p ( v ) < p ( u ) < q ( u ) < q ( v )
交叉边
p ( v ) < q ( v ) < p ( u ) < q ( u ) p(v)<q(v)<p(u)<q(u) p ( v ) < q ( v ) < p ( u ) < q ( u )
时刻关系不能单独区分树边与前向边,还需看 parent[v] 是否为 u u u u → u u\to u u → u
课件提问:上述区间排列是否已经穷尽?
对端点不同的有向边,是的。区间交错已被区间引理排除;剩下的“u u u v v v u → v u\to v u → v v v v
拓扑排序
有向无环图 (DAG)不含有向环。课件中的 DAG 可以表示任务依赖:一条边 u → v u\to v u → v u u u v v v
环判定 :有向图有环,当且仅当 DFS 出现后向边。
若有后向边 u → v u\to v u → v v v v u u u v v v v v v
实现时可把顶点分为未访问、搜索中、已结束三种状态;扫描到指向“搜索中”顶点的边,就发现了环。
拓扑排序 把全部顶点排列成一个序列,使每条边都从较早的顶点指向较晚的顶点。DAG 的每条边 ( u , v ) (u,v) ( u , v ) p o s t [ u ] > p o s t [ v ] post[u]>post[v] p os t [ u ] > p os t [ v ]
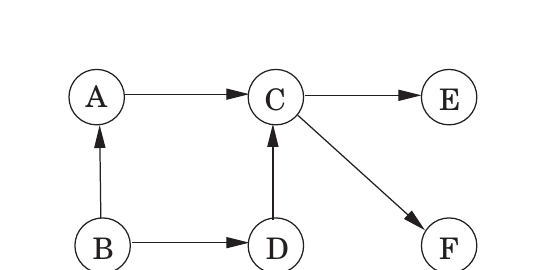
图中边为 B → A B\to A B → A B → D B\to D B → D A → C A\to C A → C D → C D\to C D → C C → E C\to E C → E C → F C\to F C → F B , A , D , C , E , F B,A,D,C,E,F B , A , D , C , E , F B , D , A , C , F , E B,D,A,C,F,E B , D , A , C , F , E A A A D D D E E E F F F
课件提问:哪些 DAG 可以线性化?
所有有限 DAG 都可以。反过来,若有有向环,环上每个顶点都必须先于下一个顶点,无法形成线性序列。无环、存在拓扑序、DFS 没有后向边三者等价。
不必真的对退出时刻排序:在 POSTVISIT 时把顶点追加到列表,最后反转列表即可,时间仍是 O ( n + m ) O(n+m) O ( n + m )
非空 DAG 至少有一个源点 (入度为 0)和一个汇点 (出度为 0)。若每个顶点都有入边,不断沿入边逆向追溯,有限顶点迫使某个顶点重复,从而形成环;汇点的证明对出边同理。拓扑序的第一个顶点必为源点,最后一个必为汇点。
另一种拓扑排序是反复输出源点并删除它,即 Kahn 算法 。先计算所有入度,把入度为 0 的顶点入队;弹出顶点 u u u O ( n + m ) O(n+m) O ( n + m ) n n n
强连通分量
有向图中,仅有 u u u v v v u u u v v v v v v u u u 互相可达 。这个关系具有自反性、对称性和传递性,因而把顶点划分成互不相交的强连通分量 (SCC)。单个顶点也可以构成一个 SCC。
把每个 SCC 收缩成一个顶点,保留不同分量之间的边,得到缩点图 。缩点图一定是 DAG:若几个不同分量在缩点图中形成环,它们就可以沿这个环互相到达,应属于同一个分量,产生矛盾。
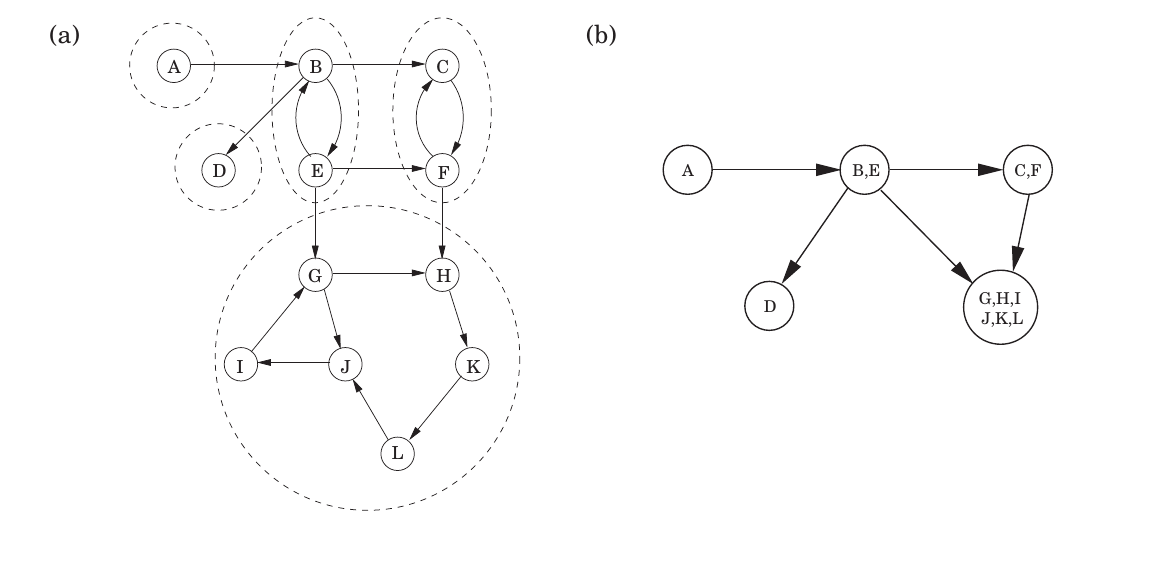
课件例子共有五个 SCC:{ A } \{A\} { A } { B , E } \{B,E\} { B , E } { C , F } \{C,F\} { C , F } { D } \{D\} { D } { G , H , I , J , K , L } \{G,H,I,J,K,L\} { G , H , I , J , K , L } G → H → K → L → J → I → G G\to H\to K\to L\to J\to I\to G G → H → K → L → J → I → G { A } \{A\} { A } { D } \{D\} { D }
从一个汇 SCC 内的顶点运行 EXPLORE,不会走到别的分量,恰好得到这个 SCC。于是算法的关键变成:如何找到汇 SCC,再如何依次处理剩余分量?
退出时刻引理 :若不同 SCC C , C ′ C,C' C , C ′ C → C ′ C\to C' C → C ′ C C C C ′ C' C ′
若 DFS 先进入 C C C C ′ C' C ′ C ′ C' C ′ C C C C ′ C' C ′ C C C
令 G R G^R G R G G G G R G^R G R G R G^R G R
Kosaraju 算法 采用两遍搜索:
算法:SCC ( G ) 构造反向图 G R 在 G R 上执行 DFS,按退出先后记录列表 L 将原图所有顶点重置为未访问,令 c c = 0 for v ∈ reverse ( L ) do if ¬ v i s i t e d [ v ] then c c = c c + 1 在 G 上从 v 执行 EXPLORE 给本次新访问的全部顶点标记分量 c c \begin{array}{l}
\hline
\textbf{算法:SCC}(G) \\[4pt]
\hline
\text{构造反向图 }G^R \\
\text{在 }G^R\text{ 上执行 DFS,按退出先后记录列表 }L \\
\text{将原图所有顶点重置为未访问,令 }cc=0 \\
\textbf{for}\ v\in\operatorname{reverse}(L)\ \textbf{do} \\
\qquad\textbf{if}\ \neg visited[v]\ \textbf{then} \\
\qquad\qquad cc=cc+1 \\
\qquad\qquad\text{在 }G\text{ 上从 }v\text{ 执行 EXPLORE} \\
\qquad\qquad\text{给本次新访问的全部顶点标记分量 }cc \\
\hline
\end{array}
算法: SCC ( G ) 构造反向图 G R 在 G R 上执行 DFS ,按退出先后记录列表 L 将原图所有顶点重置为未访问,令 cc = 0 for v ∈ reverse ( L ) do if ¬ v i s i t e d [ v ] then cc = cc + 1 在 G 上从 v 执行 EXPLORE 给本次新访问的全部顶点标记分量 cc
第二遍搜索每次选取尚未访问顶点中,反向图退出时刻最大的顶点。它属于剩余原图的汇 SCC;已处理分量用 visited 跳过,效果等同于删除它们。归纳可得每次搜索恰好输出一个 SCC。构造反向图、两遍 DFS、反转退出列表均为 O ( n + m ) O(n+m) O ( n + m ) O ( n + m ) O(n+m) O ( n + m ) { C , F } \{C,F\} { C , F } { B , E } \{B,E\} { B , E } { A } \{A\} { A }
思考:图非常巨大时,SCC 算法如何工作?
内存能容纳邻接表时,仍然按 O ( n + m ) O(n+m) O ( n + m )
思考:把“路径”换成“边”会怎样?
若按字面把互相可达改成“两个顶点间互有直接边”,关系不再传递:u ↔ v u\leftrightarrow v u ↔ v v ↔ w v\leftrightarrow w v ↔ w u ↔ w u\leftrightarrow w u ↔ w
练习 3.28:2SAT 的每个子句是两个文字的析取(逻辑或);文字是一个布尔变量或它的否定。要求为每个变量赋真或假,使所有子句都至少有一个真文字。考虑下面的实例:
Φ = ( x 1 ∨ x 2 ‾ ) ∧ ( x 1 ‾ ∨ x 3 ‾ ) ∧ ( x 1 ∨ x 2 ) ∧ ( x 3 ‾ ∨ x 4 ) ∧ ( x 1 ‾ ∨ x 4 ) \Phi=(x_1\lor\overline{x_2})\land(\overline{x_1}\lor\overline{x_3})\land(x_1\lor x_2)\land(\overline{x_3}\lor x_4)\land(\overline{x_1}\lor x_4) Φ = ( x 1 ∨ x 2 ) ∧ ( x 1 ∨ x 3 ) ∧ ( x 1 ∨ x 2 ) ∧ ( x 3 ∨ x 4 ) ∧ ( x 1 ∨ x 4 )
该实例的一个满足赋值为 ( x 1 , x 2 , x 3 , x 4 ) = ( 1 , 0 , 0 , 1 ) (x_1,x_2,x_3,x_4)=(1,0,0,1) ( x 1 , x 2 , x 3 , x 4 ) = ( 1 , 0 , 0 , 1 ) 1 1 1 0 0 0
本题考查逻辑蕴含的建图、强连通分量、缩点 DAG 和拓扑序赋值。
(a) 这个公式是否还有其他满足赋值?若有,找出全部满足赋值。
第一、第三个子句同时成立要求
( x 1 ∨ x 2 ‾ ) ∧ ( x 1 ∨ x 2 ) ≡ x 1 , (x_1\lor\overline{x_2})\land(x_1\lor x_2)
\equiv x_1,
( x 1 ∨ x 2 ) ∧ ( x 1 ∨ x 2 ) ≡ x 1 ,
故 x 1 = 1 x_1=1 x 1 = 1 x 3 = 0 x_3=0 x 3 = 0 x 4 = 1 x_4=1 x 4 = 1 x 2 x_2 x 2
( x 1 , x 2 , x 3 , x 4 ) ∈ { ( 1 , 0 , 0 , 1 ) , ( 1 , 1 , 0 , 1 ) } . (x_1,x_2,x_3,x_4)\in\{(1,0,0,1),(1,1,0,1)\}.
( x 1 , x 2 , x 3 , x 4 ) ∈ {( 1 , 0 , 0 , 1 ) , ( 1 , 1 , 0 , 1 )} .
除题目已给出的赋值外,只有 ( 1 , 1 , 0 , 1 ) (1,1,0,1) ( 1 , 1 , 0 , 1 )
(b) 给出一个包含四个变量、没有满足赋值的 2SAT 实例。
取
Ψ = ( x 1 ∨ x 2 ) ∧ ( x 1 ∨ x 2 ‾ ) ∧ ( x 1 ‾ ∨ x 2 ) ∧ ( x 1 ‾ ∨ x 2 ‾ ) ∧ ( x 3 ∨ x 4 ) . \Psi=(x_1\lor x_2)\land(x_1\lor\overline{x_2})
\land(\overline{x_1}\lor x_2)\land(\overline{x_1}\lor\overline{x_2})
\land(x_3\lor x_4).
Ψ = ( x 1 ∨ x 2 ) ∧ ( x 1 ∨ x 2 ) ∧ ( x 1 ∨ x 2 ) ∧ ( x 1 ∨ x 2 ) ∧ ( x 3 ∨ x 4 ) .
前两个子句的合取等价于 x 1 x_1 x 1 x 1 ‾ \overline{x_1} x 1 Ψ \Psi Ψ
本题通过强连通分量求解 2SAT。对含 n n n m m m I I I G I = ( V , E ) G_I=(V,E) G I = ( V , E )
G I G_I G I 2 n 2n 2 n
G I G_I G I 2 m 2m 2 m ( α ∨ β ) (\alpha\lor\beta) ( α ∨ β ) α ‾ → β \overline\alpha\to\beta α → β β ‾ → α \overline\beta\to\alpha β → α
子句 ( α ∨ β ) (\alpha\lor\beta) ( α ∨ β ) α ‾ ⇒ β \overline\alpha\Rightarrow\beta α ⇒ β β ‾ ⇒ α \overline\beta\Rightarrow\alpha β ⇒ α
© 分别为题目给出的实例和 (b) 中构造的实例建立蕴含图。
两图的顶点集均为
V = { x 1 , x 1 ‾ , x 2 , x 2 ‾ , x 3 , x 3 ‾ , x 4 , x 4 ‾ } . V=\{x_1,\overline{x_1},x_2,\overline{x_2},
x_3,\overline{x_3},x_4,\overline{x_4}\}.
V = { x 1 , x 1 , x 2 , x 2 , x 3 , x 3 , x 4 , x 4 } .
G Φ G_\Phi G Φ
( x 1 ∨ x 2 ‾ ) : x 1 ‾ → x 2 ‾ , x 2 → x 1 , ( x 1 ‾ ∨ x 3 ‾ ) : x 1 → x 3 ‾ , x 3 → x 1 ‾ , ( x 1 ∨ x 2 ) : x 1 ‾ → x 2 , x 2 ‾ → x 1 , ( x 3 ‾ ∨ x 4 ) : x 3 → x 4 , x 4 ‾ → x 3 ‾ , ( x 1 ‾ ∨ x 4 ) : x 1 → x 4 , x 4 ‾ → x 1 ‾ . \begin{aligned}
(x_1\lor\overline{x_2})&:\quad
\overline{x_1}\to\overline{x_2},\quad x_2\to x_1,\\
(\overline{x_1}\lor\overline{x_3})&:\quad
x_1\to\overline{x_3},\quad x_3\to\overline{x_1},\\
(x_1\lor x_2)&:\quad
\overline{x_1}\to x_2,\quad\overline{x_2}\to x_1,\\
(\overline{x_3}\lor x_4)&:\quad
x_3\to x_4,\quad\overline{x_4}\to\overline{x_3},\\
(\overline{x_1}\lor x_4)&:\quad
x_1\to x_4,\quad\overline{x_4}\to\overline{x_1}.
\end{aligned}
( x 1 ∨ x 2 ) ( x 1 ∨ x 3 ) ( x 1 ∨ x 2 ) ( x 3 ∨ x 4 ) ( x 1 ∨ x 4 ) : x 1 → x 2 , x 2 → x 1 , : x 1 → x 3 , x 3 → x 1 , : x 1 → x 2 , x 2 → x 1 , : x 3 → x 4 , x 4 → x 3 , : x 1 → x 4 , x 4 → x 1 .
G Ψ G_\Psi G Ψ
( x 1 ∨ x 2 ) : x 1 ‾ → x 2 , x 2 ‾ → x 1 , ( x 1 ∨ x 2 ‾ ) : x 1 ‾ → x 2 ‾ , x 2 → x 1 , ( x 1 ‾ ∨ x 2 ) : x 1 → x 2 , x 2 ‾ → x 1 ‾ , ( x 1 ‾ ∨ x 2 ‾ ) : x 1 → x 2 ‾ , x 2 → x 1 ‾ , ( x 3 ∨ x 4 ) : x 3 ‾ → x 4 , x 4 ‾ → x 3 . \begin{aligned}
(x_1\lor x_2)&:\quad
\overline{x_1}\to x_2,\quad\overline{x_2}\to x_1,\\
(x_1\lor\overline{x_2})&:\quad
\overline{x_1}\to\overline{x_2},\quad x_2\to x_1,\\
(\overline{x_1}\lor x_2)&:\quad
x_1\to x_2,\quad\overline{x_2}\to\overline{x_1},\\
(\overline{x_1}\lor\overline{x_2})&:\quad
x_1\to\overline{x_2},\quad x_2\to\overline{x_1},\\
(x_3\lor x_4)&:\quad
\overline{x_3}\to x_4,\quad\overline{x_4}\to x_3.
\end{aligned}
( x 1 ∨ x 2 ) ( x 1 ∨ x 2 ) ( x 1 ∨ x 2 ) ( x 1 ∨ x 2 ) ( x 3 ∨ x 4 ) : x 1 → x 2 , x 2 → x 1 , : x 1 → x 2 , x 2 → x 1 , : x 1 → x 2 , x 2 → x 1 , : x 1 → x 2 , x 2 → x 1 , : x 3 → x 4 , x 4 → x 3 .
G Φ G_\Phi G Φ G Ψ G_\Psi G Ψ { x 1 , x 1 ‾ , x 2 , x 2 ‾ } \{x_1,\overline{x_1},x_2,\overline{x_2}\} { x 1 , x 1 , x 2 , x 2 }
(d) 证明:若 G I G_I G I x x x x ‾ \overline x x I I I
满足赋值必须满足图中每条蕴含边,因此真值会沿有向路径传递。若 x x x x ‾ \overline{x} x
x ⇝ x ‾ , x ‾ ⇝ x . x\leadsto\overline{x},\qquad\overline{x}\leadsto x.
x ⇝ x , x ⇝ x .
若 x x x x ‾ \overline{x} x x x x x ‾ \overline{x} x x x x
(e) 证明 (d) 的逆命题:若没有任何强连通分量同时包含一个文字及其否定,则 I I I
对每条边 ℓ → r \ell\to r ℓ → r r ‾ → ℓ ‾ \overline r\to\overline\ell r → ℓ C C C C ‾ \overline C C C ≠ C ‾ C\ne\overline C C = C
将 SCC 缩点得到 DAG,并取一个拓扑序。令 t ( C ) t(C) t ( C ) C C C ℓ \ell ℓ
ℓ 为真 ⟺ t ( C ( ℓ ) ) > t ( C ( ℓ ‾ ) ) . \ell\text{ 为真}
\iff
t(C(\ell))>t(C(\overline\ell)).
ℓ 为真 ⟺ t ( C ( ℓ )) > t ( C ( ℓ )) .
其中 C ( ℓ ) C(\ell) C ( ℓ ) ℓ \ell ℓ
若某条边 ℓ → r \ell\to r ℓ → r
t ( C ( ℓ ‾ ) ) < t ( C ( ℓ ) ) ≤ t ( C ( r ) ) < t ( C ( r ‾ ) ) ≤ t ( C ( ℓ ‾ ) ) , t(C(\overline\ell))
<t(C(\ell))
\le t(C(r))
<t(C(\overline r))
\le t(C(\overline\ell)),
t ( C ( ℓ )) < t ( C ( ℓ )) ≤ t ( C ( r )) < t ( C ( r )) ≤ t ( C ( ℓ )) ,
矛盾。因此没有蕴含边从真指向假。若某个子句 ( α ∨ β ) (\alpha\lor\beta) ( α ∨ β ) α ‾ \overline\alpha α β \beta β α ‾ → β \overline\alpha\to\beta α → β
这也实现了提示中的汇分量构造:按拓扑序从后向前处理尚未赋值的分量,将它设为真、将其否定分量设为假,已赋值的分量直接跳过。
(f) 据此给出线性时间的 2SAT 求解算法。
先为每个子句加入两条蕴含边,再用 Kosaraju 或 Tarjan 算法一次性求出所有 SCC。若某个 x i x_i x i x i ‾ \overline{x_i} x i
伪代码中,SCC 返回每个文字的分量编号 comp,拓扑排序按从源到汇的顺序排列分量。缩点时可保留重边,拓扑排序按实际边数统计入度,无须额外排序去重。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// 建立蕴含图、检查矛盾并生成满足赋值;¬ 表示文字取反。 function SOLVE-2SAT(n, clauses): G ← 顶点集为 {x_i, ¬x_i : 1 ≤ i ≤ n} 的空有向图 for each clause (α ∨ β) in clauses: ADD-EDGE(G, ¬α, β) ADD-EDGE(G, ¬β, α) comp ← SCC(G) for i ← 1 to n: if comp[x_i] = comp[¬x_i]: return UNSAT H ← 每个分量对应一个顶点的空有向图 for each edge (u, v) in E(G): if comp[u] ≠ comp[v]: ADD-EDGE(H, comp[u], comp[v]) order ← TOPOLOGICAL-SORT(H) for j ← 1 to length(order): t[order[j]] ← j for i ← 1 to n: value[x_i] ← (t[comp[x_i]] > t[comp[¬x_i]]) return (SAT, value)
图有 2 n 2n 2 n 2 m 2m 2 m
T ( n , m ) = O ( n + m ) , S ( n , m ) = O ( n + m ) . T(n,m)=O(n+m),\qquad S(n,m)=O(n+m).
T ( n , m ) = O ( n + m ) , S ( n , m ) = O ( n + m ) .
无需每删除一个汇分量就重新计算 SCC。
分解练习
练习 3.16:所有课程必修,先修关系用 DAG 表示,一学期可选任意多门课。如何在线性时间内计算最少学期数?
对图拓扑排序。令 sem[v] 表示最早可修 v v v u → v u\to v u → v sem[v] 更新为 sem[v] 和 sem[u]+1 中较大的值。所有前驱都处理完后,v v v sem[v] 的最大值。时间 O ( n + m ) O(n+m) O ( n + m )
正确性来自先修约束:v v v v v v k k k k k k B B B A , D A,D A , D C C C E , F E,F E , F
练习 3.22:判断有向图中是否存在一个顶点,能到达所有其他顶点。
在 DFS 外层循环中记住最后一次启动 EXPLORE 的顶点 r r r r r r O ( n + m ) O(n+m) O ( n + m )
若图没有顶点,直接返回不存在;单个顶点则自然满足条件。
若这样的顶点 s s s s s s
从缩点图看,这也等价于存在唯一的源 SCC。DAG 中每个顶点都可追溯到某个源点;源点唯一时,它就能到达全部分量,该源 SCC 中任一顶点都是答案。课件的 SCC 例子中,A A A
广度搜索
在无权图中,路径长度是边数;s s s v v v δ ( s , v ) \delta(s,v) δ ( s , v ) ∞ \infty ∞ 广度优先搜索 (BFS)使用先进先出的队列,按距离层次依次处理顶点。
算法:BFS ( G , s ) for v ∈ V do d i s t [ v ] = ∞ , p r e v [ v ] = nil d i s t [ s ] = 0 , Q = [ s ] while Q ≠ [ ] do u = EJECT ( Q ) for v ∈ Adj ( u ) do if d i s t [ v ] = ∞ then d i s t [ v ] = d i s t [ u ] + 1 , p r e v [ v ] = u INJECT ( Q , v ) \begin{array}{l}
\hline
\textbf{算法:BFS}(G,s) \\[4pt]
\hline
\textbf{for}\ v\in V\ \textbf{do}\ dist[v]=\infty,\ prev[v]=\text{nil} \\
dist[s]=0,\ Q=[s] \\
\textbf{while}\ Q\ne[\ ]\ \textbf{do} \\
\qquad u=\text{EJECT}(Q) \\
\qquad\textbf{for}\ v\in\operatorname{Adj}(u)\ \textbf{do} \\
\qquad\qquad\textbf{if}\ dist[v]=\infty\ \textbf{then} \\
\qquad\qquad\qquad dist[v]=dist[u]+1,\ prev[v]=u \\
\qquad\qquad\qquad\text{INJECT}(Q,v) \\
\hline
\end{array}
算法: BFS ( G , s ) for v ∈ V do d i s t [ v ] = ∞ , p re v [ v ] = nil d i s t [ s ] = 0 , Q = [ s ] while Q = [ ] do u = EJECT ( Q ) for v ∈ Adj ( u ) do if d i s t [ v ] = ∞ then d i s t [ v ] = d i s t [ u ] + 1 , p re v [ v ] = u INJECT ( Q , v )
在入队时立即设置距离,保证同一个顶点不会被重复入队。prev 记录首次发现它的前驱;从目标不断追溯 prev 到 s s s
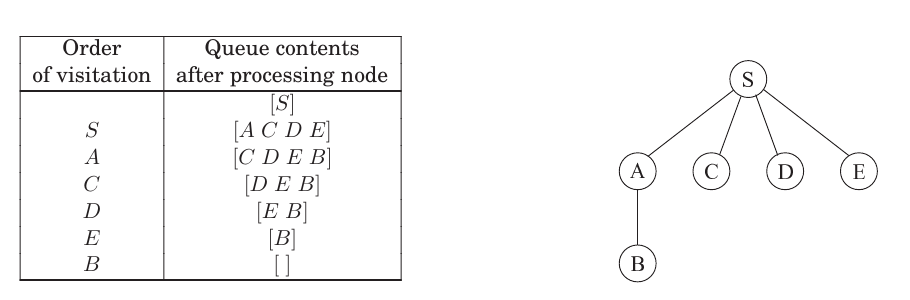
课件例子从 S S S A , C , D , E A,C,D,E A , C , D , E A A A B B B
已处理顶点
处理后的队列
尚未开始
[ S ] [S] [ S ]
S S S [ A , C , D , E ] [A,C,D,E] [ A , C , D , E ]
A A A [ C , D , E , B ] [C,D,E,B] [ C , D , E , B ]
C C C [ D , E , B ] [D,E,B] [ D , E , B ]
D D D [ E , B ] [E,B] [ E , B ]
E E E [ B ] [B] [ B ]
B B B [ ] [\ ] [ ]
分层不变量 :开始处理距离 d d d d d d ∞ \infty ∞ d d d
处理这一层时,尚未发现的邻居距离至多为 d + 1 d+1 d + 1 d + 1 d+1 d + 1 d d d d + 1 d+1 d + 1
每个顶点最多入队、出队一次,每条邻接边扫描一次,因此 BFS 的时间与 DFS 相同,都是 O ( n + m ) O(n+m) O ( n + m ) O ( n ) O(n) O ( n )
练习 3.7:若图 G = ( V , E ) G=(V,E) G = ( V , E ) V 1 , V 2 V_1,V_2 V 1 , V 2 V = V 1 ∪ V 2 V=V_1\cup V_2 V = V 1 ∪ V 2
本题考查 BFS 遍历所有连通分量、二染色与奇环的等价关系。
(a) 给出线性时间算法,判断一个无向图是否为二部图。
将所有顶点的颜色初始化为“未染色”。对每个尚未染色的顶点 s s s c ( s ) = 0 c(s)=0 c ( s ) = 0 s s s { u , v } \{u,v\} { u , v } v v v c ( v ) = 1 − c ( u ) c(v)=1-c(u) c ( v ) = 1 − c ( u ) c ( v ) = c ( u ) c(v)=c(u) c ( v ) = c ( u )
V 0 = { v : c ( v ) = 0 } , V 1 = { v : c ( v ) = 1 } . V_0=\{v:c(v)=0\},\qquad V_1=\{v:c(v)=1\}.
V 0 = { v : c ( v ) = 0 } , V 1 = { v : c ( v ) = 1 } .
伪代码使用 − 1 -1 − 1 O ( 1 ) O(1) O ( 1 )
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 检查所有连通分量;成功时返回二部划分,失败时返回 FALSE。 function BIPARTITE(G = (V, E)): for each v in V: c[v] ← -1 for each s in V: if c[s] ≠ -1: continue c[s] ← 0 Q ← 空队列 ENQUEUE(Q, s) while Q is not empty: u ← DEQUEUE(Q) for each v in Adj(u): if c[v] = -1: c[v] ← 1 - c[u] ENQUEUE(Q, v) else if c[v] = c[u]: return FALSE V0 ← {v ∈ V : c[v] = 0} V1 ← {v ∈ V : c[v] = 1} return (TRUE, V0, V1)
若算法返回成功,每条边的端点颜色不同,所以 ( V 0 , V 1 ) (V_0,V_1) ( V 0 , V 1 )
使用邻接表时,每个顶点入队一次,每条无向边扫描两次,因此时间为 O ( ∣ V ∣ + ∣ E ∣ ) O(|V|+|E|) O ( ∣ V ∣ + ∣ E ∣ ) O ( ∣ V ∣ ) O(|V|) O ( ∣ V ∣ )
(b) 无向图为二部图,当且仅当它可以只用两种颜色对顶点合法染色。证明另一等价表述:无向图为二部图,当且仅当它不含奇数长度的环。
若图为二部图,沿环每走一条边都切换一次集合。回到起点必须切换偶数次,因此所有环的长度都是偶数。
反过来,设图没有奇环。在每个连通分量中选根构造 BFS 树,令
c ( v ) = d ( v ) m o d 2 , c(v)=d(v)\bmod2,
c ( v ) = d ( v ) mod 2 ,
其中 d ( v ) d(v) d ( v ) v v v { u , v } \{u,v\} { u , v } w w w u u u v v v
d ( u ) + d ( v ) − 2 d ( w ) , d(u)+d(v)-2d(w),
d ( u ) + d ( v ) − 2 d ( w ) ,
它是偶数。这条树路径加上边 { u , v } \{u,v\} { u , v }
© 一个恰好只有一个奇环的无向图,至多需要多少种颜色才能合法染色?
恰好需要 3 3 3 v v v G − v G-v G − v v v v
χ ( G ) = 3. \chi(G)=3.
χ ( G ) = 3.
加权距离
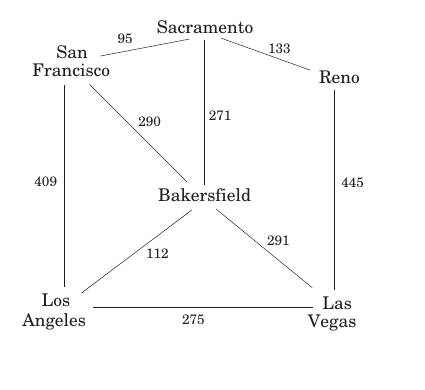
加权图为每条边指定长度 ℓ ( u , v ) \ell(u,v) ℓ ( u , v ) 409 409 409 290 + 112 = 402 290+112=402 290 + 112 = 402 402 402 402
课件提问:边长为正整数时,能否把 BFS 改用于加权图?
可以把长度为 ℓ e \ell_e ℓ e ℓ e \ell_e ℓ e ℓ e − 1 \ell_e-1 ℓ e − 1 O ( n + ∑ e ℓ e ) O(n+\sum_e\ell_e) O ( n + ∑ e ℓ e )
课件接着用闹钟 解释如何跳过这些虚拟顶点:为源点在时刻 0 设闹钟;取下一次响铃的顶点 u u u T T T u → v u\to v u → v v v v T + ℓ ( u , v ) T+\ell(u,v) T + ℓ ( u , v )
松弛操作
所有后续算法都使用同一种松弛 操作:
d i s t [ v ] ← min { d i s t [ v ] , d i s t [ u ] + ℓ ( u , v ) } . dist[v]\leftarrow\min\{dist[v],dist[u]+\ell(u,v)\}.
d i s t [ v ] ← min { d i s t [ v ] , d i s t [ u ] + ℓ ( u , v )} .
若候选值更小,同时令 prev[v]=u。初始化 dist[s]=0、其他距离为 ∞ \infty ∞ dist[u] 有限时沿 u → v u\to v u → v
距离的有限候选值总对应一条从 s s s u u u u → v u\to v u → v v v v
设一条最短路依次经过 s , u 1 , … , u k , t s,u_1,\ldots,u_k,t s , u 1 , … , u k , t t t t
Dijkstra
Dijkstra 算法 每次取暂定距离最小的未确定顶点,把它的距离确定下来,再松弛其出边。课件假设边权为正;同样的算法与证明也适用于零权边,只需全部边权非负。
算法:DIJKSTRA ( G , ℓ , s ) 输入: ℓ ( e ) ≥ 0 ,使用邻接表 for v ∈ V do d i s t [ v ] = ∞ , p r e v [ v ] = nil d i s t [ s ] = 0 H = MAKEQUEUE ( V , d i s t ) while H ≠ ∅ do u = DELETEMIN ( H ) if d i s t [ u ] = ∞ then break for ( u , v ) ∈ E 的出边 do if v ∈ H 且 d i s t [ v ] > d i s t [ u ] + ℓ ( u , v ) then d i s t [ v ] = d i s t [ u ] + ℓ ( u , v ) , p r e v [ v ] = u DECREASEKEY ( H , v ) \begin{array}{l}
\hline
\textbf{算法:DIJKSTRA}(G,\ell,s) \\[4pt]
\hline
\textbf{输入:}\ \ell(e)\ge0\text{,使用邻接表} \\
\textbf{for}\ v\in V\ \textbf{do}\ dist[v]=\infty,\ prev[v]=\text{nil} \\
dist[s]=0 \\
H=\text{MAKEQUEUE}(V,dist) \\
\textbf{while}\ H\ne\varnothing\ \textbf{do} \\
\qquad u=\text{DELETEMIN}(H) \\
\qquad\textbf{if}\ dist[u]=\infty\ \textbf{then}\ \text{break} \\
\qquad\textbf{for}\ (u,v)\in E\text{ 的出边}\ \textbf{do} \\
\qquad\qquad\textbf{if}\ v\in H\ \text{且}\ dist[v]>dist[u]+\ell(u,v)\ \textbf{then} \\
\qquad\qquad\qquad dist[v]=dist[u]+\ell(u,v),\ prev[v]=u \\
\qquad\qquad\qquad\text{DECREASEKEY}(H,v) \\
\hline
\end{array}
算法: DIJKSTRA ( G , ℓ , s ) 输入: ℓ ( e ) ≥ 0 ,使用邻接表 for v ∈ V do d i s t [ v ] = ∞ , p re v [ v ] = nil d i s t [ s ] = 0 H = MAKEQUEUE ( V , d i s t ) while H = ∅ do u = DELETEMIN ( H ) if d i s t [ u ] = ∞ then break for ( u , v ) ∈ E 的出边 do if v ∈ H 且 d i s t [ v ] > d i s t [ u ] + ℓ ( u , v ) then d i s t [ v ] = d i s t [ u ] + ℓ ( u , v ) , p re v [ v ] = u DECREASEKEY ( H , v )
从堆中取出的顶点即距离已确定的顶点。非负边保证后面不会得到更短的路线,因此无需重新放回堆;若最小键已经是 ∞ \infty ∞
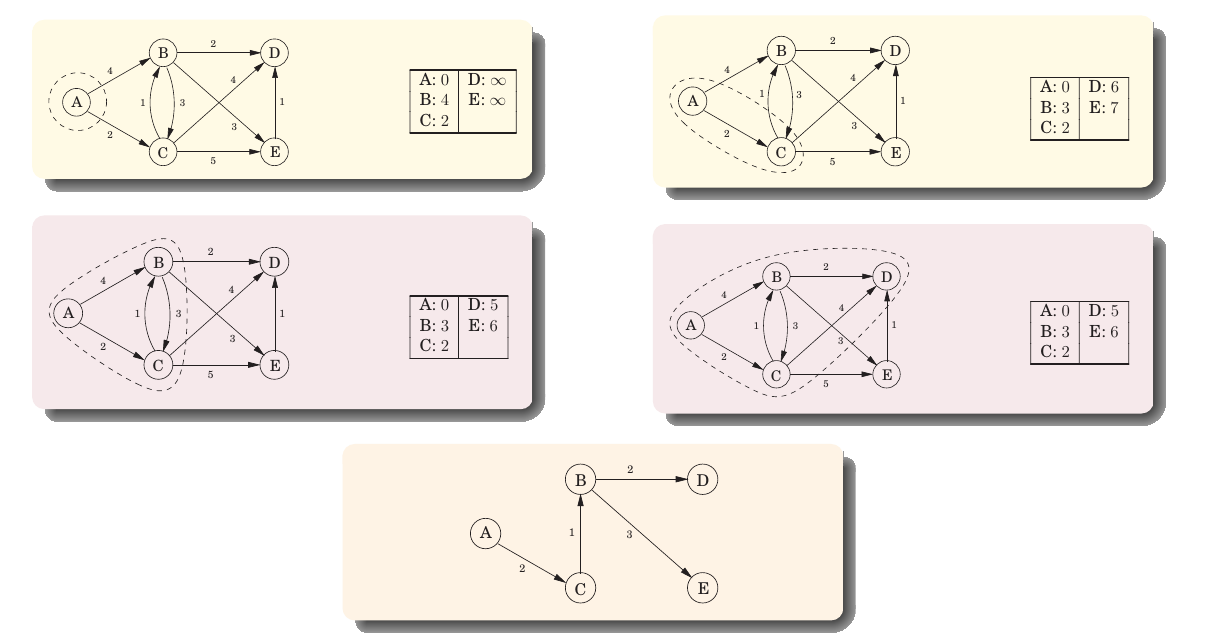
课件例子以 A A A A → B : 4 A\to B:4 A → B : 4 A → C : 2 A\to C:2 A → C : 2 C → B : 1 C\to B:1 C → B : 1 B → C : 3 B\to C:3 B → C : 3 B → D : 2 B\to D:2 B → D : 2 C → D : 4 C\to D:4 C → D : 4 B → E : 3 B\to E:3 B → E : 3 C → E : 5 C\to E:5 C → E : 5 E → D : 1 E\to D:1 E → D : 1
已处理顶点
A A A B B B C C C D D D E E E
初始化
0
∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞
A A A 0
4
2
∞ \infty ∞ ∞ \infty ∞
C C C 0
3
2
6
7
B B B 0
3
2
5
6
D D D 0
3
2
5
6
E E E 0
3
2
5
6
最终距离为 A : 0 , B : 3 , C : 2 , D : 5 , E : 6 A:0,B:3,C:2,D:5,E:6 A : 0 , B : 3 , C : 2 , D : 5 , E : 6 A → C A\to C A → C C → B C\to B C → B B → D B\to D B → D B → E B\to E B → E D D D 2 + 1 + 2 = 5 2+1+2=5 2 + 1 + 2 = 5
正确性证明 对已确定集合 S S S u u u s → u s\to u s → u S S S x → y x\to y x → y x x x y y y y y y δ ( s , u ) \delta(s,u) δ ( s , u ) u u u d i s t [ u ] ≤ d i s t [ y ] dist[u]\le dist[y] d i s t [ u ] ≤ d i s t [ y ] d i s t [ u ] ≤ δ ( s , u ) dist[u]\le\delta(s,u) d i s t [ u ] ≤ δ ( s , u ) d i s t [ u ] ≥ δ ( s , u ) dist[u]\ge\delta(s,u) d i s t [ u ] ≥ δ ( s , u )
练习 4.11:给定边长均为正的有向图,设计算法返回图中最短环的长度;若图无环,应报告无环。时间复杂度至多为 O ( ∣ V ∣ 3 ) O(|V|^3) O ( ∣ V ∣ 3 )
本题考查正权最短路径、以一条边闭合路径得到环,以及多次 Dijkstra 的复杂度分析。
记 n = ∣ V ∣ n=|V| n = ∣ V ∣ m = ∣ E ∣ m=|E| m = ∣ E ∣ s s s d s [ u ] = δ ( s , u ) d_s[u]=\delta(s,u) d s [ u ] = δ ( s , u ) s s s ( u , s ) (u,s) ( u , s ) s → u s\to u s → u
L = min ( u , s ) ∈ E ( d s [ u ] + ℓ ( u , s ) ) . L=\min_{(u,s)\in E}\bigl(d_s[u]+\ell(u,s)\bigr).
L = ( u , s ) ∈ E min ( d s [ u ] + ℓ ( u , s ) ) .
若没有有限候选值,则图无环。以下使用无序数组选取最小距离顶点,使一次 Dijkstra 的时间为 O ( n 2 + m ) O(n^2+m) O ( n 2 + m ) ( v , f ) (v,f) ( v , f ) v v v f f f
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
// 正权图上的数组版 Dijkstra;skip = NONE 表示不跳过任何边。 function DIJKSTRA-ARRAY(G = (V, E), ell, s, skip): for each v in V: dist[v] ← +∞ fixed[v] ← FALSE dist[s] ← 0 for step ← 1 to |V|: u ← 未固定顶点中 dist 最小者 if dist[u] = +∞: break fixed[u] ← TRUE for each (v, f) in Adj(u): if f = skip: continue if fixed[v] = FALSE and dist[v] > dist[u] + ell[f]: dist[v] ← dist[u] + ell[f] return dist // 枚举环的闭合边;incoming[s] 保存所有进入 s 的边。 function SHORTEST-DIRECTED-CYCLE(G = (V, E), ell): for each s in V: incoming[s] ← 空列表 for each edge f = (u, v) in E: APPEND(incoming[v], (u, f)) answer ← +∞ for each s in V: dist ← DIJKSTRA-ARRAY(G, ell, s, NONE) for each (u, f) in incoming[s]: answer ← min(answer, dist[u] + ell[f]) if answer = +∞: return ACYCLIC return answer
设最短环长为 O P T \mathrm{OPT} OPT d s [ u ] < ∞ d_s[u]<\infty d s [ u ] < ∞ ( u , s ) (u,s) ( u , s ) s → u s\to u s → u
d s [ u ] + ℓ ( u , s ) ≥ O P T , L ≥ O P T . d_s[u]+\ell(u,s)\ge\mathrm{OPT},
\qquad L\ge\mathrm{OPT}.
d s [ u ] + ℓ ( u , s ) ≥ OPT , L ≥ OPT .
反过来,取任意最短环 C C C ( u , s ) (u,s) ( u , s ) s → u s\to u s → u
d s [ u ] ≤ ℓ ( C ) − ℓ ( u , s ) , L ≤ d s [ u ] + ℓ ( u , s ) ≤ ℓ ( C ) = O P T . d_s[u]\le\ell(C)-\ell(u,s),
\qquad
L\le d_s[u]+\ell(u,s)\le\ell(C)=\mathrm{OPT}.
d s [ u ] ≤ ℓ ( C ) − ℓ ( u , s ) , L ≤ d s [ u ] + ℓ ( u , s ) ≤ ℓ ( C ) = OPT .
因此 L = O P T L=\mathrm{OPT} L = OPT
按教材的简单图模型,m = O ( n 2 ) m=O(n^2) m = O ( n 2 ) O ( n + m ) O(n+m) O ( n + m ) n n n
T ( n , m ) = O ( n ( n 2 + m ) + m + n ) = O ( n 3 ) . T(n,m)=O\bigl(n(n^2+m)+m+n\bigr)=O(n^3).
T ( n , m ) = O ( n ( n 2 + m ) + m + n ) = O ( n 3 ) .
辅助空间为 O ( n + m ) O(n+m) O ( n + m )
练习 4.12:对下列问题设计 O ( ∣ V ∣ 2 ) O(|V|^2) O ( ∣ V ∣ 2 )
输入:无向图 G = ( V , E ) G=(V,E) G = ( V , E ) ℓ e > 0 \ell_e>0 ℓ e > 0 e ∈ E e\in E e ∈ E
输出:包含边 e e e
本题考查删边后的最短路径与包含指定边的最短环之间的对应关系;它是练习 3.11 的加权版本。
设 e = { s , t } e=\{s,t\} e = { s , t } e e e
d = δ G − e ( s , t ) . d=\delta_{G-e}(s,t).
d = δ G − e ( s , t ) .
若 d = ∞ d=\infty d = ∞ e e e d + ℓ e d+\ell_e d + ℓ e
1
2
3
4
5
6
// 跳过指定的无向边,再用该边闭合最短路径。 function SHORTEST-CYCLE-THROUGH-EDGE(G, ell, e = {s, t}): dist ← DIJKSTRA-ARRAY(G, ell, s, e) if dist[t] = +∞: return NO-CYCLE return dist[t] + ell[e]
记 C e \mathcal C_e C e e e e P s , t ( G − e ) \mathcal P_{s,t}(G-e) P s , t ( G − e ) s → t s\to t s → t e e e
C ∈ C e ⟷ C − e ∈ P s , t ( G − e ) . C\in\mathcal C_e
\longleftrightarrow
C-e\in\mathcal P_{s,t}(G-e).
C ∈ C e ⟷ C − e ∈ P s , t ( G − e ) .
因此,当两集合非空时,
min C ∈ C e ℓ ( C ) = ℓ e + min P ∈ P s , t ( G − e ) ℓ ( P ) = ℓ e + δ G − e ( s , t ) . \min_{C\in\mathcal C_e}\ell(C)
=
\ell_e+\min_{P\in\mathcal P_{s,t}(G-e)}\ell(P)
=
\ell_e+\delta_{G-e}(s,t).
C ∈ C e min ℓ ( C ) = ℓ e + P ∈ P s , t ( G − e ) min ℓ ( P ) = ℓ e + δ G − e ( s , t ) .
两集合也同时为空,故算法的 NO-CYCLE 分支正确。数组版 Dijkstra 的时间为
O ( n 2 + m ) = O ( n 2 ) , O(n^2+m)=O(n^2),
O ( n 2 + m ) = O ( n 2 ) ,
辅助空间为 O ( n ) O(n) O ( n )
优先队列
课件的闹钟操作由优先队列 实现:INSERT 插入元素;DECREASEKEY 降低键值;DELETEMIN 取出并删除最小键元素;MAKEQUEUE 从给定键值构建队列。实现 DECREASEKEY 时,通常还需要保存顶点在堆中的位置。
Dijkstra 至多执行 n n n m m m O ( m ) O(m) O ( m )
实现
删除最小值
插入或降键
总时间
无序数组
O ( n ) O(n) O ( n ) O ( 1 ) O(1) O ( 1 ) O ( n 2 + m ) O(n^2+m) O ( n 2 + m )
二叉堆
O ( log n ) O(\log n) O ( log n ) O ( log n ) O(\log n) O ( log n ) O ( ( n + m ) log n ) O((n+m)\log n) O (( n + m ) log n )
d d d O ( d log d n ) O(d\log_d n) O ( d log d n ) O ( log d n ) O(\log_d n) O ( log d n ) O ( ( d n + m ) log d n ) O((dn+m)\log_d n) O (( d n + m ) log d n )
Fibonacci 堆
均摊 O ( log n ) O(\log n) O ( log n )
均摊 O ( 1 ) O(1) O ( 1 )
O ( n log n + m ) O(n\log n+m) O ( n log n + m )
普通简单图有 m = O ( n 2 ) m=O(n^2) m = O ( n 2 ) O ( n 2 ) O(n^2) O ( n 2 ) O ( n ) O(n) O ( n ) O ( n log n ) O(n\log n) O ( n log n )
课件提问:数组和二叉堆哪个更好?
稠密图 m = Θ ( n 2 ) m=\Theta(n^2) m = Θ ( n 2 ) O ( n 2 ) O(n^2) O ( n 2 ) n 2 / log n n^2/\log n n 2 / log n d d d d d d m / n m/n m / n d ≥ 2 d\ge2 d ≥ 2
练习 4.16:将含 n n n 1 , 2 , … , n 1,2,\ldots,n 1 , 2 , … , n
本题考查完全树的数组编号、自底向上建堆的总代价分析,以及 d 叉堆的上浮、下沉和逆映射维护。
(a) 证明:位置 j j j ⌊ j / 2 ⌋ \lfloor j/2\rfloor ⌊ j /2 ⌋ 2 j 2j 2 j 2 j + 1 2j+1 2 j + 1 n n n
按层序从左到右编号,根为 1 1 1
j = ( 1 b 1 b 2 ⋯ b h ) 2 . j=(1b_1b_2\cdots b_h)_2.
j = ( 1 b 1 b 2 ⋯ b h ) 2 .
从根向左走在编号末尾追加 0 0 0 1 1 1
( j 0 ) 2 = 2 j , ( j 1 ) 2 = 2 j + 1. (j0)_2=2j,\qquad (j1)_2=2j+1.
( j 0 ) 2 = 2 j , ( j 1 ) 2 = 2 j + 1.
对 j > 1 j>1 j > 1 ⌊ j / 2 ⌋ \lfloor j/2\rfloor ⌊ j /2 ⌋ n n n
(b) 完全 d d d
设 d ≥ 2 d\ge2 d ≥ 2 0 0 0 j − 1 j-1 j − 1 d ( j − 1 ) + 1 , … , d ( j − 1 ) + d d(j-1)+1,\ldots,d(j-1)+d d ( j − 1 ) + 1 , … , d ( j − 1 ) + d 1 1 1
children ( j ) = { d ( j − 1 ) + 2 , … , d ( j − 1 ) + d + 1 } ∩ { 1 , … , n } . \operatorname{children}(j)
=
\{d(j-1)+2,\ldots,d(j-1)+d+1\}\cap\{1,\ldots,n\}.
children ( j ) = { d ( j − 1 ) + 2 , … , d ( j − 1 ) + d + 1 } ∩ { 1 , … , n } .
因此,对 j > 1 j>1 j > 1
parent ( j ) = ⌊ j − 2 d ⌋ + 1. \operatorname{parent}(j)
=
\left\lfloor\frac{j-2}{d}\right\rfloor+1.
parent ( j ) = ⌊ d j − 2 ⌋ + 1.
取 d = 2 d=2 d = 2
教材图 4.16 给出了参考塔扬相关著作编写的二叉堆伪代码。堆以数组 h h h ∣ h ∣ |h| ∣ h ∣ h − 1 h^{-1} h − 1
© 证明:对 n n n O ( n ) O(n) O ( n ) ∑ i = 1 n log ( n / i ) \sum_{i=1}^{n}\log(n/i) ∑ i = 1 n log ( n / i )
建堆先按输入顺序填入数组,再从最后一个结点向根逐个下沉。记 pos 为逆映射 h − 1 h^{-1} h − 1 d = 2 d=2 d = 2
1
2
3
4
5
6
7
8
// 自底向上建堆;每个元素有独立标识,key(x) 表示其优先级。 function MAKEHEAP(S, d = 2): h ← 按输入顺序存放 S 的数组 for i ← 1 to |h|: pos[h[i]] ← i for i ← |h| downto 1: SIFT-DOWN(h, pos, h[i], i, d) return (h, pos)
处理位置 i i i i i i i i i
在二叉堆中,位置 i i i
H i ≤ ⌊ log 2 n i ⌋ , H_i\le\left\lfloor\log_2\frac ni\right\rfloor,
H i ≤ ⌊ log 2 i n ⌋ ,
因为距离 h h h 2 h i 2^hi 2 h i 2 h i ≤ n 2^hi\le n 2 h i ≤ n O ( 1 + H i ) O(1+H_i) O ( 1 + H i )
T ( n ) = O ( n + ∑ i = 1 n ⌊ log 2 n i ⌋ ) = O ( n + ∑ h = 1 ⌊ log 2 n ⌋ ⌊ n 2 h ⌋ ) = O ( n ) . \begin{aligned}
T(n)
&=O\!\left(n+\sum_{i=1}^{n}
\left\lfloor\log_2\frac ni\right\rfloor\right)\\
&=O\!\left(n+\sum_{h=1}^{\lfloor\log_2n\rfloor}
\left\lfloor\frac n{2^h}\right\rfloor\right)
=O(n).
\end{aligned}
T ( n ) = O ( n + i = 1 ∑ n ⌊ log 2 i n ⌋ ) = O n + h = 1 ∑ ⌊ l o g 2 n ⌋ ⌊ 2 h n ⌋ = O ( n ) .
初始读入和建表需要 Ω ( n ) \Omega(n) Ω ( n ) Θ ( n ) \Theta(n) Θ ( n )
一种最坏量级输入是按层序严格递减的键序列 n , n − 1 , … , 1 n,n-1,\ldots,1 n , n − 1 , … , 1 n = 2 h + 1 − 1 n=2^{h+1}-1 n = 2 h + 1 − 1 n n n Θ ( n ) \Theta(n) Θ ( n )
(d) 要把这些二叉堆伪代码改成 d d d
教材最后一小问重复标为 (a),此处按 (d) 处理。使用 (b) 的父子编号,并让 MIN-CHILD 扫描至多 d d d h − 1 h^{-1} h − 1
图 4.16 的 bubbleup 将父下标误写为 ⌈ i / 2 ⌉ \lceil i/2\rceil ⌈ i /2 ⌉ 1 1 1 ⌊ i / 2 ⌋ \lfloor i/2\rfloor ⌊ i /2 ⌋ ⌊ ( i − 2 ) / d ⌋ + 1 \lfloor(i-2)/d\rfloor+1 ⌊( i − 2 ) / d ⌋ + 1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
// 返回最小键孩子的下标;叶子返回 0。 function MIN-CHILD(h, i, d): left ← d × (i - 1) + 2 if left > |h|: return 0 right ← min(|h|, left + d - 1) c ← left for j ← left + 1 to right: if key(h[j]) < key(h[c]): c ← j return c // 将 x 放入位置 i,并沿父结点上浮,维护逆映射。 procedure BUBBLE-UP(h, pos, x, i, d): while i > 1: p ← floor((i - 2) / d) + 1 if key(h[p]) ≤ key(x): break h[i] ← h[p] pos[h[i]] ← i i ← p h[i] ← x pos[x] ← i // 孩子子树已是堆;沿最小键孩子下沉,再放置 x。 procedure SIFT-DOWN(h, pos, x, i, d): c ← MIN-CHILD(h, i, d) while c ≠ 0 and key(h[c]) < key(x): h[i] ← h[c] pos[h[i]] ← i i ← c c ← MIN-CHILD(h, i, d) h[i] ← x pos[x] ← i // 弹出末元素使数组长度先减一,再将它放到根部下沉。 function DELETE-MIN(h, pos, d): if |h| = 0: return NIL result ← h[1] x ← REMOVE-LAST(h) pos[result] ← NIL if |h| > 0: SIFT-DOWN(h, pos, x, 1, d) return result
写入 h [ ∣ h ∣ + 1 ] h[|h|+1] h [ ∣ h ∣ + 1 ] d d d
INSERT ( h , x ) : BUBBLE-UP ( h , p o s , x , ∣ h ∣ + 1 , d ) , \operatorname{INSERT}(h,x):
\quad\operatorname{BUBBLE\text{-}UP}(h,\mathrm{pos},x,|h|+1,d),
INSERT ( h , x ) : BUBBLE - UP ( h , pos , x , ∣ h ∣ + 1 , d ) ,
DECREASEKEY ( h , x ) : BUBBLE-UP ( h , p o s , x , p o s [ x ] , d ) , \operatorname{DECREASEKEY}(h,x):
\quad\operatorname{BUBBLE\text{-}UP}(h,\mathrm{pos},x,\mathrm{pos}[x],d),
DECREASEKEY ( h , x ) : BUBBLE - UP ( h , pos , x , pos [ x ] , d ) ,
其中 DECREASEKEY 在降低 key( x ) (x) ( x ) d d d O ( log d n ) O(\log_d n) O ( log d n ) O ( d log d n ) O(d\log_d n) O ( d log d n ) d d d O ( n ) O(n) O ( n )
负权最短路
负权边使 Dijkstra 的确定步骤失效。例如 s → a s\to a s → a s → b s\to b s → b b → a b\to a b → a − 4 -4 − 4 a a a s → b → a s\to b\to a s → b → a
课件提问:允许负权边后需要改变什么?
松弛操作仍然安全,但不能再把“当前最小的暂定距离”视为最终值。需要安排多轮更新,使每条最短路径的边最终按正确的先后顺序完成松弛。
在没有相关负环的情况下,可以选取一条简单最短路:若路线重复某个顶点,就包含一个环;删去权重非负的环不会增大长度。简单路径最多有 n − 1 n-1 n − 1 n − 1 n-1 n − 1 Bellman-Ford 算法 。
算法:BELLMAN-FORD ( G , ℓ , s ) for v ∈ V do d i s t [ v ] = ∞ , p r e v [ v ] = nil d i s t [ s ] = 0 repeat n − 1 times : for ( u , v ) ∈ E do if d i s t [ u ] < ∞ 且 d i s t [ v ] > d i s t [ u ] + ℓ ( u , v ) then d i s t [ v ] = d i s t [ u ] + ℓ ( u , v ) , p r e v [ v ] = u \begin{array}{l}
\hline
\textbf{算法:BELLMAN-FORD}(G,\ell,s) \\[4pt]
\hline
\textbf{for}\ v\in V\ \textbf{do}\ dist[v]=\infty,\ prev[v]=\text{nil} \\
dist[s]=0 \\
\textbf{repeat}\ n-1\ \textbf{times}: \\
\qquad\textbf{for}\ (u,v)\in E\ \textbf{do} \\
\qquad\qquad\textbf{if}\ dist[u]<\infty\ \text{且}\ dist[v]>dist[u]+\ell(u,v)\ \textbf{then} \\
\qquad\qquad\qquad dist[v]=dist[u]+\ell(u,v),\ prev[v]=u \\
\hline
\end{array}
算法: BELLMAN-FORD ( G , ℓ , s ) for v ∈ V do d i s t [ v ] = ∞ , p re v [ v ] = nil d i s t [ s ] = 0 repeat n − 1 times : for ( u , v ) ∈ E do if d i s t [ u ] < ∞ 且 d i s t [ v ] > d i s t [ u ] + ℓ ( u , v ) then d i s t [ v ] = d i s t [ u ] + ℓ ( u , v ) , p re v [ v ] = u
可用归纳证明:第 k k k k k k n − 1 n-1 n − 1 O ( n m ) O(nm) O ( nm )
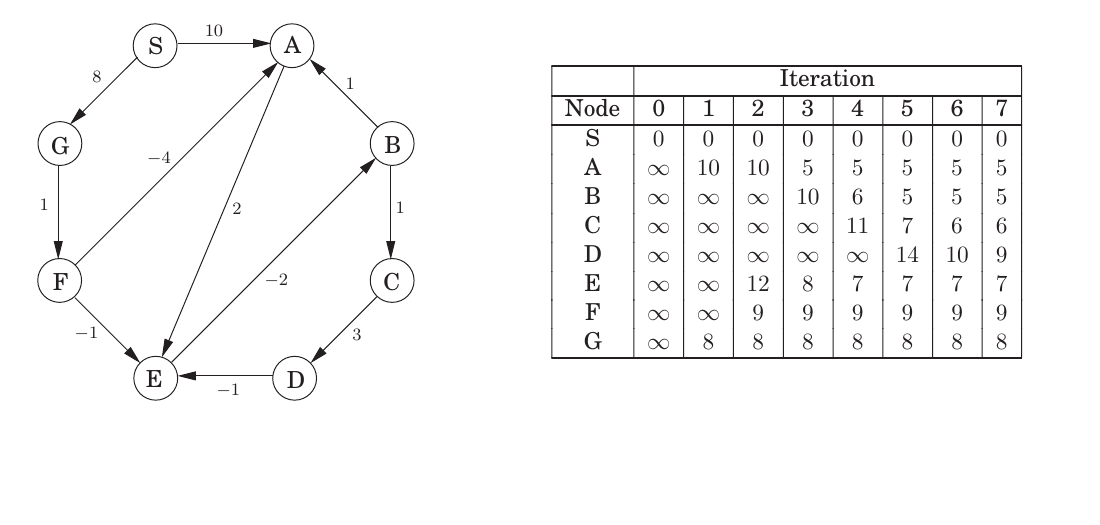
课件从 S S S
顶点
0
1
2
3
4
5
6
7
S S S 0
0
0
0
0
0
0
0
A A A ∞ \infty ∞ 10
10
5
5
5
5
5
B B B ∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞ 10
6
5
5
5
C C C ∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞ 11
7
6
6
D D D ∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞ ∞ \infty ∞ 14
10
9
E E E ∞ \infty ∞ ∞ \infty ∞ 12
8
7
7
7
7
F F F ∞ \infty ∞ ∞ \infty ∞ 9
9
9
9
9
9
G G G ∞ \infty ∞ 8
8
8
8
8
8
8
这个表格可以按“第 k k k k k k n − 1 n-1 n − 1
例如 S → G → F → A S\to G\to F\to A S → G → F → A 8 + 1 − 4 = 5 8+1-4=5 8 + 1 − 4 = 5 A A A D D D S → G → F → A → E → B → C → D S\to G\to F\to A\to E\to B\to C\to D S → G → F → A → E → B → C → D 8 + 1 − 4 + 2 − 2 + 1 + 3 = 9 8+1-4+2-2+1+3=9 8 + 1 − 4 + 2 − 2 + 1 + 3 = 9 D = 9 D=9 D = 9
负环检测
负环 是总权重小于 0 的环。若从 s s s v v v v v v − ∞ -\infty − ∞
课件提问:如何检测负环?
Bellman-Ford 做完 n − 1 n-1 n − 1 s s s
没有可达负环时,一条有限最短路最多需要 n − 1 n-1 n − 1 d i s t [ v ] ≤ d i s t [ u ] + ℓ ( u , v ) dist[v]\le dist[u]+\ell(u,v) d i s t [ v ] ≤ d i s t [ u ] + ℓ ( u , v )
若还要找出距离为 − ∞ -\infty − ∞
DAG 路径
非负权图不会含负环,DAG 则不含任何环,所以边权可以任意正负。对 DAG,拓扑序已经保证每条路径的顶点依次出现;只需按拓扑序处理顶点,并松弛它的出边,便能在线性时间求出最短路。
算法:DAG-SHORTEST-PATHS ( G , ℓ , s ) L = TOPOLOGICAL-SORT ( G ) for v ∈ V do d i s t [ v ] = ∞ , p r e v [ v ] = nil d i s t [ s ] = 0 for u ∈ L do if d i s t [ u ] < ∞ then for ( u , v ) ∈ E 的出边 do 松弛 ( u , v ) \begin{array}{l}
\hline
\textbf{算法:DAG-SHORTEST-PATHS}(G,\ell,s) \\[4pt]
\hline
L=\text{TOPOLOGICAL-SORT}(G) \\
\textbf{for}\ v\in V\ \textbf{do}\ dist[v]=\infty,\ prev[v]=\text{nil} \\
dist[s]=0 \\
\textbf{for}\ u\in L\ \textbf{do} \\
\qquad\textbf{if}\ dist[u]<\infty\ \textbf{then} \\
\qquad\qquad\textbf{for}\ (u,v)\in E\text{ 的出边}\ \textbf{do} \\
\qquad\qquad\qquad\text{松弛 }(u,v) \\
\hline
\end{array}
算法: DAG-SHORTEST-PATHS ( G , ℓ , s ) L = TOPOLOGICAL-SORT ( G ) for v ∈ V do d i s t [ v ] = ∞ , p re v [ v ] = nil d i s t [ s ] = 0 for u ∈ L do if d i s t [ u ] < ∞ then for ( u , v ) ∈ E 的出边 do 松弛 ( u , v )
处理 u u u u u u O ( n + m ) O(n+m) O ( n + m ) e ∈ E e\in E e ∈ E O ( n m ) O(nm) O ( nm ) u u u
DAG 中也能求最长路径 :把全部边权取负,再求最短路,最后将距离取负即可。直接实现时把未到达值初始化为 − ∞ -\infty − ∞
思考:一般有向图中,所有边权为正,能否高效求最长简单路径?
不能从 DAG 的线性算法直接推广。要求路径不重复顶点后,问题是 NP 困难的:把每条边权都设为 1,若能判定最长简单路径是否有 n − 1 n-1 n − 1
路径练习
练习:给每条边权加同一个大常数,使负权变成正权,再用 Dijkstra,能否求出原图最短路?
不能。路径 P P P
反例:s → t s\to t s → t s → a s\to a s → a − 2 -2 − 2 a → t a\to t a → t a a a
练习 4.14:强连通有向图的边权均为正,给定顶点 v 0 v_0 v 0 v 0 v_0 v 0
在 G G G v 0 v_0 v 0 d o u t [ t ] = δ ( v 0 , t ) d_{out}[t]=\delta(v_0,t) d o u t [ t ] = δ ( v 0 , t ) G R G^R G R v 0 v_0 v 0 d i n [ s ] = δ ( s , v 0 ) d_{in}[s]=\delta(s,v_0) d in [ s ] = δ ( s , v 0 ) s , t s,t s , t d i n [ s ] + d o u t [ t ] d_{in}[s]+d_{out}[t] d in [ s ] + d o u t [ t ]
任何经过 v 0 v_0 v 0 v 0 v_0 v 0
二叉堆实现的两次搜索共花 O ( ( n + m ) log n ) O((n+m)\log n) O (( n + m ) log n ) n 2 n^2 n 2 O ( n 2 ) O(n^2) O ( n 2 ) O ( 1 ) O(1) O ( 1 )
本题按允许重复顶点的路线理解。强制经过 v 0 v_0 v 0
算法对比
问题
适用条件
时间
可达性、无向连通分量
任意图,按边的方向搜索
O ( n + m ) O(n+m) O ( n + m )
拓扑排序
DAG
O ( n + m ) O(n+m) O ( n + m )
强连通分量
有向图,两遍 DFS
O ( n + m ) O(n+m) O ( n + m )
BFS 最短路
所有边等长或无权
O ( n + m ) O(n+m) O ( n + m )
Dijkstra 最短路
所有边权非负,二叉堆
O ( ( n + m ) log n ) O((n+m)\log n) O (( n + m ) log n )
Bellman-Ford
可有负权;同时检查可达负环
O ( n m ) O(nm) O ( nm )
DAG 最短路或最长路
DAG,边权可正可负
O ( n + m ) O(n+m) O ( n + m )
图的结构与边权条件共同决定算法选择。拓扑序把 DAG 中的依赖一次安排好;非负边让 Dijkstra 的最小候选值可以确定;一般负权图则需要多轮松弛,并检查负环是否影响目标。